









출고예상일 안내
주문하신 상품이 한국에서 현지 배송을 위한 출고단계가 이루어질 것으로 예상되는 날짜입니다. 상품을 준비하는 과정에서 내부적인 사정으로 인해 출고예상일에 다소 오차가 생길 수 있습니다.
여러 상품(예약상품포함)을 함께 주문하신 경우 출고예상일이 가장 늦은 날짜에 맞춰 함께 배송됩니다.


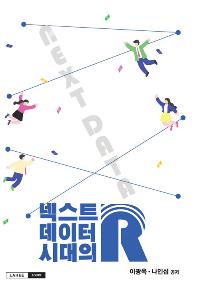





ISBN : 9791199023512 / 273쪽 / 519g / 188 x 257 (㎜)
이 상품에 궁금하신점이 있으세요? 1:1상담문의



아래의 도서와 구매하시면 가격이 .42 원 더 내려갑니다.
-
이기동
-
이동훈 외 공저
-
-
테오도르 W. 아도르노
- 61,200 →61,200원
- 15,000 →15,000원
- 36,000 →36,000원
- 35,100 →35,100원



반디앤루니스 리뷰
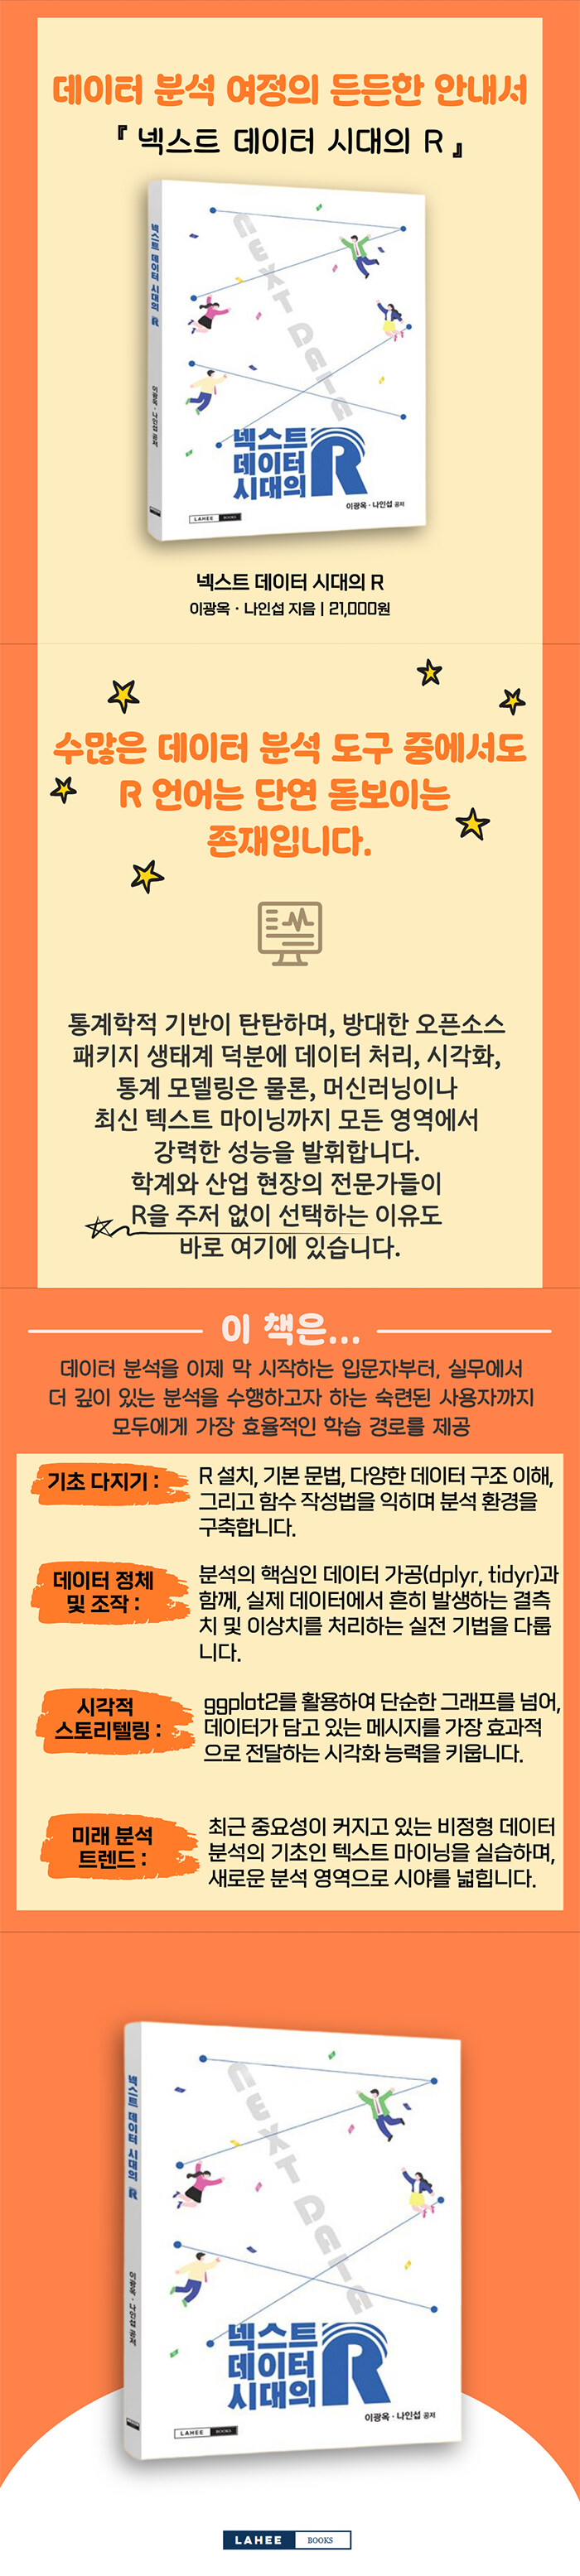
『넥스트 데이터 시대의 R』은 데이터 분석을 이제 막 시작하는 입문자부터, 실무에서 더 깊이 있는 분석을 수행하고자 하는 숙련된 사용자까지 모두에게 가장 효율적인 학습경로를 제공하고자 기획되었습니다. 단순한 문법 나열을 넘어, 실제 데이터 분석가가 현장에서 마주하는 흐름 그대로를 따라가며 R 활용 능력을 체득할 수 있도록 구성했습니다.
출판사 리뷰
『넥스트 데이터 시대의 R』은 데이터 분석을 이제 막 시작하는 입문자부터, 실무에서 더 깊이 있는 분석을 수행하고자 하는 숙련된 사용자까지 모두에게 가장 효율적인 학습 경로를 제공하고자 기획되었습니다. 단순한 문법 나열을 넘어, 실제 데이터 분석가가 현장에서 마주하는 흐름 그대로를 따라가며 R 활용 능력을 체득할 수 있도록 구성했습니다.
이 책은 다음과 같은 핵심 내용을 중심으로 진행됩니다.
∙ 기초 다지기 (Chapter 1~3):R 설치, 기본 문법, 다양한 데이터 구조 이해, 그리고 함수 작성법을 익히며 분석 환경을 구축합니다.
∙ 데이터 정제 및 조작 (Chapter 4~6):분석의 핵심인 데이터 가공(dplyr, tidyr)과 함께, 실제 데이터에서 흔히 발생하는 결측치 및 이상치를 처리하는 실전 기법을 다룹니다.
∙ 시각적 스토리텔링 (Chapter 7):ggplot2를 활용하여 단순한 그래프를 넘어, 데이터가 담고 있는 메시지를 가장 효과적으로 전달하는 시각화 능력을 키웁니다.
∙ 미래 분석 트렌드 (Chapter 8):최근 중요성이 커지고 있는 비정형 데이터 분석의 기초인 텍스트 마이닝을 실습하며, 새로운 분석 영역으로 시야를 넓힙니다.
이 책은 철저히 실습 중심으로 구성되어 있습니다. 독자 여러분이 직접 코드를 입력하고 결과를 확인하는 과정을 통해 R의 원리와 분석 과정을 몸으로 체화할 수 있도록 돕겠습니다.

-
- 저자 : 이광옥, 나인섭

1.1 R 언어:데이터 분석의 핵심 도구 ‣‣‣ 3
1.2 R과 RStudio:효율적인 분석 환경 결합 ‣‣‣ 5
1.3 R과 RStudio 설치 가이드 ‣‣‣ 5
1.4 RStudio 프로젝트 만들기 ‣‣‣ 9
1.5 패키지(Package) 설치 및 관리 ‣‣‣ 15
1.6 간단한 R 코드 실행하기 ‣‣‣ 17
1.7 작업 공간과 프로젝트 관리 ‣‣‣ 21
1.8 대표적인 기본 패키지 소개 ‣‣‣ 22
1.9 R 커뮤니티와 자료 찾기 ‣‣‣ 25
연습문제 ‣‣‣ 27
Chapter 2 데이터
2.1 R의 기본 데이터 구조 ‣‣‣ 33
2.2 데이터프레임 다루기 ‣‣‣ 43
2.3 외부 데이터 불러오기 ‣‣‣ 53
2.4 데이터 저장하기 ‣‣‣ 56
2.5 데이터 구조 변환 ‣‣‣ 57
연습문제 ‣‣‣ 62
Chapter 3 함수
3.1 함수란 무엇인가? ‣‣‣ 67
3.2 기본 내장 함수 활용하기‣‣‣ 70
3.3 사용자 정의 함수 만들기 ‣‣‣ 81
3.4 함수의 변수 범위(스코프) ‣‣‣ 84
3.5 조건문:ifelse() ‣‣‣ 86
3.6 반복문:for() ‣‣‣ 88
연습문제 ‣‣‣ 89
Chapter 4 데이터 분석
4.1 데이터 분석이란? ‣‣‣ 97
4.2 기술 통계 분석 ‣‣‣ 99
4.3 범주형 데이터 분석 ‣‣‣ 104
4.4 수치형 데이터 분석 ‣‣‣ 108
4.5 그룹별 요약 통계 ‣‣‣ 114
4.6 상관 분석 ‣‣‣ 118
4.7 간단한 회귀 분석 ‣‣‣ 122
4.8 분석 결과 해석과 보고 ‣‣‣ 126
연습문제 ‣‣‣ 129
Chapter 5 데이터 가공 및 분석
5.1 데이터 가공의 이해 ‣‣‣ 135
5.2 tidyr을 활용한 데이터 구조 변환 ‣‣‣ 146
5.3 조건에 따른 데이터 처리 ‣‣‣ 152
5.4 문자열 처리 및 변환 ‣‣‣ 158
연습문제 ‣‣‣ 164
Chapter 6 데이터 정제
6.1 데이터 정제의 개념 ‣‣‣ 169
6.2 결측치(Missing Data) 관리 ‣‣‣ 170
6.3 이상치(Outlier) 관리 기법 ‣‣‣ 175
6.4 중복 관측치(Duplicate Data) 제거 ‣‣‣ 179
6.5 자료형(Data Type)의 오류 관리 ‣‣‣ 182
6.6 값의 일관성 확보 및 정제 ‣‣‣ 185
6.7 변수명 및 데이터 구조 표준화 ‣‣‣ 189
6.8 최종 점검:데이터 품질 검증 및 저장 ‣‣‣ 193
연습문제 ‣‣‣ 197
Chapter 7 데이터 시각화
7.1 데이터 시각화의 개요 ‣‣‣ 203
7.2 기본 그래프 함수 ‣‣‣ 205
7.3 ggplot2 패키지 소개 ‣‣‣ 211
7.4 다양한 시각화 유형 ‣‣‣ 215
7.5 고급 시각화 테크닉 ‣‣‣ 224
7.6 커스터마이징 및 테마 적용 ‣‣‣ 230
7.7 시각화의 실무 적용 전략 ‣‣‣ 239
연습문제 ‣‣‣ 242
Chapter 8 R을 이용한 한국어 텍스트 분석:핵심 키워드 추출
8.1 분석 환경 준비 및 데이터 로딩 ‣‣‣ 249
8.2 텍스트 데이터 정제(Preprocessing) ‣‣‣ 251
8.3 텍스트 토큰화 및 단어 필터링 ‣‣‣ 252
8.4 핵심 키워드 빈도 분석 ‣‣‣ 254
8.5 분석 결과 시각화 및 해석 ‣‣‣ 256
INDEX ‣‣‣ 259

