









출고예상일 안내
주문하신 상품이 한국에서 현지 배송을 위한 출고단계가 이루어질 것으로 예상되는 날짜입니다. 상품을 준비하는 과정에서 내부적인 사정으로 인해 출고예상일에 다소 오차가 생길 수 있습니다.
여러 상품(예약상품포함)을 함께 주문하신 경우 출고예상일이 가장 늦은 날짜에 맞춰 함께 배송됩니다.


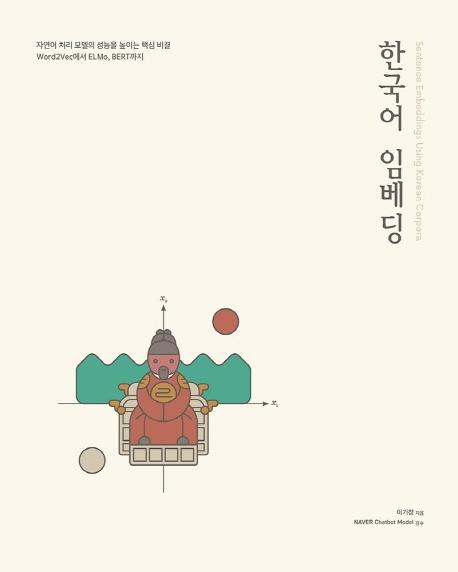





ISBN : 9791161753508 / 348쪽 188 x 235 (㎜)
이 상품에 궁금하신점이 있으세요? 1:1상담문의



아래의 도서와 구매하시면 이 도서들의 적립금을 즉시적용해 드립니다.
-

이와사키 히로마사
-
제임스 러브록
-
김현철, 신은경, 이민정, 박선우, 정기민, 곽소아, 정문수
-

클리커, 강민혁
- 15,120
- 18,900
- 21,420
- 23,400



반디앤루니스 리뷰
자연어 처리 모델의 성능을 높이는 핵심 비결, <한국어 임베딩>
임베딩(embedding)은 자연어를 숫자의 나열인 벡터로 바꾼 결과 혹은 그 일련의 과정 전체를 가리키는 용어다. 단어나 문장 각각을 벡터로 변환해 벡터 공간에 '끼워 넣는다(embed)'는 취지에서 임베딩이라는 이름이 붙었다. 컴퓨터가 자연어를 처리할 수 있게 하려면 자연어를 계산 가능한 형식인 임베딩으로 바꿔줘야 한다.
임베딩은 컴퓨터가 자연어를 이해하도록 하는 첫 관문으로 매우 중요한 기능을 한다. 자연어 처리 모델의 성능은 임베딩이 좌우한다고 해도 과언이 아니다. 이 책에서는 다양한 임베딩 기법을 일별하고 한국어 데이터 전처리, 임베딩 구축에 이르는 전 과정을 튜토리얼 방식으로 소개한다. Word2Vec 등 단어 수준 기법부터 ELMo, BERT 등 문장 수준 임베딩까지 다룬다.
출판사 리뷰
★ 이 책에서 다루는 내용 ★ ■ 자연어 처리의 첫 관문인 임베딩의 개념과 종류, 역사 소개 ■ 임베딩이 어떻게 자연어 의미를 함축하는지 이론적 배경 풀이 ■ 위키백과, KorQuAD 등 한국어 말뭉치 전처리 노하우 공유 ■ KoNLPy, soynlp, 구글 센텐스피스(sentencepiece) 패키지 안내 ■ Word2Vec, GloVe, FastText, Swivel 등 단어 수준 임베딩 ■ LDA, Doc2Vec, ELMo, BERT 등 문장 수준 임베딩 설명 ■ 개별 모델 학습과 동작 과정을 코드 레벨로 설명한 후 튜토리얼 진행 ■ 문서 분류 태스크를 중심으로 임베딩 파인튜닝(fine-tuning) 실습 ★ 이 책의 대상 독자 ★ ■ 임베딩의 이론적 배경과 동작 원리에 관심이 많은 데이터 과학자 ■ 자연어 분포와 의미 사이의 관계 해명을 중시하는 언어학 연구자 ■ 품질 좋은 임베딩을 현업에 적용하려는 머신 러닝 엔지니어와 개발자

-
- 저자 : 이기창

★ 지은이의 말 ★
컴퓨터는 ‘계산기’에 불과하다. 컴퓨터는 사람의 말, 즉 자연어(natural language)를 바로 이해할 수 없다. 자연어를 100% 이해하는 인공지능이 등장하더라도 그 이해(understanding)의 본질은 연산(computation)이나 처리(processing)다. 컴퓨터가 자연어를 처리할 수 있게 하려면 자연어를 계산 가능한 형식으로 바꿔줘야 한다.
임베딩(embedding)은 자연어를 숫자의 나열인 벡터(vector)로 바꾼 결과 혹은 그 일련의 과정 전체를 가리키는 용어다. 단어나 문장 각각을 벡터로 변환해 벡터 공간(vector space)에 ‘끼워 넣는다(embed)’는 취지에서 임베딩이라는 이름이 붙었다. 컴퓨터는 임베딩을 계산, 처리해 자연어 형식의 답변을 출력함으로써 인간과 상호작용할 수 있게 된다. 그렇기 때문에 임베딩은 컴퓨터가 자연어를 이해하도록 하는 첫 관문으로 매우 중요한 기능을 한다.
임베딩에는 말뭉치(corpus)의 의미, 문법 정보가 응축돼 있다. 임베딩은 벡터이기 때문에 사칙연산이 가능하며, 단어/문서 관련도(relevance) 역시 계산할 수 있다. 최근 들어 임베딩이 중요해진 이유는 따로 있다. 바로 전이 학습(transfer learning) 때문이다. 전이 학습이란 특정 문제를 풀기 위해 학습한 모델을 다른 문제를 푸는 데 재사용하는 기법을 의미한다. 예컨대 대규모 말뭉치를 미리 학습(pretrain)한 임베딩을 문서 분류 모델의 입력값으로 쓰고, 해당 임베딩을 포함한 모델 전체를 문서 분류 과제를 잘할 수 있도록 업데이트(fine-tuning)하는 방식이 바로 그것이다. 물론 전이 학습은 문서 분류 이외의 다양한 다른 과제에도 적용할 수 있다.
전이 학습 혹은 프리트레인-파인 튜닝 메커니즘은 사람의 학습과 비슷한 점이 있다. 사람은 무언가를 배울 때 제로 베이스에서 시작하지 않는다. 사람이 새로운 사실을 빠르게 이해할 수 있는 이유는 그가 이해를 하는 데에 평생 쌓아 온 지식을 동원하기 때문이다. 자연어 처리 모델 역시 제로에서 시작하지 않는다. 우선 대규모 말뭉치를 학습시켜 임베딩을 미리 만들어 놓는다(프리트레인). 이 임베딩에는 의미, 문법 정보가 녹아 있다. 이후 임베딩을 포함한 모델 전체를 문서 분류 과제에 맞게 업데이트한다(파인 튜닝). 이로써 전이 학습 모델은 제로부터 학습한 모델보다 문서 분류 과제를 빠르게 잘 수행할 수 있다.
품질 좋은 임베딩은 잘 담근 김치와 같다. 김치 맛이 좋으면 물만 부어 끓인 김치찌개 맛도 좋다. 임베딩 품질이 좋으면 단순한 모델로도 원하는 성능을 낼 수 있다. 모델 구조가 동일하다면 그 성능은 높고 수렴(converge)은 빠르다. 자연어 처리 모델을 만들고 서비스할 때 중요한 구성 요소 하나만 꼽으라고 한다면, 나는 주저하지 않고 ‘임베딩’을 꼽을 것이다. ELMo(Embeddings from Language Models), BERT(Bidirectional Encoder Representations from Transformer), GPT(Generative Pre-Training) 등 자연어 처리 분야에서 당대 최고 성능을 내는 기법들이 모두 전이 학습 혹은 프리트레인-파인 튜닝 메커니즘을 사용하는 것은 우연의 일치가 아니다.
주지하다시피 자연어 처리 분야의 대세는 오픈소스(open source)다. 논문은 물론 데이터와 코드까지 모두에게 공개하는 경우가 다반사다. 덕분에 모델 발전 속도가 상상 이상으로 빨라졌다. 최초의 뉴럴 네트워크 기반 임베딩 기법으로 평가받는 NPLM(Neural Probabilistic Language Model)이 2003년 제안된 이후 10년 만에 단어 수준의 임베딩 기법 Word2Vec이 발표됐다. 5년 뒤 문장 수준 임베딩 기법 ELMo가 공개됐고, 같은 해 GPT와 BERT가 등장했다. 이후 모델들에 대해서는 기회가 된다면 이 책의 2판에서 다뤄야 할 것이다.
이 책에서는 NPLM, Word2Vec, FastText, 잠재 의미 분석(LSA), GloVe, Swivel 등 6가지 단어 수준 임베딩 기법, LSA, Doc2Vec, 잠재 디리클레 할당(LDA), ELMo, BERT 등 5가지 문장 수준 임베딩 기법을 소개한다. 이외에도 다양한 임베딩 기법이 있지만 두 가지 원칙에 입각해 일부만 골랐다. 우선 성능이 안정적이고 뛰어나 현업에 바로 적용해봄직한 기법을 선택했다. 또 임베딩 기법의 발전 양상을 이해하는 데 중요한 역할을 하는 모델을 포함했다. ‘정보의 홍수’ 속에서 살아가는 독자들에게 핵심에 해당하는 지식만을 전해주고 싶었기 때문이다. 기타 임베딩 기법들은 대부분, 이 책에서 소개하는 11개 모델의 변형에 해당하기 때문에 독자 여러분이 추가로 공부하고 싶은 최신 기법이 있다면 이 책에서 가지를 쳐 나가는 식으로 학습하면 수월할 것이다.
이 책을 읽는 독자라면 논문 저자들이 공개한 코드를 내려받아 자신의 데이터로 얼마든지 직접 임베딩을 구축할 수 있을 것이다. 개별 임베딩 기법의 이론적 배경을 쉽게 설명해 놓은 영문 자료들도 차고 넘친다. 그러나 내가 아는 한 임베딩이라는 주제를 본격적으로 취급한 ‘한국어 서적’은 없다. 이것은 내가 아직 부족한 것이 많음에도 임베딩에 초점을 맞춰 책을 써 보기로 결심한 계기이기도 하다. 독자 여러분이 임베딩 기법을 이해하는 시간과 노력을 아끼는 데 이 책이 조금이라도 도움이 된다면 더 이상 바랄 것이 없다.


1장. 서론
1.1 임베딩이란
1.2 임베딩의 역할
1.2.1 단어/문장 간 관련도 계산
1.2.2 의미/문법 정보 함축
1.2.3 전이 학습
1.3 임베딩 기법의 역사와 종류
1.3.1 통계 기반에서 뉴럴 네트워크 기반으로
1.3.2 단어 수준에서 문장 수준으로
1.3.3 룰 → 엔드투엔드 → 프리트레인/파인 튜닝
1.3.4 임베딩의 종류와 성능
1.4 개발 환경
1.4.1 환경 소개
1.4.2 AWS 구성
1.4.3 코드 실행
1.4.4 버그 리포트 및 Q&A
1.4.5 이 책이 도움받고 있는 오픈소스들
1.5 이 책이 다루는 데이터와 주요 용어
1.6 이 장의 요약
1.7 참고 문헌
2장. 벡터가 어떻게 의미를 가지게 되는가
2.1 자연어 계산과 이해
2.2 어떤 단어가 많이 쓰였는가
2.2.1 백오브워즈 가정
2.2.2 TF-IDF
2.2.3 Deep Averaging Network
2.3 단어가 어떤 순서로 쓰였는가
2.3.1 통계 기반 언어 모델
2.3.2 뉴럴 네트워크 기반 언어 모델
2.4 어떤 단어가 같이 쓰였는가
2.4.1 분포 가정
2.4.2 분포와 의미 (1): 형태소
2.4.3 분포와 의미 (2): 품사
2.4.4 점별 상호 정보량
2.4.5 Word2Vec
2.5 이 장의 요약
2.6 참고 문헌
3장. 한국어 전처리
3.1 데이터 확보
3.1.1 한국어 위키백과
3.1.2 KorQuAD
3.1.3 네이버 영화 리뷰 말뭉치
3.1.4 전처리 완료된 데이터 다운로드
3.2 지도 학습 기반 형태소 분석
3.2.1 KoNLPy 사용법
3.2.2 KoNLPy 내 분석기별 성능 차이 분석
3.2.3 Khaiii 사용법
3.2.4 은전한닢에 사용자 사전 추가하기
3.3 비지도 학습 기반 형태소 분석
3.3.1 soynlp 형태소 분석기
3.3.2 구글 센텐스피스
3.3.3 띄어쓰기 교정
3.3.4 형태소 분석 완료된 데이터 다운로드
3.4 이 장의 요약
3.5 참고 문헌
4장. 단어 수준 임베딩
4.1 NPLM
4.1.1 모델 기본 구조
4.1.2 NPLM의 학습
4.1.3 NPLM과 의미 정보
4.2 Word2Vec
4.2.1 모델 기본 구조
4.2.2 학습 데이터 구축
4.2.3 모델 학습
4.2.4 튜토리얼
4.3 FastText
4.3.1 모델 기본 구조
4.3.2 튜토리얼
4.3.3 한글 자소와 FastText
4.4 잠재 의미 분석
4.4.1 PPMI 행렬
4.4.2 행렬 분해로 이해하는 잠재 의미 분석
4.4.3 행렬 분해로 이해하는 Word2Vec
4.4.4 튜토리얼
4.5 GloVe
4.5.1 모델 기본 구조
4.5.2 튜토리얼
4.6 Swivel
4.6.1 모델 기본 구조
4.6.2 튜토리얼
4.7 어떤 단어 임베딩을 사용할 것인가
4.7.1 단어 임베딩 다운로드
4.7.2 단어 유사도 평가
4.7.3 단어 유추 평가
4.7.4 단어 임베딩 시각화
4.8 가중 임베딩
4.8.1 모델 개요
4.8.2 모델 구현
4.8.3 튜토리얼
4.9 이 장의 요약
4.10 참고 문헌
5장. 문장 수준 임베딩
5.1 잠재 의미 분석
5.2 Doc2Vec
5.2.1 모델 개요
5.2.2 튜토리얼
5.3 잠재 디리클레 할당
5.3.1 모델 개요
5.3.2 아키텍처
5.3.3 LDA와 깁스 샘플링
5.3.4 튜토리얼
5.4 ELMo
5.4.1 문자 단위 컨볼루션 레이어
5.4.2 양방향 LSTM, 스코어 레이어
5.4.3 ELMo 레이어
5.4.4 프리트레인 튜토리얼
5.5 트랜스포머 네트워크
5.5.1 Scaled Dot-Product Attention
5.5.2 멀티헤드 어텐션
5.5.3 Pointwise Feed-Forward Networks
5.5.4 트랜스포머의 학습 전략
5.6 BERT
5.6.1 BERT, ELMo, GPT
5.6.2 프리트레인 태스크와 학습 데이터 구축
5.6.3 BERT 모델의 구조
5.6.4 프리트레인 튜토리얼
5.7 이 장의 요약
5.8 참고 문헌
6장. 임베딩 파인 튜닝
6.1 프리트레인과 파인 튜닝
6.2 분류를 위한 파이프라인 만들기
6.3 단어 임베딩 활용
6.3.1 네트워크 개요
6.3.2 네트워크 구현
6.3.3 튜토리얼
6.4 ELMo 활용
6.4.1 네트워크 개요
6.4.2 네트워크 구현
6.4.3 튜토리얼
6.5 BERT 활용
6.5.1 네트워크 개요
6.5.2 네트워크 구현
6.5.3 튜토리얼
6.6 어떤 문장 임베딩을 사용할 것인가
6.7 이 장의 요약
6.8 참고 문헌
부록
부록 A. 선형대수학 기초
1.1 벡터, 행렬 연산
1.2 내적과 공분산
1.3 내적과 사영
1.4 내적과 선형변환
1.5 행렬 분해 기반 차원 축소 (1): 주성분 분석(PCA)
1.6 행렬 분해 기반 차원 축소 (2): 특이값 분해(SVD)
부록 B. 확률론 기초
2.1 확률변수와 확률 분포
2.2 베이지안 확률론
부록 C. 뉴럴 네트워크 기초
3.1 DAG로 이해하는 뉴럴 네트워크
3.2 뉴럴 네트워크는 확률모델이다
3.3 최대우도추정과 학습 손실
3.4 그래디언트 디센트
3.5 계산 노드별 역전파
3.6 CNN과 RNN
부록 D. 국어학 기초
4.1 통사 단위
4.2 문장 유형
4.3 품사
4.4 상과 시제
4.5 주제
4.6 높임
4.7 양태
4.8 의미역
4.9 피동
4.10 사동
4.11 부정
참고 문헌

