









출고예상일 안내
주문하신 상품이 한국에서 현지 배송을 위한 출고단계가 이루어질 것으로 예상되는 날짜입니다. 상품을 준비하는 과정에서 내부적인 사정으로 인해 출고예상일에 다소 오차가 생길 수 있습니다.
여러 상품(예약상품포함)을 함께 주문하신 경우 출고예상일이 가장 늦은 날짜에 맞춰 함께 배송됩니다.


웹 크롤링 테크닉 자바스크립트와 Node.js를 이용한
원제 : JS+Node.jsによるWebクローラー/ネットエージェント開発テクニック
쿠지라 히코우즈쿠에 저 | 이동규 역 | 제이펍 | 2016년 12월
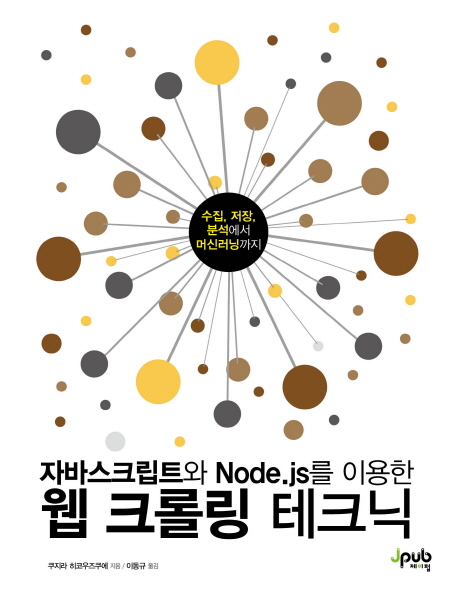





ISBN : 9791185890661 / 516쪽 189 x 246 (㎜)
이 상품에 궁금하신점이 있으세요? 1:1상담문의



아래의 도서와 구매하시면 이 도서들의 적립금을 즉시적용해 드립니다.
-

이와사키 히로마사
-
LearnAI Team
-
장세림
-
제임스 러브록
- 15,120
- 21,600
- 21,600
- 18,900



반디앤루니스 리뷰
자바스크립트로 손쉽게 웹 크롤러를 만들고,
수집한 데이터를 저장/처리하여 세련되게 시각화하고,
쉽고 간단한 스트립트로 원하는 데이터를 모두 내려받자!
이 책은 자바스크립트의 기본을 알고 있는 독자나 프로그래밍 중급자를 대상으로 한다. 언어와 상관없이 초급에서 중급 수준의 독자가 읽으면 반드시 큰 도움이 될 것이다. 게다가 웹을 대표하는 언어인 자바스크립트를 사용하므로 코드를 이해하기 쉽고 수정하기에도 쉽다.
이 책에서 소개하는 기술이나 프로그램은 그대로 사용할 수 있는 것도 많지만, 약간 손을 봄으로써 보다 실용적인 툴이 될 수 있다. 이 책에서 소개하는 내용을 바탕으로 웹이나 업무 속 데이터에 묻혀 있는 보물을 발굴하기 바란다
출판사 리뷰
출판사 서평 자바스크립트로 손쉽게 웹 크롤러를 만들고, 수집한 데이터를 저장/처리하여 세련되게 시각화하고, 쉽고 간단한 스트립트로 원하는 데이터를 모두 내려받자! 이 책은 다양한 에이전트를 만들어 웹 데이터 수집과 처리를 자동화하는 방법을 소개한다. 우리가 익히 알고 있듯이 웹에는 유익한 데이터가 가득한데, 이러한 데이터를 체계적으로 수집하여 분석하고 활용하는 것은 즐거운 취미가 될 수도, 다양한 업무에 실질적인 도움이 될 수도 있을 것이다. 이 책의 전반부를 통해 웹사이트를 순회하는 크롤러를 만들어 본인만의 데이터베이스를 구... 자바스크립트로 손쉽게 웹 크롤러를 만들고, 수집한 데이터를 저장/처리하여 세련되게 시각화하고, 쉽고 간단한 스트립트로 원하는 데이터를 모두 내려받자! 이 책은 다양한 에이전트를 만들어 웹 데이터 수집과 처리를 자동화하는 방법을 소개한다. 우리가 익히 알고 있듯이 웹에는 유익한 데이터가 가득한데, 이러한 데이터를 체계적으로 수집하여 분석하고 활용하는 것은 즐거운 취미가 될 수도, 다양한 업무에 실질적인 도움이 될 수도 있을 것이다. 이 책의 전반부를 통해 웹사이트를 순회하는 크롤러를 만들어 본인만의 데이터베이스를 구축할 수 있게 될 것이다. 그런데 그렇게 모은 데이터를 어떻게 활용할지 몰라 묵혀 두기만 한다면 너무나 안타까운 일이 아닐 수 없다. 이 책에서는 수집뿐만 아니라 수집한 데이터를 검색하고, 필요한 데이터를 추출하고, 일정한 규칙을 통해 자동으로 분류하거나 예측하는 등 한 걸음 더 나아간 활용법을 제안한다. 이러한 기술들을 잘 응용하면 주식과 외환 매매에 참고할 트렌드 데이터를 얻을 수 있으며, 블로그 광고에 활용하여 수익률을 올리는 등 무궁무진한 활용이 가능하다. 이 책의 대상 독자 ● 자바스크립트를 보다 유용하게 활용하고자 하는 분 ● 텍스트 데이터의 처리, 분류, 활용에 관심 있는 분 ● 웹에 공개되어 있는 가치 있는 정보와 활용법을 알고자 하는 분 이 책에서 사용하는 기술 ● 머신러닝 ● 문자 인식 ● 형태소 분석 ● 베이지안 필터 ● GoogleCharts ● D3.js ● 각종 SNS의 웹 API ● HTML 파싱 ● DOM 요소 추출 ● PhantomJS/CasperJS ● Electron

-
- 구분 : 저서
- 이름 : 쿠지라 히코우즈쿠에
- 국적 : 일본
- 직업 :
- 분류 : 과학/공학 저자 , 기타
- 인기지수 [213]
-



-
- 이름 : 이동규
- 국적 : 대한민국
- 직업 :
- 분류 : 과학/공학 저자 , 기타
- 인기지수 [122]
-


구매 봇이라고도 불린다. 사용자가 인터넷에서 상품이나 서비스를 발견하는 것을 도와주는 에이전트다. 예를 들면, 아마존에서 쇼핑할 때 페이지 밑에 유사 상품들이 표시된다. 이것은 그 페이지를 본 다른 사용자가 구매한 상품이나, 사용자가 본 다른 상품의 경향 정보를 이용한 것이다. 전문점의 점원이라면 손님의 이야기를 듣고 손님에게 딱 맞는 상품을 선택해 준다. 약사는 손님의 증상을 듣고 맞는 약을 추천해 준다. 이와 마찬가지로 바이어 에이전트도 사용자의 취향을 고려해서 상품을 추천해 준다. _9p
자바의 파일이나 네트워크 API는 데이터를 스트림으로 다룬다. 스트림은 데이터를 흐르는 것으로 간주하여 흘러 들어오는 데이터를 입력으로 다루고, 흘러 나가는 데이터를 출력으로 다룬다. 우리가 작성한 프로그램의 경우 스트림의 입력은 웹 서버에서 전송되는 데이터다. 그리고 스트림의 출력은 로컬 파일이다. 이처럼 스트림의 입구와 출구를 지정하면 단숨에 데이터를 읽고 쓴다. 여기까지의 내용을 프로그램을 통해 확인해 보자. _47p
윈도우의 작업 스케줄러에서는 정기적으로 실행하는 처리를 ‘작업’이라고 부르며, 작업을 작성함으로써 정기적인 실행을 설정할 수 있다. 새로운 작업을 작성하려면 먼저 작업 스케줄러의 좌측 트리에서 [작업 스케줄러 (로컬)] 폴더를 클릭한다. 이어 오른쪽의 작업 패널에서 ‘작업 만들기’를 클릭한다. 그러면 작업 만들기 마법사가 실행된다. _91p
Node.js의 표준 상태에서는 EUC-KR 등의 문자 코드를 다룰 수 없으므로 외부 모듈을 설치해야 한다. 문자 코드 변환에는 iconv라는 라이브러리가 널리 쓰이는데 Node.js에도 iconv 모듈이 존재한다. 또한, 문자 코드의 자동 판정용 모듈 jschardet도 있다. 여기서는 이 두 개의 라이브러리를 사용해 볼 것이다. 다음과 같이 npm을 사용하여 iconv와 jschardet을 설치하도록 한다. _151p
좀 더 복잡한 작업을 자바스크립트로 수행하고 싶은 경우에는 자바 라이브러리의 힘을 빌리는 것이 좋다. 여기서는 자바 라이브러리인 Apache POI를 사용해 본다. Rhino/JavaScript에서는 자바의 라이브러리를 사용할 수 있다. Apache POI는 자바 라이브러리로, 마이크로소프트의 엑셀과 워드 파일을 자바에서 조작하기 위한 라이브러리다. Apache POI을 사용하면 엑셀과 워드가 설치되지 않은 PC에서도 엑셀/워드 파일을 읽고 쓸 수 있다. Apache POI는 다음 URL에서 다운로드할 수 있다. _239~240p

목차
제1장 개발 환경 1
01 자바스크립트 엔진의 이모저모 _ 2
ECMAScript가 실현한 범용 자바스크립트의 세계 _ 2
자바스크립트 엔진의 이모저모 _ 3
자바스크립트가 데이터 수집에 적합한 이유 _ 6
02 에이전트란 무엇인가? _ 8
에이전트의 의미 _ 8
지능형 에이전트 _ 9
03 개발 환경 구축 _ 11
가상 머신에 실행 환경 구축 _ 11
가상 머신 생성 _ 12
가상 머신에 로그인하기 _ 16
Node.js 설치 _ 19
git 설치 _ 21
04 Node.js 모듈 설치 _ 24
npm이란? _ 24
npm install로 모듈 설치 _ 24
모듈 삭제 _ 30
05 개발 생산성을 높여 줄 모던한 에디터 소개 _ 31
자바스크립트 작성에 필요한 에디터는? _ 31
Atom ― 풍부한 플러그인이 매력 _ 32
Sublime Text ― 환상적인 커스터마이징 기능으로 사랑에 빠지게 된다는 화제
Brackets ― HTML 편집에 특화된 빛나는 에디터 _ 36
통합 개발 환경에서의 자바스크립트 개발 _ 38
WebStorm ― 자바스크립트 개발에 특화된 개발 환경 _ 39
NetBeans ― 자바 뿐만 아니라 다양한 웹 개발 언어를 지원 _ 40
제2장 웹 데이터 수집 41
01 웹 페이지 다운로드 _ 42
가장 간단한 다운로드 방법 _ 42
Node.js로 다운로드해 보자 _ 42
Rhino/Narshon으로 다운로드해 보기 _ 46
02 HTML 해석(링크와 이미지 추출) _ 48
스크래핑이란? _ 48
HTML 파일 다운로드 _ 49
HTML 파일에서 링크 추출 _ 51
이미지 파일 추출 _ 55
03 사이트를 통째로 다운로드 _ 61
통째로 다운로드하는 이유 _ 61
프로그램을 만들어 보자 _ 62
04 XML/RSS 해석 _ 69
XML이란? _ 69
Node.js에서 XML을 다루는 방법 _ 71
RSS란? _ 76
XML/RSS 파싱에 cheerio-httpcli를 사용하는 방법 _ 79
05 정기적으로 다운로드 _ 82
정기적인 처리를 수행 _ 82
환율의 변동을 확인하는 API 사용 _ 83
리눅스/Mac OS X의 경우 _ 85
윈도우의 경우 _ 90
제3장 로그인이 필요한 웹사이트 크롤링 95
01 PhantomJS와 CasperJS _ 96
PhantomJS와 CasperJS에 관하여 _ 96
PhantomJS와 CasperJS 설치 _ 98
간단한 예제 프로그램 _ 99
플리커 이미지 검색 결과 캡처하기 _ 103
아이폰용 웹사이트 화면 캡처 _ 105
인자로 지정한 페이지를 캡처하는 도구 작성 _ 106
02 로그인 후의 데이터를 다운로드 _ 109
로그인이 필요한 경우 _ 109
티스토리에 로그인하기 _ 109
마우스 클릭 _ 113
03 DOM 파싱 방법과 CSS 선택자 _ 115
웹 브라우저의 개발자 도구 사용법 _ 115
CSS 선택자 지정 방법 _ 118
CSS 선택자 실전편 _ 120
04 Electron으로 데스크톱 애플리케이션 작성 _ 124
Electron이란? _ 124
Electron 설치 방법 _ 127
Electron으로 간단한 애플리케이션을 만드는 순서 _ 127
직접 준비한 HTML을 Electron에 표시 _ 130
메인 프로세스와 렌더링 프로세스 간의 통신 _ 132
05 Electron으로 스크린 캡처 _ 138
스크린샷을 찍는 제일 빠른 방법 _ 138
Electron으로 스크린샷을 찍는 방법 _ 138
미세한 조정을 위해 딜레이 주기 _ 142
캡처할 범위를 지정 _ 144
제4장 데이터 처리 및 저장 147
01 문자 코드와 호환 _ 148
문자 코드란? _ 148
자바스크립트의 문자 코드 _ 150
Node.js의 경우 _ 150
iconv-lite를 사용한 문자 코드 변환 _ 155
Rhino를 사용하는 경우 _ 156
02 정규 표현식을 사용한 데이터 변환 _ 157
정규 표현식이란? _ 157
자바스크립트에서의 정규 표현식 사용법 _ 158
03 데이터 형식의 기초 _ 166
웹에 있는 데이터 형식 _ 166
JSON 형식이란? _ 167
JSON의 개량판, JSON5 형식 _ 170
CSON 형식 _ 172
XML/RSS 형식 _ 174
YAML 형식 _ 177
INI 파일 형식 _ 181
CSV/TSV 파일 형식 _ 184
그 외의 형식 _ 188
04 커피스크립트 _ 190
왜 커피스크립트인가? _ 190
커피스크립트 설치 _ 191
프로그램 실행 방법 _ 191
커피스크립트의 기본 문법 _ 192
참과 거짓 _ 195
배열 _ 196
연산자 _ 197
제어 구문 _ 199
함수 작성 _ 203
객체지향 _ 206
05 데이터베이스 사용법 _ 210
왜 데이터베이스를 사용하는가? _ 210
관계형 데이터 모델과 NoSQL _ 210
관계형 데이터베이스 SQLite3 사용 _ 211
웹으로부터 다운로드하여 SQLite에 저장 _ 213
NoSQL LevelDB를 사용 _ 217
데이터를 LevelDB에 보관 _ 223
06 리포트 자동 생성 _ 227
리포트 자동 생성 _ 227
출력 형식 _ 228
PDF 작성 _ 230
엑셀 형식으로 작성 _ 238
Node.js + Ocegen 사용법 _ 238
Rhino와 Apache POI 사용법 _ 239
웹 API로 획득한 값을 엑셀에 쓰기 _ 242
제5장 한글 형태소 분석 245
01 형태소 분석에 관하여 _ 246
형태소 분석이란? _ 246
형태소 분석을 이용하는 방법 _ 247
mecab-ko의 설치 _ 248
02 특정 품사의 단어들을 추출 _ 251
Node.js에서 mecab-ko를 사용하는 방법 _ 251
프로그램을 정리하여 형태소 분석 모듈 작성 _ 254
특정 품사의 단어들을 추출하는 프로그램 _ 257
03 마르코프 체인을 이용한 문서 요약 _ 260
마르코프 체인을 이용한 문서 요약 _ 260
프로그램에 관하여 _ 264
04 간단한 문장 교정 도구 작성 _ 266
문장 교정 도구에 관하여 _ 266
05 단어의 출현 빈도 조사 _ 271
단어의 출현 빈도 조사 _ 271
제6장 크롤링을 위한 데이터 소스 277
01 유익한 데이터 소스 목록 _ 278
데이터 소스에 관하여 _ 278
SNS의 활용 _ 278
소셜 북마크 활용 _ 279
상품 정보 활용 _ 279
온라인 사전의 활용 _ 280
오프라인 사전 데이터 활용 _ 280
블로그 서비스 활용 _ 281
02 트위터 크롤링 _ 283
트위터란? _ 283
트위터 API 준비 _ 283
03 페이스북 _ 289
페이스북이란? _ 289
페이스북 API _ 289
04 네이버 API 사용 _ 297
네이버 API _ 297
05 아마존 API 사용 _ 302
아마존의 상품 정보 _ 302
API를 위한 개발자 계정 생성 _ 303
아마존의 도서 정보 검색 _ 308
06 플리

