









출고예상일 안내
주문하신 상품이 한국에서 현지 배송을 위한 출고단계가 이루어질 것으로 예상되는 날짜입니다. 상품을 준비하는 과정에서 내부적인 사정으로 인해 출고예상일에 다소 오차가 생길 수 있습니다.
여러 상품(예약상품포함)을 함께 주문하신 경우 출고예상일이 가장 늦은 날짜에 맞춰 함께 배송됩니다.







ISBN : 9791140709328 / 424쪽 / 806g / 183 x 235 (㎜)
이 상품에 궁금하신점이 있으세요? 1:1상담문의



아래의 도서와 구매하시면 이 도서들의 적립금을 즉시적용해 드립니다.
-

거트루드(박태현)
-
빨간고래(박정아)
-
-

클리커, 이희영, 강민혁
- 23,400
- 24,300
- 20,700
- 22,500



반디앤루니스 리뷰
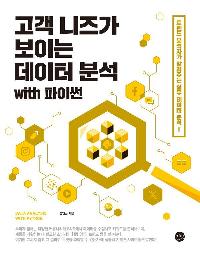
고객의 진정한 니즈가 담긴 데이터를 수집하고 분석한다!
유튜브, 네이버 카페, 트위터 등에서 찾아내는 고객 니즈와 시장 트렌드!
데이터 시대에서 살아가고 있는 만큼, 데이터를 분석해 의사 결정을 내리는 일이 너무도 당연해졌다. 하지만 찰나의 순간에도 데이터가 무수히 쌓이는 탓에 정작 중요한 정보를 제대로 파악하기가 힘들다. 이런 데이터 홍수 속에서 우리는 어떻게 가치 있는 데이터를 가려내고 이를 비즈니스에 활용할 수 있을까? 이 책은 우리가 자주 사용하는 커뮤니티나 네이버 카페, 유튜브, 트위터 등에서 데이터를 수집해 다양한 기법으로 분석한다. 주제마다 분석이 모두 끝나면, 여기서 어떤 정보를 얻을 수 있는지, 비즈니스에 어떻게 활용할 수 있는지를 생각해본다. 파이썬 문법부터 넘파이, 판다스 등 데이터 분석에 필요한 개념도 설명하므로 프로그래밍 지식이 부족해도 걱정 없이 볼 수 있다. 기초 통계도 마지막 장에 따로 수록되어 있어 모르는 개념만 선택적으로 읽을 수 있다. 의미 있는 데이터로 소비자의 니즈나 트렌드를 알고 싶거나 흥미로운 예제로 데이터 분석에 입문하고 싶다면 이 책을 강력하게 추천한다.
출판사 리뷰
유튜브, 네이버 카페, 트위터 등
유의미한 데이터에서 찾아내는 고객 니즈와 시장 트렌드!
요즘은 기술의 발전으로 소비자의 정보를 담고 있는 플랫폼이 많아지면서 과거처럼 정형화된 데이터보다는 텍스트나 이미지 같은 비정형화된 데이터가 주를 이루고 있다. 또한, 그만큼 개인의 취향과 소비 성향, 기호 등이 더욱 세분화되었고, 과거에는 큼직한 트렌드만 파악했다면 이제는 소비자가 정말 원하는 것이 무엇인지를 세부적으로 파악하는 것이 중요해졌다. 즉, 소비자가 가감 없이 표출한 데이터를 수집하고, 수집한 데이터 속에서 가치 있는 정보만 가려내 비즈니스에 활용하는 역량이 필요해졌다는 것이다.
이 책은 유튜브, 네이버 카페, 트위터 등 소비자의 정보가 가장 많이 쌓이는 곳에서 데이터를 수집하고 분석하는 방법을 설명한다. 파이썬 문법과 판다스, 넘파이 등 데이터를 분석하는 데 필요한 최소한의 개념들만 설명하기 때문에 실무자뿐만 아니라 관련 산업 종사자 누구든 학습할 수 있다. 또한, 기술에만 그치지 않고 데이터를 분석한 후에 얻은 정보로 어떤 제품이나 서비스를 기획할 수 있을지 현업 전문가의 의견을 엿볼 수 있는 코너까지 넣었다. 수포자도 이해하기 쉽게 설명한 통계 개념까지 마지막 장에 따로 담았으므로 수학적 개념이 부족하다면 함께 학습할 수도 있다. 소비자의 행동 양식, 트렌드를 파악하고 이를 비즈니스에 활용하고 싶은 모든 사람에게 추천한다.
책 속에서
데이터 분석을 잘하려면 어떻게 해야 할까요? 어떤 노력을 해야 할까요? 필자가 자주 듣는 질문입니다. 제가 찾은 해답을 바로 이 책에 담았습니다. 많은 데이터 분석 예제를 다루기보다는 분석자가 적극적으로 참여할 수 있는 그런 주제를 선정했습니다. 예를 들어 책 속의 예제인 ‘어떤 떡볶이를 기획할까?’ 주제는 이런 노력의 일환입니다. 대부분 좋아하는 국민 간식을 다루면서 어떤 떡볶이 신제품을 내놓는 게 좋을지 독자가 고민하게끔 만들고 싶었습니다. 왜냐하면 누구나 떡볶이 신제품에 대해 쉽게 제안을 할 수 있고, 고민을 할 수 있기 때문입니다. 게다가 데이터 분석 결과는 분석자의 고민에 비례하기 때문에 데이터 분석 결과가 옳은지보다 어떤 관점에서 결과를 바라볼 수 있을지에 맞춰 집필했습니다. 이 책을 읽고 나서 독자분들이 '저자와 달리 나는 이런 신제품으로 제안하는 게 맞는 것 같다'고 생각해준다면 그것이 바로 제가 원하던 결과입니다. 자신만의 관점과 이 관점을 지지하는 분석 과정을 찾기를 바랍니다. 이 책은 이 과정을 체험할 수 있게 구성되어 있습니다. - 정인근
--- 「본문」 중에서


-
- 저자 : 정인근

1장 자연어 분석 준비
1.1 실습 환경 준비
1.1.1 konlpy 설치
1.1.2 주피터 노트북 설치
1.1.3 주피터 노트북 사용법 익히기
1.1.4 분석에 필요한 라이브러리 설치
1.2 파이썬
1.2.1 변수와 데이터 타입
1.2.2 자료 구조
1.2.3 조건문
1.2.4 반복문
1.2.5 함수
1.2.6 변수 범위
1.3 판다스
1.3.1 데이터 프레임 생성
1.3.2 데이터 프레임 형태 조절
1.3.3 데이터 추출
1.3.4 논리 연산자
1.3.5 데이터 요약
1.3.6 결측치 처리
1.3.7 열 생성
1.3.8 데이터 그룹화
1.3.9 데이터 병합
1.4 경기도 인구 데이터 분석
1.5 국민건강보험공단 진료 내역 정보 전처리
1.5.1 설정 및 데이터 가져오기
1.5.2 데이터 연결 및 필요한 열만 추출
1.5.3 다른 데이터와 데이터 합치기 1
1.5.4 다른 데이터와 데이터 합치기 2
1.5.5 함수를 사용한 데이터 처리
2장 스크래퍼로 데이터 수집
2.1 스크래퍼란
2.2 스크래퍼 첫걸음
2.2.1 클라이언트와 서버의 개념
2.2.2 알아야 할 HTML 기초 지식
2.2.3 HTML 파일 생성
2.2.4 간단한 스크래퍼 만들기
2.3 requests 라이브러리를 활용한 커뮤니티 정보 수집
2.3.1 스크래퍼 제작 첫 단계는 URL 찾기부터
2.3.2 HTML 수집과 파싱
2.3.3 정보 수집하기
2.3.4 데이터 전처리: 정규 표현식
2.3.5 결과 저장
2.4 무엇이든 수집하는 selenium 라이브러리
2.4.1 가상 웹 브라우저 사용 준비
2.4.2 양질의 정보가 있는 네이버 카페
2.4.3 생생한 고객 의견을 들을 수 있는 쇼핑몰 리뷰 수집
3장 수집한 데이터로 자연어 분석
3.1 내가 그 편의점만 가는 이유
3.1.1 커뮤니티 데이터 불러오기
3.1.2 데이터 전처리 1: 정규 표현식
3.1.3 데이터 전처리 2: 형태소 분석
3.1.4 데이터 분석 1: 많이 등장한 단어를 찾아 주는 다빈도 단어 분석
3.1.5 데이터 분석 2: 자주 등장하는 짝꿍 단어를 찾아 주는 nGram 분석
3.1.6 데이터 분석 3: 편의점 주력 제품 찾기
3.1.7 데이터 분석 4: TFIDF로 편의점 주요 키워드 찾기
3.1.8 편의점에는 어떤 제품이 반응이 좋을까요: 결과 1차 정리
3.2 어떤 떡볶이가 맛있을까?
3.2.1 데이터 불러오기: 쇼핑몰 데이터
3.2.2 데이터 전처리: 가중치 구하기
3.2.3 데이터 분석: 자주 등장하는 떡볶이 해시태그 찾기
3.2.4 데이터 불러오기: 떡볶이 제품 리뷰 데이터
3.2.5 데이터 전처리: 정규 표현식
3.2.6 데이터 전처리: 형태소 분석
3.2.7 데이터 분석: 다빈도 표현 분석
3.2.8 데이터 분석: 떡볶이 소비 환경 분석
3.2.9 어떤 떡볶이를 기획하면 좋을까?
3.3 2040 여성들의 건강 고민 살피기
3.3.1 데이터 불러오기: 여성 건강 커뮤니티 데이터
3.3.2 데이터 분석: 게시물 날짜 정보 구하기
3.3.3 데이터 분석: 포스팅 랭킹 구하기
3.3.4 데이터 분석: 주요 주제 찾기
3.3.5 형태소 분석: 명사 추출
3.3.6 데이터 불러오기: 트위터
3.3.7 데이터 전처리: 맞춤법 교정
3.3.8 데이터 전처리: 명사 추출
3.3.9 데이터 분석: nGram
3.3.10 국민건강보험공단에서 제공하는 진료 내역 정보 데이터 분석
3.3.11 2040 여성에게 어떤 건강 서비스를 제공하면 좋을까?
3.4 내 여자친구 최애 쿠션 찾아 주기
3.4.1 데이터 가져오기
3.4.2 제품 기본 정보 데이터 전처리
3.4.3 해시태그 전처리
3.4.4 해시태그 분석으로 제품 트렌드 변화 관찰
3.4.5 Rank( ) 함수로 해시태그에 가중치 더하기
3.4.6 해시태그 빈도 및 기울기 구하기
3.4.7 주요 제품 열 개 찾아보기
3.4.8 리뷰 데이터 불러오기
3.4.9 형태소 분석을 이용하여 리뷰에서 의도 찾기
3.4.10 nGram으로 키워드 파악
3.4.11 표현의 숨겨진 의미 찾기
3.4.12 머신 러닝을 활용하여 중요한 내용 찾기
3.4.13 쿠션에 어떤 기능을 강화하면 좋을까?
3.5 자연어 분석 심화편
3.5.1 편의점 데이터 분석: 유튜브 댓글 데이터 불러오기
3.5.2 데이터 전처리 1: 필요한 데이터만 남기는 데이터 압축 방법
3.5.3 데이터 전처리 2: 형태소 분석
3.5.4 데이터 분석 1: 다빈도 단어
3.5.5 데이터 분석 2: nGram
3.5.6 토픽 모델링
3.5.7 데이터 전처리: LDA로 계산할 데이터 준비
3.5.8 데이터 분석: LDA로 유튜브에서 보이는 편의점 토픽 살펴보기
3.5.9 편의점 제품과 서비스 제안
4장 자연어 분석에 필요한 통계 공부
4.1 자주 사용되는 통계 개념
부록 A GPT-3.5로 자연어 분석하기
부록 B 코랩 시작하기
부록 C GPU 사용 설정하기

