









출고예상일 안내
주문하신 상품이 한국에서 현지 배송을 위한 출고단계가 이루어질 것으로 예상되는 날짜입니다. 상품을 준비하는 과정에서 내부적인 사정으로 인해 출고예상일에 다소 오차가 생길 수 있습니다.
여러 상품(예약상품포함)을 함께 주문하신 경우 출고예상일이 가장 늦은 날짜에 맞춰 함께 배송됩니다.


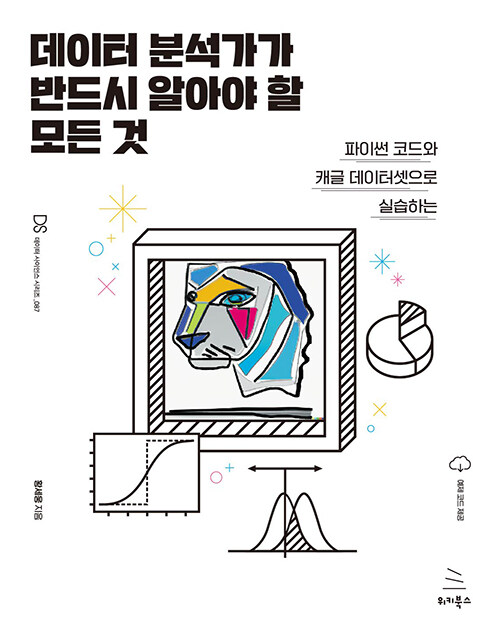





ISBN : 9791158393816 / 636쪽 188 x 240 (㎜)
이 상품에 궁금하신점이 있으세요? 1:1상담문의



아래의 도서와 구매하시면 이 도서들의 적립금을 즉시적용해 드립니다.
-

서길원, 김운호, 허상훈, 박재상, 박경규, 김종욱, 오윤우, 유지영
-
-
제임스 러브록
-
정그린
- 31,500
- 36,000
- 18,900
- 23,400



출판사 리뷰
★ 이 책에서 다루는 내용 ★
◎ 데이터 분석에 필수적인 통계학의 기본 개념
◎ 데이터 편향과 인지적 편향
◎ 비즈니스 문제를 정의하고 데이터 분석의 목적을 도출하는 방법
◎ 데이터 분석 환경 구성
◎ 데이터 탐색과 시각화
◎ 주요 머신러닝 알고리즘과 모델 성능 평가 기법
◎ A/B 테스트와 MAB
이 책의 총서 (70)

-
- 저자 : 황세웅

[1부] 데이터 기초체력 기르기
▣ 1장: 통계학 이해하기
1.1 왜 통계학을 알아야 할까?
1.2 머신러닝과 전통적 통계학의 차이
1.3 통계학의 정의와 기원
1.4 기술 통계화 추론 통계
__1.4.1 기술 통계
__1.4.2 추론 통계
▣ 2장: 모집단과 표본추출
2.1 모집단과 표본, 전수조사와 표본조사
2.2 표본조사를 하는 이유와 데이터과학 적용 방법
2.3 표본추출에서 나타나는 편향의 종류
2.4 인지적 편향의 종류
__2.4.1 확증 편향(confirmation bias)
__2.4.2 기준점 편향(anchoring bias)
__2.4.3 선택 지원 편향(choice-supportive bias)
__2.4.4 분모 편향(denominator bias)
__2.4.5 생존자 편향(survivorship bias)
2.5 머신러닝 모델 측면의 편향과 분산
2.6 표본 편향을 최소화하기 위한 표본 추출 방법
▣ 3장: 변수와 척도
3.1 변수의 종류
3.2 변수 관계의 종류
3.3 척도의 종류
▣ 4장: 데이터의 기술 통계적 측정
4.1 중심 성향의 측정
4.2 분산과 표준편차
4.3 산포도와 범위, 사분위수, 변동계수
4.4 왜도와 첨도
__4.4.1 왜도
__4.4.2 첨도
4.5 표준편차의 경험법칙
▣ 5장: 확률과 확률변수
5.1 확률의 기본 개념
5.2 확률의 종류
5.3 분할과 베이지안 이론
__5.3.1 분할
__5.3.2 베이지안 이론
5.4 확률변수의 개념과 종류
5.5 심슨의 역설
▣ 6장: 확률분포
6.1 확률분포의 정의와 종류
6.2 이산확률분포
__6.2.1 균등분포
__6.2.2 이항분포
__6.2.3 초기하분포
__6.2.4 포아송분포
6.3 연속확률분포
__6.3.1 정규분포
__6.3.2 지수분포
6.4 중심극한정리
[2부] 데이터 분석 준비하기
▣ 7장: 가설검정
7.1 귀무가설과 대립가설
7.2 가설검정의 절차
7.3 가설검정의 유의수준과 p값
7.4 1종 오류와 2종 오류
▣ 8장: 분석 프로젝트 준비 및 기획
8.1 데이터 분석의 전체 프로세스
__8.1.1 데이터 분석의 3단계
__8.1.2 CRISP-DM 방법론
__8.1.3 SAS SEMMA 방법론
8.2 비즈니스 문제 정의와 분석 목적 도출
8.3 분석 목적의 전환
8.4 도메인 지식
8.5 외부 데이터 수집과 크롤링
▣ 9장: 분석 환경 세팅하기
9.1 어떤 데이터 분석 언어를 사용하는 것이 좋을까?
9.2 데이터 처리 프로세스 이해하기
9.3 분산데이터 처리
__9.3.1 HDFS
__9.3.2 아파치 스파크
9.4 테이블 조인과 정의서 그리고 ERD
__9.4.1 테이블 조인
__9.4.2 데이터 단어사전
__9.4.3 테이블 정의서
__9.4.4 ERD
▣ 10장: 데이터 탐색과 시각화
10.1 탐색적 데이터 분석
__10.1.1 엑셀을 활용한 EDA
__10.1.2 탐색적 데이터 분석 실습
10.2 공분산과 상관성 분석
__10.2.1 공분산
__10.2.2 상관계수
__10.2.3 공분산과 상관성 분석 실습
10.3 시간 시각화
__10.3.1 시간 시각화 실습
10.4 비교 시각화
__10.4.1 비교 시각화 실습
10.5 분포 시각화
__10.5.1 분포 시각화 실습
10.6 관계 시각화
__10.6.1 관계 시각화 실습
10.7 공간 시각화
__10.7.1 공간 시각화 실습
10.8 박스 플롯
__10.8.1 박스 플롯 실습
▣ 11장: 데이터 전처리와 파생변수 생성
11.1 결측값 처리
__11.1.1 결측값 처리 실습
11.2 이상치 처리
__11.2.1 이상치 처리 실습
11.3 변수 구간화(Binning)
__11.3.1 변수 구간화 실습
11.4 데이터 표준화와 정규화 스케일링
__11.4.1 데이터 표준화와 정규화 스케일링 실습
11.5 모델 성능 향상을 위한 파생 변수 생성
__11.5.1 파생 변수 생성 실습
11.6 슬라이딩 윈도우 데이터 가공
__11.6.1 슬라이딩 윈도우 실습
11.7 범주형 변수의 가변수 처리
__11.7.1 범주형 변수의 가변수 처리 실습
11.8 클래스 불균형 문제 해결을 위한 언더샘플링과 오버샘플링
__11.8.1 언더샘플링과 오버샘플링 실습
11.9 데이터 거리 측정 방법
__11.9.1 대표적인 거리 측정 방법
__11.9.2 데이터 거리 측정 실습
[3부] 데이터 분석하기
▣ 12장: 통계 기반 분석 방법론
12.1 분석 모델 개요
12.2 주성분 분석(PCA)
__12.2.1 주성분 분석 실습
12.3 공통요인분석(CFA)
__12.3.1 공통요인분석 실습
12.4 다중공선성 해결과 섀플리 밸류 분석
12.5 데이터 마사지와 블라인드 분석
__12.5.1 데이터 마사지
__12.5.2 블라인드 분석
12.6 Z-test와 T-test
__12.6.1 Z-test와 T-test 실습
12.7 ANOVA(Analysis of Variance)
__12.7.1 ANOVA 실습
12.8 카이제곱 검정(교차분석)
__12.8.1 카이제곱 검정 실습
▣ 13장: 머신러닝 분석 방법론
13.1 선형 회귀분석과 Elastic Net(예측모델)
__13.1.1 회귀분석의 기원과 원리
__13.1.2 다항 회귀(Polynomial regression)
__13.1.3 Ridge와 Lasso 그리고 Elastic Net
__13.1.4 선형 회귀분석과 Elastic Net 실습
13.2 로지스틱 회귀분석 (분류 모델)
__13.2.1 로지스틱 회귀분석 실습
13.3 의사결정나무와 랜덤 포레스트(예측/분류 모델)
__13.3.1 분류나무와 회귀나무
__13.3.2 의사결정나무 모델의 장단점
__13.3.3 의사결정나무 모델의 과적합 방지를 위한 방법
__13.3.4 랜덤 포레스트
__13.3.5 의사결정나무와 랜덤 포레스트 실습
13.4 선형 판별분석과 이차 판별분석(분류 모델)
__13.4.1 선형 판별분석
__13.4.2 이차 판별분석
__13.4.3 선형 판별분석과 이차 판별분석 실습
13.5 서포트벡터머신(분류 모델)
__13.5.1 서포트벡터머신 실습
13.6 KNN(분류, 예측 모델)
__13.6.1 KNN 실습
13.7 시계열 분석(예측모델)
__13.7.1 회귀 기반 시계열 분석
__13.7.2 ARIMA 모델
__13.7.3 시계열 분석 실습
13.8 k-means 클러스터링(군집 모델)
__13.8.1 k-means 클러스터링 실습
13.9 연관규칙과 협업 필터링(추천 모델)
__13.9.1 연관 규칙
__13.9.2 콘텐츠 기반 필터링과 협업 필터링
__13.9.3 연관규칙과 협업 필터링 실습
13.10 인공 신경망(CNN, RNN, LSTM)
__13.10.1 CNN
__13.10.2 RNN과 LSTM
__13.10.3 인공 신경망 실습
▣ 14장: 모델 평가
14.1 학습 셋, 검증 셋, 테스트 셋과 과적합 해결
14.2 주요 교차 검증 방법
__14.2.1 k-Fold Cross Validation
__14.2.2 LOOCV(Leave-one-out Cross-validation)
__14.2.3 Stratified K-fold Cross Validation
__14.2.4 Nested Cross Validation
__14.2.5 Grid Search Cross Validation
__14.2.6 주요 교차 검증 방법 실습
14.3 회귀성능 평가지표
__14.3.1 R-Square와 Adjusted R-Square
__14.3.2 RMSE(Root Mean Square Error)
__14.3.3 MAE(Mean Absolute Error)
__14.3.4 MAPE(Mean Absolute Percentage Error)
__14.3.5 RMSLE(Root Mean Square Logarithmic Error)
__14.3.6 AIC와 BIC
__14.3.7 회귀성능 평가지표 실습
14.4 분류, 추천 성능 평가지표
__14.4.1 혼동 행렬
__14.4.2 정확도, 오분류율, 정밀도, 민감도, 특이도 그리고 f-score
__14.4.3 향상도 테이블과 향상도 차트 그리고 향상도 곡선
__14.4.4 ROC 곡선과 AUC
__14.4.5 수익 곡선
__14.4.6 Precision at k, Recall at K 그리고 MAP
__14.4.7 분류, 추천 성능 평가지표 실습
14.5 A/B 테스트와 MAB
__14.5.1 A/B 테스트
__14.5.2 MAB
14.6 유의확률의 함정
14.7 분석가의 주관적 판단과 스토리텔링

