









출고예상일 안내
주문하신 상품이 한국에서 현지 배송을 위한 출고단계가 이루어질 것으로 예상되는 날짜입니다. 상품을 준비하는 과정에서 내부적인 사정으로 인해 출고예상일에 다소 오차가 생길 수 있습니다.
여러 상품(예약상품포함)을 함께 주문하신 경우 출고예상일이 가장 늦은 날짜에 맞춰 함께 배송됩니다.


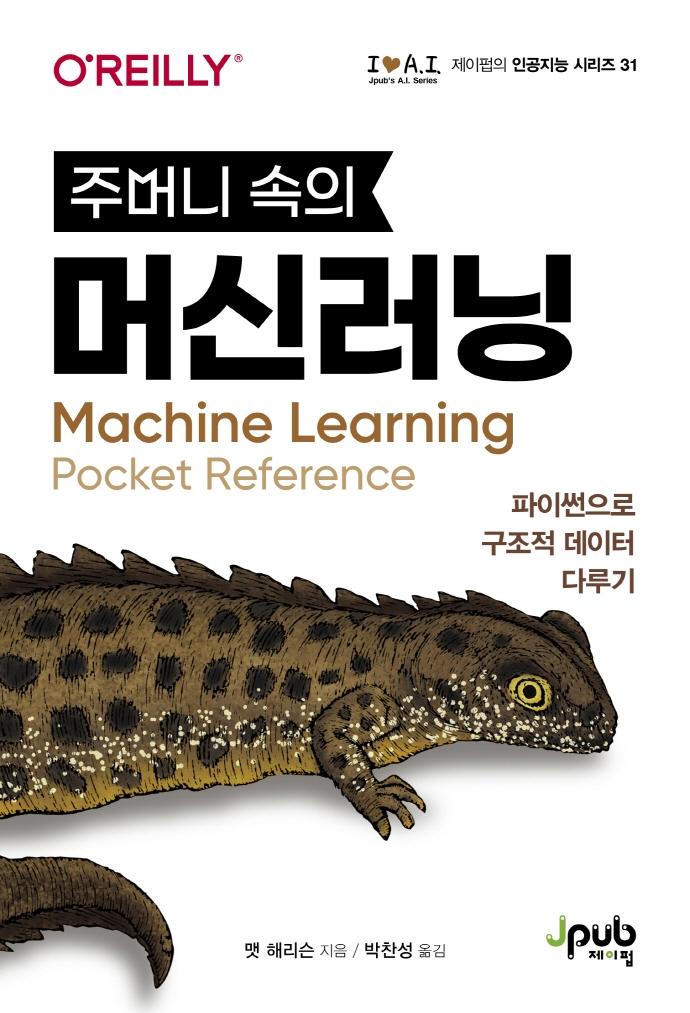
주머니 속의 머신러닝 파이썬으로 구조적 데이터 다루기
원제 : Machine Learning Pocket Reference: Working with Structured Data in Python 1st Ed


- 정가
- $30.00
- 판매가
-
$24.30
(19%↓)

- 적립금
- $0.49 (2%P)
- 출고예상일
- 2026년 10월 08일

- 재고수
- 인터넷(4)



평점 - · 리뷰 0

가능매장 : 목동점


ISBN : 9791191600001 / 332쪽 128 x 188 (㎜)
이 상품에 궁금하신점이 있으세요? 1:1상담문의



아래의 도서와 구매하시면 이 도서들의 적립금을 즉시적용해 드립니다.
-

이와사키 히로마사
-
-
박현규, 김성경
-

클리커, 강민혁
- 15,120
- 17,550
- 21,600
- 23,400



출판사 리뷰
이 책의 특징 머신러닝을 배울 때 참고하며 읽기 좋은 책 도구의 종류, 사용 방법, 각종 파라미터 등을 빠르게 훑으며 기억을 상기할 수 있는 좋은 레퍼런스 자료 머신러닝 모델의 구성 요소, 데이터와 모델의 평가 및 분석을 다양한 도구로 접근해 다각적으로 바라보는 방법을 제시 이 책의 대상 독자 머신러닝에 관심 있는 프로그래머 머신러닝의 방법론을 정립하고 싶은 분 머신러닝의 개념을 다시 한번 정리하고 싶은 분 머신러닝의 다양한 라이브러리와 시각화 방법을 알고 싶은 분

-
- 저자 : 맷 해리슨

-
- 역자 : 박찬성

이 책에서는 다양한 라이브러리를 사용한다. 이는 장점인 동시에 단점일 수 있다. 이들 중 일부는 설치가 까다롭거나 다른 라이브러리 버전과 충돌 문제가 발생할 수 있다. 모든 라이브러리를 설치해야 하는 것은 아니며, 필요한 라이브러리를 상황에 맞게 ‘그때그때 설치’하면 된다. _2p
이번에 다룰 예제에서는 질문에 대답을 하는 예측 모델을 만들고자 한다. 타이타닉호 참사에서의 생존 여부는 탑승객 및 여행의 특징으로 분류할 것이다. 간단한 프로젝트이지만, 여러 모델링 단계를 보여 주는 교육적인 도구로서의 역할을 할 것이다. 우리가 만들 모델은 탑승객의 정보를 입력받아 해당 탑승객이 타이타닉에서 생존했을지를 예측할 수 있어야 한다. 생존했는지 사망했는지, 생존이라는 레이블을 예측하기 때문에 이는 분류 문제다. _13p
이 시점에서 코드를 리팩터링한다. 보통 2개의 함수를 만드는데, 하나는 데이터 정리 작업에 대한 것이고, 다른 하나는 데이터를 학습용과 테스트용으로 분리한 다음 각 데이터셋마다 필요한 다른 변환 처리 작업을 수행하기 위한 것이다. _30p
라드비즈(RadViz) 도표는 각 표본을 원 속에 표현하는데, 원의 둘레 부분에 특징을 표시한다(그림 6-12). 값들은 정규화되어 표현된다. 각 특징마다 표본 값들에 연결된 가상의 실이 있다고 상상해 보자. 그러면 표본들은 값을 기준으로 서로의 특징 방향으로 당겨지는 형태가 된다. 이 도표는 타깃들 사이의 분리 가능성을 시각화하는 한 가지 기법이다. _72p
차원의 저주(curse of dimensionality)는 고려되어야 할 또 다른 문제다. 차원을 증가시키면 증가시킬수록 데이터의 밀도는 점점 더 희박해지며, 근접 계산(neighbor calculation)은 그 유용성을 상실하게 된다. 따라서 밀도의 빈 공간을 채워 넣기 위해서는 더 많은 데이터가 필요하고, 만약 충분한 데이터가 없다면 데이터로부터 신호(signal)을 끄집어내기가 어려워진다. _93p
클러스터링은 그룹을 여러 집단으로 분리하는 데 사용되는 비지도 머신러닝 기법이다. 비지도인 이유는 모델에 주입될 레이블이 없기 때문이다. 단지 특징들의 검사를 통해, 같은 클러스터에 속할 유사한 샘플들을 선별한다. 18장에서는 K-평균(K-means) 및 계층적 클러스터링(hierarchical clustering) 방법을 알아보고, 다양한 기법을 사용하여 타이타닉 데이터셋을 살펴본다. _285p


CHAPTER 1 소개
1.1 사용된 라이브러리 2
1.2 Pip을 이용한 설치 5
1.3 Conda를 이용한 설치 7
CHAPTER 2 머신러닝 과정에 대한 개요
CHAPTER 3 분류 문제 둘러보기: 타이타닉 데이터셋
3.1 프로젝트 구조의 제안 11
3.2 필요한 패키지 12
3.3 질문을 하자 13
3.4 데이터에 관한 용어 14
3.5 데이터의 수집 15
3.6 데이터의 정리 16
3.7 특징의 생성 24
3.8 샘플 데이터 27
3.9 데이터의 대치 27
3.10 데이터의 표준화 29
3.11 리팩터링 30
3.12 베이스라인 모델 31
3.13 다양한 알고리즘 32
3.14 스태킹 34
3.15 모델 만들기 35
3.16 모델의 평가 36
3.17 모델의 최적화 37
3.18 오차 행렬 38
3.19 ROC 곡선 40
3.20 학습 곡선 41
3.21 모델의 배포 42
CHAPTER 4 누락된 데이터
4.1 누락된 데이터의 분석 46
4.2 누락된 데이터의 삭제 50
4.3 데이터의 대치 51
4.4 지시자 열의 추가 52
CHAPTER 5 데이터의 정리
5.1 열의 이름 53
5.2 누락된 값의 교체 54
CHAPTER 6 탐색
6.1 데이터의 크기 57
6.2 요약 통계 58
6.3 히스토그램 59
6.4 산점도 60
6.5 조인트 플롯 61
6.6 쌍 격자 63
6.7 박스 플롯과 바이올린 플롯 65
6.8 두 순서형 값의 비교 66
6.9 상관관계 68
6.10 라드비즈 72
6.11 평행 좌표 74
CHAPTER 7 데이터 전처리
7.1 표준화 77
7.2 범위 조정 79
7.3 더미 변수 80
7.4 레이블 인코더 82
7.5 프리퀀시 인코딩 83
7.6 문자열에서 범주 가져오기 83
7.7 그 밖의 범주형 인코딩 85
7.8 날짜형 데이터의 특징 공학 88
7.9 col_na 특징의 추가 89
7.10 수동적 특징 공학 90
CHAPTER 8 특징의 선택
8.1 공선성을 가진 열 94
8.2 라소 회귀 97
8.3 재귀적 특징 제거 99
8.4 상호 정보량 100
8.5 주성분 분석 102
8.6 특징 중요도 102
CHAPTER 9 불균형 범주의 문제
9.1 다른 평가 지표 사용하기 103
9.2 트리 기반 알고리즘과 앙상블 103
9.3 모델에 페널티 부과하기 104
9.4 소수집단 데이터 업샘플링하기 105
9.5 소수집단 데이터 생성하기 106
9.6 과반수집단 데이터를 다운샘플링하기 106
9.7 업샘플링 후 다운샘플링하기 108
CHAPTER 10 분류
10.1 로지스틱 회귀 111
10.2 나이브 베이즈 116
10.3 서포트 벡터 머신 118
10.4 K-최근접 이웃 122
10.5 디시전 트리 125
10.6 랜덤 포레스트 134
10.7 XGBoost 139
10.8 LightGBM을 사용한 그래디언트 부스팅 150
10.9 TPOT 156
CHAPTER 11 모델 선택
11.1 검증 곡선 161
11.2 학습 곡선 163
CHAPTER 12 분류용 평가 지표로 평가하기
12.1 오차 행렬 165
12.2 평가 지표 168
12.3 정확도 170
12.4 재현율 171
12.5 정밀도 171
12.6 F1 171
12.7 분류 보고서 172
12.8 ROC 173
12.9 정밀도-재현율 곡선 174
12.10 누적 이득 도표 175
12.11 리프트 곡선 177
12.12 범주의 균형 179
12.13 범주 예측 오류 180
12.14 차별 임계치 181
CHAPTER 13 모델 설명
13.1 회귀 계수 183
13.2 특징 중요도 184
13.3 LIME 184
13.4 트리 기반 모델의 해석 186
13.5 부분 의존성 도표 187
13.6 대리 모델 191
13.7 SHAP 192
CHAPTER 14 회귀
14.1 베이스라인 모델 200
14.2 선형 회귀 200
14.3 SVM 204
14.4 K-최근접 이웃 207
14.5 디시전 트리 209
14.6 랜덤 포레스트 216
14.7 XGBoost 회귀 220
14.8 LightGBM 회귀 분석 227
CHAPTER 15 회귀용 평가 지표로 평가하기
15.1 평가 지표 233
15.2 잔차 도표 236
15.3 이분산성 237
15.4 정규 잔차 238
15.5 예측 오차 도표 240
CHAPTER 16 회귀 모델의 해석
16.1 SHAP 243
CHAPTER 17 차원성 감소
17.1 PCA 250
17.2 UMAP 269
17.3 t-SNE 275
17.4 PHATE 279
CHAPTER 18 클러스터링
18.1 K-평균 285
18.2 응집 클러스터링 293
18.3 클러스터의 이해 296
CHAPTER 19 파이프라인
19.1 분류 파이프라인 303
19.2 회귀 파이프라인 306
19.3 PCA 파이프라인 307

