









출고예상일 안내
주문하신 상품이 한국에서 현지 배송을 위한 출고단계가 이루어질 것으로 예상되는 날짜입니다. 상품을 준비하는 과정에서 내부적인 사정으로 인해 출고예상일에 다소 오차가 생길 수 있습니다.
여러 상품(예약상품포함)을 함께 주문하신 경우 출고예상일이 가장 늦은 날짜에 맞춰 함께 배송됩니다.


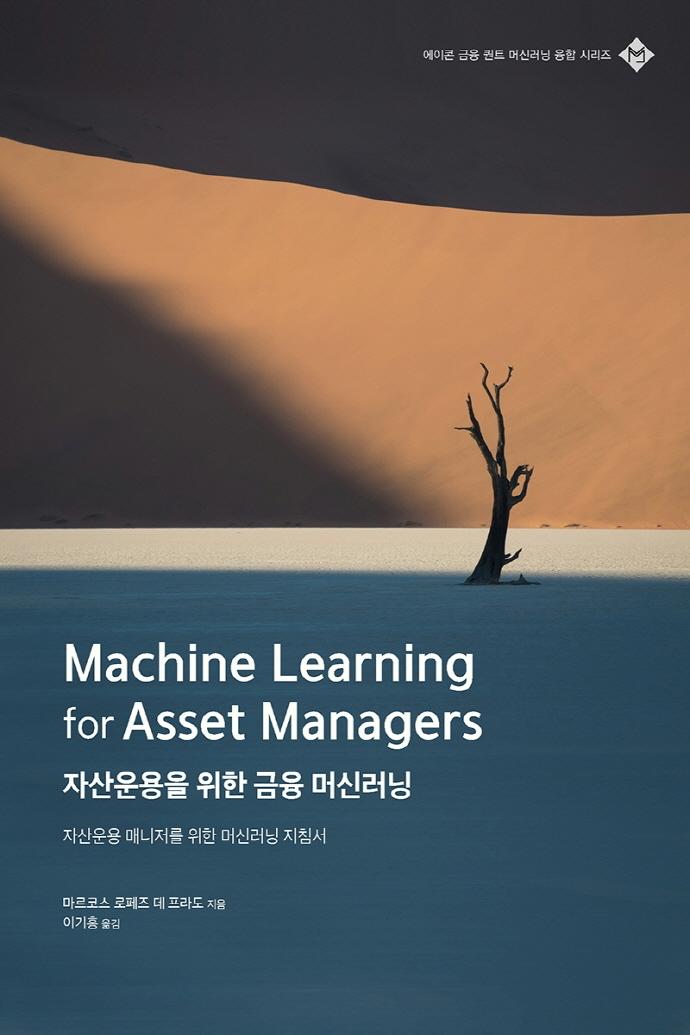





ISBN : 9791161754918 / 208쪽 152 x 228 (㎜)
이 상품에 궁금하신점이 있으세요? 1:1상담문의



아래의 도서와 구매하시면 이 도서들의 적립금을 즉시적용해 드립니다.
-
정지훈
-

서길원, 김운호, 허상훈, 박재상, 박경규, 김종욱, 오윤우, 유지영
-

이와사키 히로마사
-

성구(강성규)
- 25,200
- 31,500
- 15,120
- 21,600


출판사 리뷰


-
- 저자 : 마르코스 로페즈 데 프라도

-
- 역자 : 이기홍

★ 지은이의 말 ★
이 책의 목적은 경제와 금융 이론을 개발하는 데 유용한 머신러닝 도구를 소개하는 것이다. 성공적인 투자 전략은 일반적 이론의 특수한 구현이다. 이론적 정당성이 부족한 투자 전략은 거짓일 가능성이 높다. 따라서 연구자는 잠재적 전략을 백테스트하는 것보다는 이론을 개발하는 데 집중해야만 한다.
머신러닝은 블랙박스도 아니고, 반드시 과적합을 하는 것도 아니다. 머신러닝 도구는 고전적 방법을 대체하기보다는 보완한다. 머신러닝의 강점은 (1) 분산 판정에 앞서는 샘플 외 예측력에의 초점 (2) (잠재적으로 비현실적인) 가정에 의존하는 것을 피하는 계산 방법의 사용 (3) 비선형, 계층적, 고차원 공간에서의 비연속적 상호작용 효과를 포함하는 복잡한 설정을 학습하는 능력 (4) 다중 공선성과 다른 대체 효과에 강건하도록 변수 탐색을 설정 탐색으로부터 분리하는 능력이다.
★ 옮긴이의 말 ★
이 책은 퀀트 금융의 엘리먼트 시리즈를 통해서 로페즈 데 프라도 박사의 이전의 저서 『실전 금융 머신러닝 완벽 분석(Advances in Financial Machine Learning)』을 보완한 책이며, 개념적으로는 자산운용 일반에도 적용할 수 있다. 특히 퀀트 매니저와 퀀트 분석가들에게 지침이 될 수 있는 책이다. 비록 분량은 짧지만 머신러닝의 금융 응용에 대한 저자의 생각을 제시하고 있으며, 『실전 금융 머신러닝 완벽 분석』의 내용을 이해하기 위한 기초 개념을 더 자세히 설명하고 관련된 최근의 연구를 추가했으므로 『실전 금융 머신러닝 완벽 분석』의 자매서로 적극 권장한다.
이 책을 다 읽은 후에 독자들은 정보 이론을 기반으로 하는 거리 개념, 특히 상호 정보 및 정보 변분의 개념, 최적 군집수(ONC), 계층적 군집화를 이용한 상관계수 행렬의 블록화, 추세를 이용한 레이블링, 평균 감소 불순도(MDI), 평균 감소 정확도, 확률 가중 정확도, 계층적 리스크 패리티를 이용한 포트폴리오 구축 및 훈련셋뿐 아니라 테스트셋에서의 과적합 및 거짓 전략 정리 등의 개념에 익숙해질 것이다. 이들 개념은 머신러닝뿐 아니라 향후 금융 연구 및 금융 전략 개발을 수행하는 데 있어서 중요한 토대가 될 것이다. 덧붙이면, 이 책의 개념을 기반으로 『실전 금융 머신러닝 완벽 분석』을 다시 읽어 보면 많은 부분이 하나로 연결돼 완결로 수렴함을 알 수 있을 것이다.
역자는 로페즈 데 프라도 박사가 한때 몸을 담았던 퀀트 펀드인 AQR과 개인적으로 많은 교류를 했는데, 어떻게 보면 가장 스트리트 스마트한 영리적인 투자회사임에도 항상 학계의 새로운 연구와 인물들을 적극 고용하고 협력하는 것에 많은 감명을 받았다. 이러한 문화와 환경에서 로페즈 데 프라도 박사와 같이 금융 실무와 이론을 겸비한 학자가 탄생하는 것은 매우 자연스러운 일인지도 모른다. 우리나라에서도 산학협동이 적극적으로 이뤄져 이런 성격의 사람들이 많이 배출됐으면 하는 소망으로 말을 마친다.


1장. 들어가며
1.1 동기 부여
1.2 이론이 중요하다
1.2.1 교훈1: 이론이 필요하다
1.2.2 교훈2: 머신러닝은 이론을 발견하는 것을 돕는다
1.3 어떻게 과학자들이 머신러닝을 이용하는가
1.4 두 가지 형태의 과적합
1.4.1 훈련셋 과적합
1.4.2 테스트셋 과적합
1.5 개요
1.6 청중
1.7 다섯 가지 만연한 금융 머신러닝에 대한 잘못된 개념
1.7.1 머신러닝은 성배 대 머신러닝은 무용지물
1.7.2 머신러닝은 블랙박스
1.7.3 금융은 머신러닝을 적용하기에는 불충분한 데이터를 갖고 있다
1.7.4 금융에서 신호 대 잡음 비율이 너무 낮다
1.7.5 금융에서 과적합의 위험은 너무 크다
1.8 금융 리서치의 미래
1.9 자주 물어 보는 질문들
1.10 결론
1.11 연습문제
2장. 잡음 제거와 주음 제거
2.1 동기 부여
2.2 마르첸코-파스퇴르 정리
2.3 신호가 있는 랜덤 행렬
2.4 마르첸코-파스퇴르 PDF 적합화
2.5 잡음 제거
2.5.1 상수 잔차 고유값 방법
2.5.2 타깃 축소
2.6 주음 제거
2.7 실험 결과
2.7.1 최소 분산 포트폴리오
2.7.2 최대 샤프 비율 포트폴리오
2.8 결론
2.9 연습문제
3장. 거리 척도
3.1 동기 부여
3.2 상관계수 기반 척도
3.3 한계와 결합 엔트로피
3.4 조건부 엔트로피
3.5 쿨백 - 라이블러 발산
3.6 교차 엔트로피
3.7 상호 정보
3.8 정보 변분
3.9 이산화
3.10 두 분할 간의 거리
3.11 실험 결과
3.11.1 무관계
3.11.2 선형관계
3.11.3 비선형관계
3.12 결론
3.13 연습문제
4장. 최적 군집화
4.1 동기 부여
4.2 근접성 행렬
4.3 군집화 종류
4.4 군집의 수
4.4.1 관측 행렬
4.4.2 기본 군집화
4.4.3 상위 수준 군집화
4.5 실험 결과
4.5.1 랜덤 블록 상관관계 행렬 생성
4.5.2 군집의 수
4.6 결론
4.7 연습문제
5장. 금융 레이블
5.1 동기 부여
5.2 고정 - 기간 방법
5.3 삼중 배리어 방법
5.4 추세 검색 방법
5.5 메타 레이블링
5.5.1 기대 샤프 비율에 의한 베팅 크기
5.5.2 앙상블 베팅 크기
5.6 실험 결과
5.7 결론
5.8 연습문제
6장. 특성 중요도 분석
6.1 동기 부여
6.2 p - 값
6.2.1 p 값의 몇 가지 결함
6.2.2 수치 예제
6.3 특성 중요도
6.3.1 평균 감소 불순도
6.3.2 평균 감소 정확도
6.4 확률 가중 정확도
6.5 대체 효과
6.5.1 직교화
6.5.2 군집 특성 중요도
6.6 실험 결과
6.7 결론
6.8 연습문제
7장. 포트폴리오 구축
7.1 동기 부여
7.2 볼록 포트폴리오 최적화
7.3 조건 수
7.4 마코위츠의 저주
7.5 공분산 불안정성의 원천으로서의 신호
7.6 중첩 군집 최적화 알고리즘
7.6.1 상관 군집화
7.6.2 군집 내 비중
7.6.3 군집 간 비중
7.7 실험 결과
7.7.1 최소 분산 포트폴리오
7.7.2 최대 샤프 비율 포트폴리오
7.8 결론
7.9 연습문제
8장. 테스트셋 과적합
8.1 동기 부여
8.2 정밀도와 재현율
8.3 다중 테스트하의 정밀도와 재현율
8.4 샤프 비율
8.5 '거짓 전략' 정리
8.6 실험 결과
8.7 축소 샤프 비율
8.7.1 유효 시행 수
8.7.2 시행 간 분산
8.8 군별 오차율
8.8.1 시다크 조정
8.8.2 다중 테스트하의 1종 오류
8.8.3 다중 테스트하의 2종 오류
8.8.4 1종과 2종 오류 간의 상호작용
8.9 결론
8.10 연습문제
부록 A. 합성 데이터 테스트
부록 B. '거짓 전략' 정리의 증명

