









출고예상일 안내
주문하신 상품이 한국에서 현지 배송을 위한 출고단계가 이루어질 것으로 예상되는 날짜입니다. 상품을 준비하는 과정에서 내부적인 사정으로 인해 출고예상일에 다소 오차가 생길 수 있습니다.
여러 상품(예약상품포함)을 함께 주문하신 경우 출고예상일이 가장 늦은 날짜에 맞춰 함께 배송됩니다.


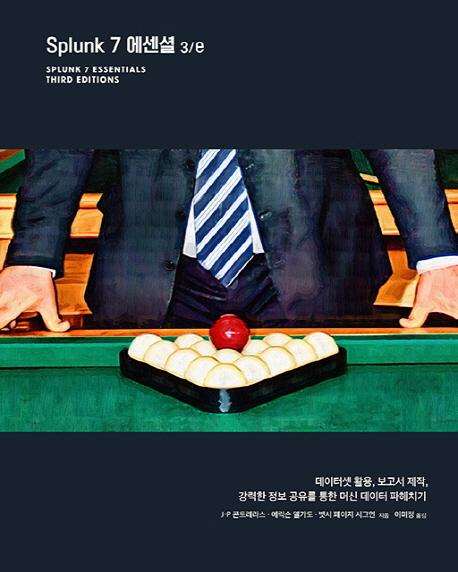
Splunk 7 에센셜 [3/e] 데이터셋 활용, 보고서 제작, 강력한 정보 공유를 통한 머신 데이터 파헤치기
원제 : Splunk 7 Essentials - Third Edition: Demystif
J-P 콘트레라스, 에릭슨 델가도, 벳시 페이지 시그먼 저 | 이미정 역 | 에이콘 | 2019년 05월





ISBN : 9791161752983 / 248쪽 188 x 235 (㎜)
이 상품에 궁금하신점이 있으세요? 1:1상담문의



아래의 도서와 구매하시면 이 도서들의 적립금을 즉시적용해 드립니다.
-

코리아교육그룹 교육연구소
-
오유나 외 14인
-
-

이와사키 히로마사
- 19,800
- 22,500
- 20,700
- 15,120


반디앤루니스 리뷰
스플렁크는 머신 데이터용 검색, 보고, 분석 소프트웨어 플랫폼으로서, 현재 전 세계 여러 기업에 도입돼 데이터에서 가치를 찾는 일에 핵심적으로 사용되고 있다. 이 책은 스플렁크7의 기본 기능을 능숙하게 사용하고자 하는 초보자를 대상으로 한다. 스플렁크에 대한 사전 지식이 없어도 충분히 따라갈 수 있도록 쉽게 서술됐다. 데이터에서 인사이트를 얻고자 하는 데이터/비즈니스 분석가 또는 시스템 관리자를 위한 책이다.
출판사 리뷰
[이 책에서 다루는 내용] - 스플렁크 설치 및 설정 방법 - 스플렁크 인덱스를 사용한 이벤트 데이터 저장, 소스로 이벤트 분류, 데이터 필드 추가 방법 - 스플렁크 검색 처리 언어의 기본 명령어와 모범 사례 - 강력한 실시간 대시보드, 사용자 입력 대시보드 생성 방법 - 경고와 예약 보고서를 통한 주도적 대응 방법 - 페즈의 조언: 스플렁크 기능과 애드온을 활용한 모범 사례 - 조직 단위로 스플렁크 도입 시 보안 및 배포와 관련된 고려 사항 - 스플렁크 온라인 커뮤니티에서 제공하는 풍부한 자료 활용 방법 [이 책의 대상 독자] 스플렁크 7이 제공하는 기능을 능숙하게 사용하고자 하는 초보자를 대상으로 한다. 데이터/비즈니스 분석가나 시스템 관리자가 되고 싶다면, 바로 이 책이 정답이다. 스플렁크에 대한 사전 지식은 필요하지 않다. [이 책의 구성] 1장, '스플렁크 시작하기'에서는 스플렁크를 조직에 도입할 때 필요한 기본 개념을 다룬다. 다양한 스플렁크 커뮤니티와 온라인 에코시스템에 대해 언급한다. 2장, '데이터 가져오기'에서는 포워더(forwarder), 인덱스(index), 이벤트(event), 이벤트 타입(event type), 필드(field), 소스(source), 소스타입(sourcetype)과 같은 필수 개념을 배운다. 3장, '검색 처리 언어'에서는 데이터 분석을 위한 검색 명령어의 사용법을 다룬다. 4장, '보고서, 경고, 검색 최적화'에서는 이벤트 타입을 사용해 데이터를 분류하는 방법과 룩업을 사용해 데이터를 보완하는 방법, 태그로 데이터를 정규화하는 방법을 설명한다. 5장, '동적 대시보드 만들기'에서는 토큰을 검색 패널에 적용하는 방법을 통해 완전한 기능을 갖춘 폼 기반 대시보드(form-based dashboard)를 만들어본다. 이를 통해 입력 내용을 변경하면 대시보드 데이터가 영향을 받도록 만들 수 있다. 6장, '데이터 모델과 피벗'에서는 직관적인 피벗 편집기를 사용해 영역 차트, 원형 차트, 시계열 스파크라인이 포함된 단일값 등 세 가지 시각화 차트를 만들어본다. 7장, 'HTTP 이벤트 수집기'에서는 HTTP 이벤트 수집기(HTTP event collector), HEC에 대해 설명하고, 이를 활용해 애플리케이션에서 스플렁크로 직접 데이터를 전송하는 방법을 알아본다. 8장, '모범 사례 및 고급 쿼리'에서는 고급 스플렁크 사용자를 위한 기술들을 소개한다. 9장, '스플렁크 도입하기'에서는 이제까지 이 책에서 언급한 내용들을 조직에 적용해볼 수 있는 방안에 대해 설명한다.

-
- 저자 : J-P 콘트레라스, 에릭슨 델가도, 벳시 페이지 시그먼

-
- 역자 : 이미정

1장. 스플렁크 시작하기
스플렁크 계정
-스플렁크 계정 생성하기
Windows에 스플렁크 설치하기
Linux에 스플렁크 설치하기
-처음으로 로그인하기
-간단한 검색 실행하기
스플렁크 앱 만들기
Eventgen으로 데이터 생성하기
-CLI로 Eventgen 설정하기
스플렁크 제어하기
Eventgen 설정하기
Destinations 앱 살펴보기
첫 번째 대시보드 만들기
요약
2장. 데이터 가져오기
스플렁크와 빅데이터
-스트리밍 데이터
-분석 데이터 지연
-데이터의 희소성
스플렁크 데이터 소스
-머신 데이터
-웹 로그
-데이터 파일
-소셜 미디어 데이터
-관계형 데이터베이스 데이터
-그 외 데이터 종류
인덱스 생성하기
버킷
로그 파일 입력하기
스플렁크 이벤트와 필드
새로운 필드 추출하기
요약
3장. 검색 처리 언어
검색의 구조
-검색 파이프라인
시간 수정자
검색 결과 필터링하기
검색 명령어 - stats
검색 명령어 - top/rare
검색 명령어 - chart와 timechart
검색 명령어 - eval
검색 명령어 - rex
요약
4장. 보고서, 경고 및 검색 최적화
이벤트 타입을 활용한 데이터 분류
태그를 활용한 데이터 표준화
룩업을 활용한 데이터 보강
보고서 생성과 스케줄링
경고 생성하기
검색과 보고서 가속화
스케줄링 옵션
요약 인덱싱
요약
5장. 동적 대시보드
효과적인 대시보드 만들기
대시보드 종류
-비즈니스 요구사항 파악하기
-동적 폼 기반 대시보드
-패널 옵션
-칼럼 오버레이 조합형 차트 - 조회 대 응답 시간
폼 입력
시간 범위 입력 만들기
라디오 입력 만들기
드롭다운 입력 생성하기
정적 실시간 대시보드
-색상 범위가 있는 단일값 패널
-복제를 통해 패널 생성하기
-추세선이 있는 단일값 패널
-선이 오버레이된 실시간 칼럼 차트
단계구분도 만들기
요약
6장. 데이터 모델과 피벗
데이터 모델 만들기
-객체에 속성 추가하기
-자식 객체 만들기
-정규 표현식을 기반으로 속성 생성하기
데이터 모델 가속화
-피벗 편집기
-피벗과 차트 만들기
-영역 차트 만들기
-원형 차트 만들기
-추세선 스파크라인이 있는 단일값
대시보드 재배치하기
요약
7장. HTTP 이벤트 컬렉터
HEC란?
데이터가 HEC로 전달되는 방법
-데이터 로깅하기
-데이터와 함께 토큰 사용하기
-데이터 요청 보내기
-토큰 검증하기
-데이터 인덱싱하기
요약
8장. 모범사례 및 고급 쿼리
테스트를 위한 인덱스
인덱스 내에서 검색하기
제한된 시간 범위 내에서 검색하기
고속 모드를 통한 빠른 검색
이벤트 샘플링 사용하기
fields 명령어를 사용해 검색 성능 향상시키기
고급 검색
-하위 검색
-append 사용하기
-join 사용하기
-eval 및 if 사용하기
-case 함수와 함께 eval 및 match 사용하기
요약
9장. 스플렁크 도입하기
조직에서 일반적으로 활용되는 사례
-IT 운영
-사이버 보안
-소프트웨어 개발 및 지원 업무
-사물인터넷
스플렁크 아키텍처 고려 사항
-조직에 도입하기 위한 스플렁크 아키텍처
-포워더
-스플렁크 클라우드
-스플렁크 가격 모델
스플렁크 커뮤니티 및 온라인 자료
요약

