









출고예상일 안내
주문하신 상품이 한국에서 현지 배송을 위한 출고단계가 이루어질 것으로 예상되는 날짜입니다. 상품을 준비하는 과정에서 내부적인 사정으로 인해 출고예상일에 다소 오차가 생길 수 있습니다.
여러 상품(예약상품포함)을 함께 주문하신 경우 출고예상일이 가장 늦은 날짜에 맞춰 함께 배송됩니다.


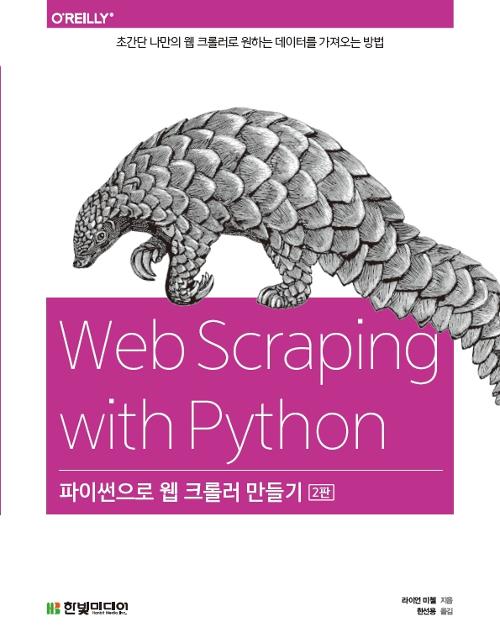
파이썬으로 웹 크롤러 만들기 [2판] 초간단 나만의 웹 크롤러로 원하는 데이터를 가져오는 방법
원제 : Web Scraping with Python, 2nd Edition

- 정가
- $50.00
- 판매가
-
$36.45
(27%↓)

- 적립금
- $0.73 (2%P)
품절된 상품입니다.
이 책을 꼭 원하시는 고객님께서는 아래 "상품문의"를 클릭 후 구매의사를
알려주세요. 책이 확보 될 경우 연락 드리겠습니다.



평점 - · 리뷰 0
ISBN : 9791162241639 / 356쪽 183 x 235 (㎜)
이 상품에 궁금하신점이 있으세요? 1:1상담문의



아래의 도서와 구매하시면 이 도서들의 적립금을 즉시적용해 드립니다.
-
-
빨간고래(박정아)
-
박현규, 김성경
-
제임스 러브록
- 20,700
- 24,300
- 21,600
- 18,900



반디앤루니스 리뷰
웹 어디서든 내가 원하는 데이터를 쏙쏙쏙
웹에 존재한다면 그것이 어떤 형태이든 데이터로 추출할 수 있다. 필요한 무기는 이 책과 파이썬뿐. BeautifulSoup, 셀레니움, 테서랙트 등 강력한 파이썬 라이브러리 사용법과 함께 API, 인증, 이미지 및 텍스트 인식, 로그인 처리 등 웹 크롤링의 기초부터 고급 기법까지 종합적으로 다루는 유일한 책. 실제 업무와 생활에 적용할 수 있는 예제가 가득하다. 2판은 예제를 추가 및 업데이트했고 모던 웹에서 거의 모든 종류의 데이터를 가져오는 방법을 포괄적으로 다룬다.
출판사 리뷰
웹 어디서든 내가 원하는 데이터를 쏙쏙쏙
웹에 존재한다면 그것이 어떤 형태이든 데이터로 추출할 수 있다. 필요한 무기는 이 책과 파이썬뿐. BeautifulSoup, 셀레니움, 테서랙트 등 강력한 파이썬 라이브러리 사용법과 함께 API, 인증, 이미지 및 텍스트 인식, 로그인 처리 등 웹 크롤링의 기초부터 고급 기법까지 종합적으로 다루는 유일한 책. 실제 업무와 생활에 적용할 수 있는 예제가 가득하다. 2판은 예제를 추가 및 업데이트했고 모던 웹에서 거의 모든 종류의 데이터를 가져오는 방법을 포괄적으로 다룬다.
복잡 다양한 웹에서 우아하게 데이터를 수집하는 방법 A to Z
우리는 생활 속의 많은 부분이 인터넷에서 이루어지는 시대에 살고 있습니다. 그 어느 때보다 많은 데이터로 넘쳐나는 웹 세상에서 필요한 데이터를 가져와 분석하는 일의 중요성도 커졌습니다. 인터넷을 활보하며 데이터를 수집하는 프로그램을 웹 크롤러 혹은 웹 스크레이퍼라고 합니다. 웹 크롤러는 데이터 수집을 자동화하므로 비즈니스 의사 결정에 큰 도움이 되고, 웹사이트 스캐너로 활용할 수도 있어 보안 분야에서도 사용됩니다.
웹 크롤링은 인증 같은 웹 기술에 대한 이해는 물론, 데이터 정제, DB 저장 등 여러 기술에 대한 지식이 필요한 분야에 속합니다. 따라서 프로그래밍 스킬을 향상하는 데에 아주 좋은 주제이며, 과거에는 프로그래밍 전문가만이 웹 크롤러를 만들 수 있었습니다. 하지만 파이썬이라는 배우기 쉬운 언어와 쉽게 쓸 수 있는 각종 라이브러리들이 등장하며 이러한 장벽은 무너졌습니다. 기업 사례뿐만 아니라 음원 차트 추출하기, 서울의 기온 데이터 추출하기, 게시판 문서 다운로더 등 주위를 둘러보면 의외로 많은 생활 속 사례를 찾을 수 있습니다.
『파이썬으로 웹 크롤러 만들기(2판)』는 웹 크롤링이라는 주제 하나에 집중하는 책입니다. 업무상 웹 크롤러를 만들다 푹 빠진 나머지 회사를 나와서도 계속 웹 크롤러를 만들고 있는 개발자가 썼습니다. 파이썬과 라이브러리를 이용하여 아주 간단한 웹 크롤러를 만드는 것으로 시작해서, HTML, API 등 웹 기술의 기초부터 데이터 정제 및 저장, 자연어 처리, 이미지 및 텍스트 인식 등 고급 기법까지 종합적으로 살펴봅니다.
책의 1부는 파이썬과 함께 BeautifulSoup, 스크레이피 같은 라이브러리를 이용하여 아주 간단하게 웹 크롤러를 만들어보며 시작합니다. 나아가 API를 이용한 수집, 데이터를 MySQL로 저장하는 방법, CSV, PDF, 워드 파일을 분석하는 방법까지 필요에 따라 다양한 라이브러리를 활용하여 웹 크롤러를 구현하는 방법에 집중합니다. 위키백과를 크롤링하며 '케빈 베이컨의 여섯 다리'(과연 전 세계 사람은 여섯 다리만 거치면 연결될까요?) 문제를 풀어보는 예제도 있습니다.
2부는 웹 크롤링을 둘러싼 더욱 흥미로운 주제와 기법을 다룹니다. 웹에서 가져온 지저분한 데이터를 정돈하고 정제하는 방법(오픈리파인), 자연어 처리(NLTK), 폼과 로그인 뚫기(requests), 자바스크립트로 만든 동적 페이지 수집하기(셀레니움), 이미지 처리(필로) 및 텍스트 인식(테서랙트), 웹사이트 테스트(unittest), 원격 크롤링(토어) 등 고급 기법과 라이브러리 사용법을 살펴봅니다. 특히 텍스트 인식은 CAPTCHA, 즉 자동 가입 방지 문자를 우회하는 데 유용하며, 크롤링을 막는 방해물을 뚫기 위한 '사람처럼 보이기' 기법은 아예 한 장을 할애해서 자세히 소개합니다.
오늘날 데이터가 넘쳐나는 웹에서 웹 크롤러로 할 수 있는 일은 무궁무진합니다. 필요한 것은 약간의 파이썬 프로그래밍 능력 하나뿐입니다. 나머지는 이 책에서 배울 수 있습니다. 웹 크롤링을 적용하여 업무를 자동화하고 생활 속에서 유용한 통찰을 찾는 데 이 책이 큰 도움이 되리라 믿습니다. 복잡 다양한 웹 세상에서 우아하게 데이터를 수집하고 싶은, '일상의 데이터 분석가'를 꿈꾸는 이들에게 이 책을 권합니다.
이 책은 많은 사랑을 받은 1판에 이어 출간된 원서 2판을 기반으로 합니다. 예제를 추가 및 업데이트했고 모던 웹에서 거의 모든 종류의 데이터를 가져오는 방법을 포괄적으로 다룹니다.

-
- 저자 : 라이언 미첼

-
- 역자 : 한선용


Part I 스크레이퍼 제작 CHAPTER 1 첫 번째 웹 스크레이퍼 1.1 연결 1.2 BeautifulSoup 소개 __1.2.1 BeautifulSoup 설치 __1.2.2 BeautifulSoup 실행 __1.2.3 신뢰할 수 있는 연결과 예외 처리 CHAPTER 2 고급 HTML 분석 2.1 닭 잡는 데 소 잡는 칼을 쓸 필요는 없습니다 2.2 다시 BeautifulSoup __2.2.1 find()와 findAll() __2.2.2 다른 BeautifulSoup 객체 __2.2.3 트리 이동 2.3 정규 표현식 2.4 정규 표현식과 BeautifulSoup 2.5 속성에 접근하기 2.6 람다 표현식 CHAPTER 3 크롤링 시작하기 3.1 단일 도메인 내의 이동 3.2 전체 사이트 크롤링 __3.2.1 전체 사이트에서 데이터 수집 3.3 인터넷 크롤링 CHAPTER 4 웹 크롤링 모델 4.1 객체 계획 및 정의 4.2 다양한 웹사이트 레이아웃 다루기 4.3 크롤러 구성 __4.3.1 검색을 통한 사이트 크롤링 __4.3.2 링크를 통한 사이트 크롤링 __4.3.3 여러 페이지 유형 크롤링 4.4 웹 크롤러 모델에 대한 생각 CHAPTER 5 스크레이피 5.1 스크레이피 설치 __5.1.1 새 스파이더 초기화 5.2 간단한 스크레이퍼 작성하기 5.3 규칙에 의한 스파이더링 5.4 항목 만들기 5.5 항목 출력하기 5.6 파이프라인 5.7 스크레이피 로깅 5.8 더 읽을 거리 CHAPTER 6 데이터 저장 6.1 미디어 파일 6.2 데이터를 CSV로 저장 6.3 MySQL __6.3.1 MySQL 설치 __6.3.2 기본 명령어 __6.3.3 파이썬과 통합 __6.3.4 데이터베이스 테크닉과 모범 사례 __6.3.5 여섯 다리와 MySQL 6.4 이메일 Part II 고급 스크레이핑 CHAPTER 7 문서 읽기 7.1 문서 인코딩 7.2 텍스트 __7.2.1 텍스트 인코딩과 인터넷 7.3 CSV __7.3.1 CSV 파일 읽기 7.4 PDF 7.5 마이크로소프트 워드와 .docx CHAPTER 8 지저분한 데이터 정리하기 8.1 코드에서 정리 8.2 사후 정리 __8.2.1 오픈리파인 CHAPTER 9 자연어 읽고 쓰기 9.1 데이터 요약 9.2 마르코프 모델 __9.2.1 위키백과의 여섯 다리: 결론 9.3 자연어 툴킷 __9.3.1 설치 __9.3.2 NLTK를 사용한 통계적 분석 __9.3.3 NLTK를 사용한 사전적 분석 9.4 추가 자료 CHAPTER 10 폼과 로그인 뚫기 10.1 파이썬 requests 라이브러리 10.2 기본적인 폼 전송 10.3 라디오 버튼, 체크박스, 기타 필드 10.4 파일과 이미지 전송 10.5 로그인과 쿠키 처리 __10.5.1 HTTP 기본 접근 인증 10.6 기타 폼 문제 CHAPTER 11 자바스크립트 스크레이핑 __11.1.1 널리 쓰이는 자바스크립트 라이브러리 11.2 Ajax와 DHTML __11.2.1 셀레니움으로 파이썬에서 자바스크립트 실행 __11.2.2 그 밖의 셀레니움 웹드라이버 11.3 리다이렉트 처리 11.4 자바스크립트에 대한 마지막 노트 CHAPTER 12 API를 통한 크롤링 12.1 API에 대한 간단한 소개 __12.1.1 HTTP 메서드와 API __12.1.2 API 응답에 대해 12.2 JSON 파싱 12.3 문서화되지 않은 API __12.3.1 문서화되지 않은 API 찾기 __12.3.2 문서화되지 않은 API 문서화하기 __12.3.3 API 자동으로 찾고 문서화하기 12.4 API와 다른 데이터 소스의 결합 12.5 마치며 CHAPTER 13 이미지 처리와 텍스트 인식 13.1 라이브러리 개관 __13.1.1 필로 __13.1.2 테서랙트 __13.1.3 파이테서랙트 __13.1.4 넘파이 13.2 형식이 일정한 텍스트 처리 __13.2.1 이미지 자동 조정 __13.2.2 웹사이트 이미지에서 텍스트 스크레이핑하기 13.3 CAPTCHA 읽기와 테서랙트 훈련 __13.3.1 테서랙트 훈련 13.4 CAPTCHA 가져오기와 답 보내기 CHAPTER 14 스크레이핑 함정 피하기 14.1 스크레이핑의 윤리에 관해 14.2 사람처럼 보이기 __14.2.1 헤더를 수정하십시오 __14.2.2 쿠키 처리 __14.2.3 타이밍이 가장 중요합니다 14.3 널리 쓰이는 폼 보안 기능 __14.3.1 숨긴 필드 값 __14.3.2 허니팟 피하기 14.4 사람처럼 보이기 위한 체크리스트 CHAPTER 15 스크레이퍼로 웹사이트 테스트하기 15.1 테스트 입문 __15.1.1 단위 테스트란? 15.2 파이썬 unittest __15.2.1 위키백과 테스트 15.3 셀레니움을 사용한 테스트 __15.3.1 사이트 조작 15.4 unittest vs 셀레니움 CHAPTER 16 병렬 웹 크롤링 16.1 프로세스 vs. 스레드 16.2 멀티스레드 크롤링 __16.2.1 경쟁 상태와 큐 __16.2.2 threading 모듈 16.3 멀티프로세스 크롤링 __16.3.1 멀티프로세스 크롤링 __16.3.2 프로세스 간 통신 16.4 멀티프로세스 크롤링의 다른 접근법 CHAPTER 17 원격 스크레이핑 17.1 원격 서버를 쓰는 이유 __17.1.1 IP 주소 차단 방지 __17.1.2 이동성과 확장성 17.2 토어 __17.2.1 파이삭스 17.3 원격 호스팅 __17.3.1 웹사이트 호스팅 계정에서 실행 __17.3.2 클라우드에서 실행 17.4 추가 자료 CHAPTER 18 웹 스크레이핑의 합법성과 윤리 18.1 상표? 저작권? 특허? __18.1.1 저작권법 18.2 동산 침해 18.3 컴퓨터 사기와 악용에 관한 법률 18.4 robots.txt와 이용 약관 18.5 세 가지 웹 스크레이퍼 사례 __18.5.1 이베이 vs. 비더스 에지: 동산 침해 __18.5.2 미국 vs. 오언하이머: 컴퓨터 사기와 악용에 관한 법률 __18.5.3 필드 vs. 구글: 저작권과 robots.txt 18.6 미래를 향해

