









출고예상일 안내
주문하신 상품이 한국에서 현지 배송을 위한 출고단계가 이루어질 것으로 예상되는 날짜입니다. 상품을 준비하는 과정에서 내부적인 사정으로 인해 출고예상일에 다소 오차가 생길 수 있습니다.
여러 상품(예약상품포함)을 함께 주문하신 경우 출고예상일이 가장 늦은 날짜에 맞춰 함께 배송됩니다.


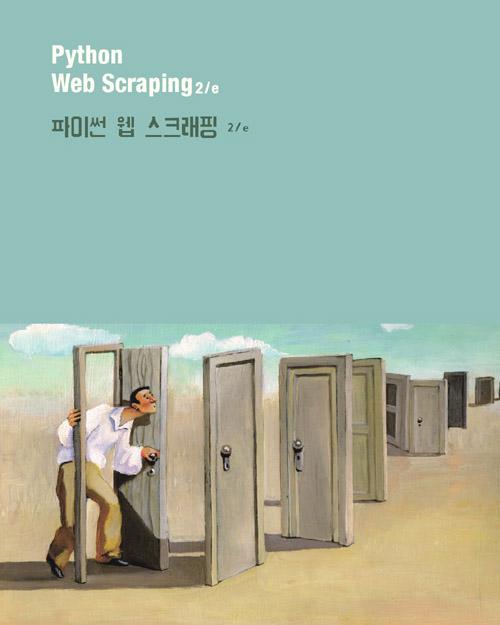
파이썬 웹 스크래핑 [2판] 수많은 데이터 사이에서 필요한 정보 수집하기
원제 : Python Web Scraping, 2/e
캐서린 자멀, 리차드 로손 저 | 김용환 역 | 에이콘출판 | 2019년 01월

- 정가
- $50.00
- 판매가
-
$36.45
(27%↓)

- 적립금
- $0.73 (2%P)
- 출고예상일
- 2026년 10월 08일




이책의 구판 정보
파이썬 웹 스크래핑 - acorn+PACKT 시리즈 리차드 로손 저 | 에이콘출판 | 2017년 04월 [절판]
평점 - · 리뷰 0
ISBN : 9791161752525 / 272쪽 188 x 235 (㎜)
이 상품에 궁금하신점이 있으세요? 1:1상담문의



아래의 도서와 구매하시면 이 도서들의 적립금을 즉시적용해 드립니다.
-
정지훈
-

클리커, 이희영, 강민혁
-

거트루드(박태현)
-

이와사키 히로마사
- 25,200
- 22,500
- 23,400
- 15,120

- 컴퓨터/IT > 프로그래밍 > 기타 프로그래밍 언어

출판사 리뷰
★ 이 책에서 다루는 내용 ★
■ 간단한 파이썬 프로그래밍으로 웹 페이지에서 데이터 추출
■ 병렬로 웹 페이지를 처리할 수 있는 병렬 크롤러 작성
■ 웹 사이트를 크롤링하기 위해 링크 추적
■ HTML에서 특징 추출
■ 재사용하기 위해 다운로드한 HTML 캐싱
■ 가장 빠른 크롤러 결정을 위해 병렬 모델 비교
■ 자바 스크립트 기반 웹 사이트 파싱 방법
■ 폼 및 세션으로 상호 작용하는 방법
★ 이 책의 대상 독자 ★
독자가 이전에 프로그래밍을 해본 경험이 있다는 것을 전제로 작성됐고 프로그래밍을 처음 접하는 초보자에게는 적합하지 않을 가능성이 높다. 웹 스크래핑 예시를 살펴보려면 파이썬에 능숙해야 하고 pip 커맨드를 실행해 모듈을 설치해야 한다.
그리고 웹 페이지가 어떻게 HTML로 작성되는지, 자바 스크립트로 업데이트되는지에 대한 지식이 있다고 가정한다. HTTP, CSS, AJAX, WebKit, Redis에 대해서 알고 있다면 유용할 수 있지만 필수는 아니며 개별 기술이 필요할 때 소개할 것이다.
★ 이 책의 구성 ★
1장, '웹 스크래핑 소개'에서는 웹 스크래핑이 무엇인지와 웹 사이트를 크롤링하는 방법을 소개한다.
2장, '데이터 스크래핑하기'에서는 여러 라이브러리를 사용해 웹 페이지에서 데이터를 추출하는 방법을 설명한다.
3장, '다운로드 캐싱'에서는 결과를 캐싱해 다시 다운로드하지 않는 방법을 설명한다.
4 장, '병렬 다운로드'에서는 웹 사이트를 병렬로 다운로드해 데이터를 빠르게 스크래핑하는 방법을 설명한다.
5장, '동적 콘텐츠'에서는 여러 방법을 통해 동적 웹 사이트에서 데이터를 추출하는 방법을 설명한다.
6장, '폼에서 상호 작용하기'에서는 검색과 로그인할 때 입력과 탐색과 같은 폼에서 어떻게 상호 작용하는지 설명한다.
7장, '캡차 해결하기'에서 캡차 이미지로 보호된 데이터에 접근하는 방법을 설명한다.
8장, 'Scrapy'에서는 빠르게 병렬로 스크래핑할 수 있는 Scrapy 크롤링 스파이더를 사용하는 방법과 웹 스크래퍼를 개발하는 데 도움이 되는 Portia 웹 인터페이스 사용 방법을 설명한다.
9장, '모든 기술 활용하기'에서는 이 책을 통해 알게 된 웹 스크래핑 기술을 활용한다

-
- 저자 : 캐서린 자멀, 리차드 로손

-
- 역자 : 김용환

★ 지은이의 말 ★
인터넷에는 매우 유용한 데이터가 존재한다. 대부분의 데이터는 공개돼 있고 무료로 접근할 수 있다. 그러나 이 데이터는 쉽게 사용할 수 없다. 웹 사이트의 구조와 스타일에 포함돼 있기 때문에 신중하게 추출해야 한다.
웹 스크래핑은 온라인에서 사용할 수 있는 풍부한 정보를 수집한 후 정보를 이해하는 수단으로 점점 더 유용해지고 있다.
이 책은 파이썬 3.7의 최신 기능을 사용해 웹 사이트에서 데이터를 스크래핑할 수 있는 최고의 가이드를 제공한다. 이 책의 초반의 여러 장에서는 정적 웹 페이지에서 데이터를 추출하는 방법을 설명한다. 레디스와 파일을 캐싱으로 사용해 시간을 절약하고 서버의 부하를 관리하는 방법을 배울 것이다.
기본적인 내용을 다룬 후에 브라우저, 크롤러, 병렬 스크래퍼를 사용해 더 정교한 크롤러를 직접 구현해 볼 것이다.
PyQt와 Selenium을 사용해 자바 스크립트를 의존하는 웹 사이트에서 언제 어떻게 데이터를 스크래핑할 수 있는지 결정할 수 있을 것이다. 캡차(CAPTCHA)로 보호되는 복잡한 웹 사이트에 폼을 제출하는 방법에 대해 더 잘 이해할 수 있을 것이다.
또한 Scrapy 라이브러리로 클래스 기반 스크래퍼를 생성하는 방법을 살펴본 후 다뤘던 모든 지식을 활용해 실제 웹 사이트를 대상으로 스크래퍼을 구현할 것이다.
이 책을 다 읽고 나면 스크래퍼, 원격 스크래핑, 모범 사례, 캡차 해결하기, 기타 관련된 많은 주제를 활용해 웹 사이트를 탐험할 수 있을 것이다.
★ 옮긴이의 말 ★
내가 카카오스토리 개발팀에 일할 때 스크래퍼 툴에 이상한 매력을 느꼈다. 스크래퍼 툴을 사용해 웹을 스크래핑할 때 특정 태그 정보와 사진을 추출해서 사용자들이 스크랩 정보를 글을 작성하기 전에 미리 알 수 있게 하는 매력, 왠지 마력처럼 느껴지기도 했다.
도대체 내부는 어떻게 동작하는 걸까? 옆에서 같이 스크래퍼 툴의 코드를 고쳐보기도 하고 이슈가 생기면 동료들과 같이 보기도 했다. 그렇기 때문에 이 책을 번역하게 돼 매우 기뻤다.
우리가 자주 사용하는 SNS(카카오톡, 페이스북, 카카오스토리, 라인)를 살펴보면, 링크를 보낼 때 링크만 보내지 않는다. 적당한 정보와 사진이 같이 대화창 또는 피드에 노출된다.
사실 스크래핑 기술을 알면 쉽게 구현할 수 있지만 스크래핑 기술을 배우고 싶어도 서버 관리자가 스크래핑 기술을 쓰지 못하도록 제한을 거는 경우가 많다. 그래서 이 책은 정말 특별하다. 저자가 운영 중인 예시 웹 사이트를 기반으로 웹 스크래핑 기술을 배울 수 있기 때문에 마음껏 예시를 테스트할 수 있다.
이 책은 크롤링과 스크래핑이 무엇인지 설명하고 법적 이슈를 다루며 시작한다. 웹 사이트에서 데이터를 스크래핑할 수 있는 최고의 가이드를 제공한다. 저자가 운영하는 예시 웹 사이트를 기반으로 스크래핑 테스트를 진행할 수 있다. 정적 웹 페이지에서 데이터를 추출하는 방법, 레디스와 파일을 캐싱으로 사용하는 방법, 동적 스크래핑 및 정교한 크롤러를 개발하는 방법을 다룬다. 그리고 PyQt와 Selenium을 사용하는 방법, 캡차(CAPTCHA)로 보호되는 복잡한 웹 사이트에 폼을 제출하는 방법, 병렬 라이브러리를 사용하는 방법, Scrapy 라이브러리로 클래스 기반 스크래퍼를 생성하는 방법을 다룬다.
이 책은 독자가 파이썬에 대한 기본 지식이 있다고 가정하기 때문에 파이썬 언어에 대한 설명은 없다. 하지만 Golang, 자바, 스칼라 등과 같은 언어에 대한 지식이 있다면 도전해 볼 수 있을 것이다.
원서의 버전은 파이썬 3.4 기준이었지만 번역서에서는 최신 버전인 파이썬 3.7과 바뀐 예시 사이트 URL을 기반으로 예시 소스를 일부 변경했다.
이 책에서 스크래핑에 대한 지식을 많이 얻기를 바란다.

1장. 웹 스크래핑 소개
__웹 스크래핑이 유용한 시점은 언제일까?
__웹 스크래핑은 합법적인가?
__파이썬 3
__웹 사이트 조사
____robots.txt 확인하기
____사이트맵 확인하기
____웹 사이트 규모 추정하기
____웹 사이트에 사용하는 기술을 식별하기
____웹 사이트의 소유자 찾기
__첫 번째 웹 사이트 크롤링하기
____스크래핑과 크롤링
____웹 페이지 다운로드하기
________다운로드 재처리하기
________사용자 에이전트 설정하기
____사이트맵 크롤러
____ID 반복 크롤러
____링크 크롤러
________고급 기능
____requests 라이브러리 사용하기
__정리
2장. 데이터 스크래핑하기
__웹 페이지 분석하기
__웹 페이지를 스크래핑하는 세 가지 방법
____정규식
____Beautiful Soup
____lxml
__CSS 선택자와 브라우저 콘솔
__Xpath Selectors
____LXML 및 패밀리 트리
__성능 비교
__스크래핑 결과
____스크래핑 개요
____링크 크롤러에 스크래핑 콜백 추가하기
__정리
3장. 다운로드 캐싱
__언제 캐싱을 사용할까?
__링크 크롤러에 캐싱 기능 추가하기
__디스크 캐싱
____DiskCache 구현
____캐싱 테스트하기
____디스크 공간 절약하기
____오래된 캐싱 데이터 만료하기
____DiskCache의 단점
__키-값 저장소 캐싱
____키-값 저장소란
____레디스 설치
____레디스 소개
____레디스 캐싱 구현
____압축
____캐싱 테스트
____requests-cache 탐색
__정리
4장. 병렬 다운로드
__100만 웹 페이지
알렉사 목록 파싱
__순차적인 크롤러
__스레드 크롤러
__스레드와 프로세스의 동작 방법
____멀티 스레드 크롤러 구현
____멀티 프로세싱 크롤러
__성능
____파이썬 멀티 프로세싱과 GIL
__정리
5장. 동적 콘텐츠
__동적 웹 페이지의 예
__동적 웹 페이지 리버스 엔지니어링
____엣지 케이스
__동적 웹 페이지 렌더링하기
____PyQt or PySide
________Qt로 디버깅하기
____자바스크립트 실행하기
____웹킷을 사용한 웹 사이트의 상호 작용
________결과 기다리기
__렌더링 클래스
____Selenium
________Selenium과 헤드리스 브라우저
__정리
6장. 폼에서 상호 작용하기
__로그인 폼
____웹 브라우저에서 쿠키를 로드하기
__로그인 스크립트를 확장해 콘텐츠 변경하기
__Selenium으로 폼 자동화하기
__웹 스크래핑을 '인간'이 하는 것처럼 보여주는 방법
__정리
7장. 캡차 해결하기
__계정 등록하기
____캡차 이미지 로딩하기
__광학 문자 인식
____추가 개선 사항
__복잡한 캡차 해결
__캡차 해결 서비스 사용하기
____9kw 시작하기
________9kw 캡차 API
____에러 알림
____등록과 통합하기
__캡차와 머신 러닝
__정리
8장. Scrapy
__Scrapy 설치
__프로젝트 시작하기
____모델 정의하기
____스파이더 생성하기
________설정 튜닝
________스파이더 테스트
__여러 스파이더 타입
__쉘 커맨드로 스크래핑하기
____결과 확인하기
____크롤링 중단과 재개
________Scrapy 성능 튜닝
__Portia를 사용해 시각적으로 스크래핑하기
____설치
____주석
____스파이더 실행하기
____결과 확인하기
__Scrapely로 자동화된 스크래핑
__정리
9장. 모든 기술 활용하기
__구글 검색엔진
__페이스북
____웹 사이트
____페이스북 API
__GAP
__BMW
__정리

