









출고예상일 안내
주문하신 상품이 한국에서 현지 배송을 위한 출고단계가 이루어질 것으로 예상되는 날짜입니다. 상품을 준비하는 과정에서 내부적인 사정으로 인해 출고예상일에 다소 오차가 생길 수 있습니다.
여러 상품(예약상품포함)을 함께 주문하신 경우 출고예상일이 가장 늦은 날짜에 맞춰 함께 배송됩니다.


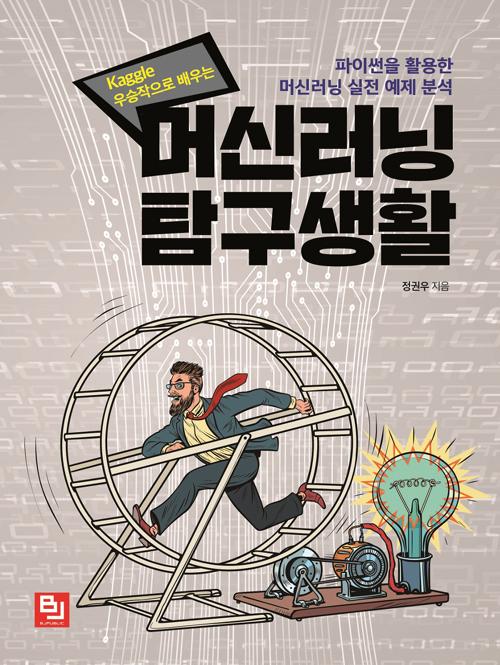





ISBN : 9791186697696 / 416쪽 173 x 230 (㎜)
이 상품에 궁금하신점이 있으세요? 1:1상담문의



아래의 도서와 구매하시면 이 도서들의 적립금을 즉시적용해 드립니다.
-

성구(강성규)
-
김현철, 신은경, 이민정, 박선우, 정기민, 곽소아, 정문수
-
-

이와사키 히로마사
- 21,600
- 21,420
- 21,600
- 15,120



출판사 리뷰
파이썬을 활용한 머신러닝 실전 예제 분석
이 책은 과거 캐글 경진대회에서 제공된 실제 데이터를 다룬다. 머신러닝을 시작하기 위하여 두껍고 어려운 선형대수, 미적분, 통계 책을 읽기 시작하여 고통받고 있는 독자를 위하여, 이 책은 더 재미있고 피부에 와닿는 실제 경진대회를 통해 머신러닝을 배울 수 있도록 돕고자 한다.
먼저, 경진대회에 출제된 문제를 올바르게 이해하고, 데이터 시각화 과정을 통해 데이터에 대한 이해를 쌓아간다. 그리고 높은 순위를 기록한 상위 입상자의 코드를 직접 분석하고 피쳐 엔지니어링, 모델 튜닝, 교차 검증 기법을 독자가 직접 재현할 수 있도록 돕는다. 이 책을 통해 독자는 \"성공적인 머신러닝 파이프라인\"이 무엇인지를 배우게 될 것이다.
이 책의 특징
- 캐글 경진대회 상위 입상자의 코드를 한 땀 한 땀 분석한다.
- 실제 업계에서 사용하는 Tabular 데이터, 이미지 데이터, 텍스트 데이터, 음성 데이터를 직접 다룬다.
- 최신 머신러닝 모델(XGBoost, LightGBM, CatBoost, PyTorch)을 사용해본다.
독자대상
초중급
소스코드 다운로드
https://github.com/bjpublic/kaggleml
캐글은 2010년에 설립된 머신러닝 경진대회 플랫폼이다. 기업과 연계하여 주최되는 경진대회를 통해 머신러닝 문제와 데이터가 제공되면, 캐글에 가입한 데이터 분석가, 통계학자, 머신러닝 엔지니어 등의 개개인이 모여 가장 높은 점수를 내기 위해 경쟁하는 구조이다. 기업은 우승자의 코드와 분석 기법을 토대로 기업이 보유한 내부 머신러닝 알고리즘을 고도화할 수 있는 기회를 얻게 되고, 개인들은 평소에 접할 수 없는 데이터를 직접 다루는 기회를 얻으며, 상위 입상 시 고액의 상금을 얻는다.
아마존, 페이스북, 구글 등 모두가 아는 IT 기업들도 캐글에 경진대회를 개최한 경험이 있다. 세계 최고 수준의 머신러닝 알고리즘을 구현하는 기업, 구글 딥마인드에서도 파이썬을 활용한 캐글 경진대회에서 우수한 성적을 거두면 자연스럽게 쌓아갈 수 있는 풍부한 경험과 지식을 채용 1순위 기준으로 삼고 있다. 이 책은 전세계에서 인정받을 수 있는 머신러닝 엔지니어 업무를 커리어로 삼고 싶은 독자들을 위한 책이다.

-
- 저자 : 정권우

1장 파이썬과 머신러닝 그리고 캐글
1.1 왜 파이썬인가
1.2 왜 캐글인가?
1.3 캐글을 시작하는 방법
1.4 경진대회에 통하는 실질적인 팁
1.5 경진대회 선별 기준
2장 산탄데르 제품 추천 경진대회
2.1 경진대회 소개
2.2 경진대회 주최자의 동기
2.3 평가 척도
2.4 주요 접근
2.5 데이터 준비하기
2.6 탐색적 데이터 분석
2.7 Baseline 모델
2.8 승자의 지혜 - 8등 소스코드 분석
2.9 승자의 지혜
3장 텐서플로 음성 인식 경진대회
3.1 경진대회 소개
3.2 경진대회 주최자의 동기
3.3 평가 척도
3.4 주요 접근
3.5 데이터 준비하기
3.6 탐색적 데이터 분석
3.7 Baseline 모델
3.8 승자의 지혜 - 3등 소스코드 분석
3.9 승자의 지혜
4장 포르토 세구로 안전 운전자 예측 경진대회
4.1 경진대회 소개
4.2 경진대회 주최자의 동기
4.3 평가 척도
4.4 주요 접근
4.5 데이터 준비하기
4.6 탐색적 데이터 분석
4.7 Baseline 모델
4.8 승자의 지혜 - 2등 소스코드 분석
4.9 승자의 지혜
5장 스테이트 팜 산만한 운전자 감지 경진대회
5.1 경진대회 소개
5.2 경진대회 주최자의 동기
5.3 평가 척도
5.4 주요 접근
5.5 데이터 준비하기
5.6 탐색적 데이터 분석
5.7 Baseline 모델
5.8 성능 개선 실험
5.9 승자의 지혜

