









출고예상일 안내
주문하신 상품이 한국에서 현지 배송을 위한 출고단계가 이루어질 것으로 예상되는 날짜입니다. 상품을 준비하는 과정에서 내부적인 사정으로 인해 출고예상일에 다소 오차가 생길 수 있습니다.
여러 상품(예약상품포함)을 함께 주문하신 경우 출고예상일이 가장 늦은 날짜에 맞춰 함께 배송됩니다.


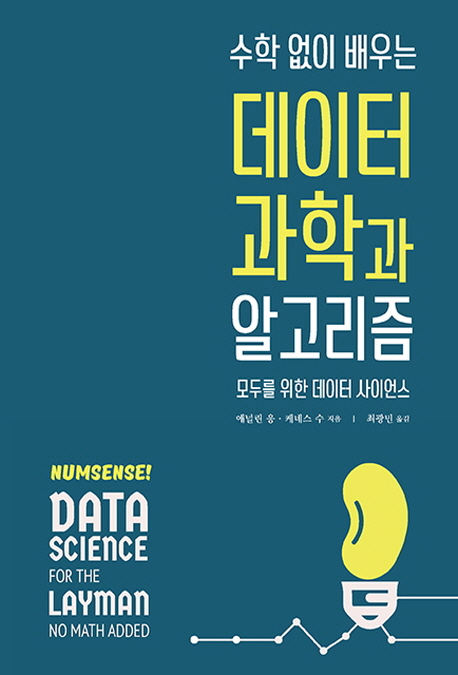
수학 없이 배우는 데이터 과학과 알고리즘 모두를 위한 데이터 사이언스
원제 : Numsense! Data Science for the Layman: No Math Added
시리즈 :
에이콘 데이터 과학 시리즈
[54]
애널린 응, 케네스 수 저 | 최광민 역 | 에이콘출판 | 2018년 01월

- 정가
- $27.60
- 판매가
-
$20.12
(27%↓)

- 적립금
- $0.40 (2%P)
품절된 상품입니다.
이 책을 꼭 원하시는 고객님께서는 아래 "상품문의"를 클릭 후 구매의사를
알려주세요. 책이 확보 될 경우 연락 드리겠습니다.



평점 - · 리뷰 0
ISBN : 9791161750798 / 172쪽 153 x 224 (㎜)
이 상품에 궁금하신점이 있으세요? 1:1상담문의



아래의 도서와 구매하시면 이 도서들의 적립금을 즉시적용해 드립니다.
-

성구(강성규)
-
장세림
-
-
제임스 러브록
- 21,600
- 21,600
- 26,100
- 18,900



- [시리즈] 에이콘 데이터 과학 시리즈 [54]

출판사 리뷰
★ 이 책에서 다루는 내용 ★
데이터 과학과 그에 포함된 알고리즘을 보통 사람들의 언어로 소개한다(이 책에 수학은 없다). 핵심 개념을 이해할 수 있도록 직관적인 설명과 많은 시각 자료를 사용할 것이다.
알고리즘마다 한 장을 할애해 실제 예제로 알고리즘의 동작 원리를 설명한다. 예제에서 사용한 데이터는 온라인에서 확인할 수 있으며, 출처는 참고문헌에서 볼 수 있다.
배운 내용을 복습하고 싶다면 각 장의 끝에 있는 요약을 확인하자. 책의 끝부분에서는 각 알고리즘의 장단점을 간략히 요약한 참고자료를 볼 수 있고, 일반적으로 사용하...
★ 이 책에서 다루는 내용 ★
데이터 과학과 그에 포함된 알고리즘을 보통 사람들의 언어로 소개한다(이 책에 수학은 없다). 핵심 개념을 이해할 수 있도록 직관적인 설명과 많은 시각 자료를 사용할 것이다.
알고리즘마다 한 장을 할애해 실제 예제로 알고리즘의 동작 원리를 설명한다. 예제에서 사용한 데이터는 온라인에서 확인할 수 있으며, 출처는 참고문헌에서 볼 수 있다.
배운 내용을 복습하고 싶다면 각 장의 끝에 있는 요약을 확인하자. 책의 끝부분에서는 각 알고리즘의 장단점을 간략히 요약한 참고자료를 볼 수 있고, 일반적으로 사용하는 용어들을 포함하는 용어집도 볼 수 있다.
이 책을 바탕으로 데이터 과학에 대한 실용적인 이해를 얻고, 그 강점을 이용해 더 나은 의사결정을 할 수 있길 바란다.
★ 이 책의 대상 독자 ★
데이터 과학과 그 원동력이 되는 알고리즘에 입문하고 싶은 초심자에게 적극 추천한다

-
- 저자 : 애널린 응, 케네스 수

-
- 역자 : 최광민

★ 지은이의 말 ★
날이 갈수록 업무에서의 의사결정에 데이터 과학을 많이 사용하고 있지만, 많은 사람들이 데이터 과학을 제대로 알지 못하고 있다. 이것이 바로 우리가 만든 튜토리얼을 책으로 엮는 이유다. 배움에 목마른 학생들과 현업에서 일하는 기업의 전문가, 호기심 많은 누군가를 포함한 더 많은 사람들에게 배움의 기회를 주기 위해.
각 튜토리얼은 수학과 전문 용어에 구애 받지 않고 데이터 과학 분야의 기술에 있어 중요한 기능과 가정들을 다룬다. 그리고 실제 데이터와 예제를 바탕으로 이러한 기술들을 설명한다.
★ 옮긴이의 말 ★
말 그대로 데이터의 시대가 왔다. 데이터가 곧 돈이요, 가치 있는 데이터를 확보한 기업이 미래의 주도권을 잡는 세상이 된 것이다. 누구나 데이터를 말하고, 데이터 과학을 이야기한다. 그만큼 데이터를 다룰 줄 알고, 데이터로부터 원하는 정보를 이끌어낼 수 있는 사람이 필요한 세상이다.
그러나 비전공자에게 데이터 과학이란 말은 어렵게 느껴질 뿐이다. 많은 사람들이 데이터를 분석하는 일에 흥미를 가지고 있지만 어디서, 어떻게, 무엇부터 시작해야 할지 갈피를 잡기 어렵다. 전문적인 분석가를 목표로 하는 사람이 아니더라도 데이터 과학이 무엇이고, 어떤 과정으로 이뤄지는지 궁금해 한다.
이 책은 이처럼 데이터 과학을 처음 시작하는 사람들이 주로 사용하는 분석 기법과 핵심적인 머신 러닝 알고리즘의 원리를 실제 데이터를 바탕으로 설명하고 있다. 구체적인 코드나 세세한 수학적 내용으로 독자를 힘들게 하기보다 알고리즘의 동작 원리와 장단점을 제시함으로써 데이터 과학을 처음 시작하는 비전공자나 데이터 과학이 무엇인지 궁금한 독자에게 훌륭한 출발점을 제공한다. 부디 이 책이 데이터 과학을 시작하고자 하는 모두에게 좋은 길잡이가 되길 바란다.


1장. 기초 훑어보기
__1.1 데이터 준비
____데이터 포맷
____변수 타입
____변수 선택
____특징 엔지니어링
____누락된 데이터
__1.2 알고리즘 선택
____비지도학습
____지도학습
____강화 학습
____이 밖에 고려해야 할 점
__1.3 파라미터 튜닝
__1.4 결과 평가하기
____분류 지표
____회귀 지표
____검증
__1.5 요약
2장. 평균 군집화
__2.1 고객 군집 찾기
__2.2 예제: 영화 팬들의 성향 프로필
__2.3 군집 정의하기
____얼마나 많은 군집이 존재하는가?
____군집의 포함 관계는 어떤가?
__2.4 제약
__2.5 요약
3장. 주성분 분석
__3.1 식품의 영양 성분 파악
__3.2 주성분
__3.3 예제: 식품 그룹 분석
__3.4 제약
__3.5 요약
4장. 연관 규칙
__4.1 구매 패턴 발견하기
__4.2 지지도와 신뢰도, 향상도
__4.3 예제: 식료품 거래 분석
__4.4 Apriori 원칙
____지지도가 높은 품목 집합 찾기
____신뢰도나 향상도가 높은 품목 규칙 찾기
__4.5 제약
__4.6 요약
5장. 소셜 네트워크 분석
__5.1 관계 매핑하기
__5.2 예제: 무기 거래로 엿보는 지정학
__5.3 루뱅 메서드
__5.4 페이지랭크 알고리즘
__5.5 제약
__5.6 요약
6장. 회귀 분석
__6.1 추세선 찾기
__6.2 예제: 주택 가격 예측
__6.3 기울기 하강법
__6.4 회귀 계수
__6.5 상관 계수
__6.6 제약
__6.7 요약
7장. k-최근접 이웃과 이상 감지
__7.1 식품 감별
__7.2 유유상종
__7.3 예제: 와인의 차이 알아내기
__7.4 이상 감지
__7.5 제약
__7.6 요약
8장. 서포트 벡터 머신
__8.1 “아니요”냐, “절대 아니요!”냐?
__8.2 예제: 심장병 예측
__8.3 최적 경계 그리기
__8.4 제약
__8.5 요약
9장. 의사결정 트리
__9.1 재앙에서 살아남을지 예측하기
__9.2 예제: 타이타닉 탈출하기
__9.4 제약
__9.5 요약
10장. Random Forests
__10.1 대중의 지혜
__10.2 예제: 범죄 예측
__10.3 앙상블
__10.4 부트스트랩 집계
__10.5 제약
__10.6 요약
11장. 신경망
__11.1 두뇌 흉내 내기
__11.2 예제: 수기 숫자 인식
__11.3 신경망의 구성 요소
__11.4 활성화 규칙
__11.5 제약
__11.6 요약
12장. A/B 테스트와 멀티 암드 밴딧
__12.1 A/B 테스트의 기초
__12.2 A/B 테스트의 제약
__12.3 입실론 감소 전략
__12.4 예제: 멀티 암드 밴딧
__12.5 ‘승자 고집하기’에 얽힌 재밌는 사연
__12.6 입실론 감소 전략의 제약
__12.7 요약
부록
__A. 지도학습 알고리즘 개요
__B. 지도학습 알고리즘 개요
__C. 튜닝 파라미터 목록
__D. 다양한 평가 지표
____분류 지표
____회귀 지표

