









출고예상일 안내
주문하신 상품이 한국에서 현지 배송을 위한 출고단계가 이루어질 것으로 예상되는 날짜입니다. 상품을 준비하는 과정에서 내부적인 사정으로 인해 출고예상일에 다소 오차가 생길 수 있습니다.
여러 상품(예약상품포함)을 함께 주문하신 경우 출고예상일이 가장 늦은 날짜에 맞춰 함께 배송됩니다.


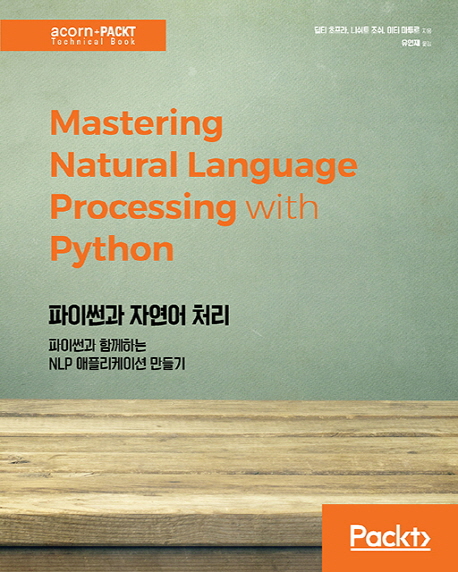
파이썬과 자연어 처리 - acorn+PACKT 시리즈 파이썬과 함께하는 NLP 애플리케이션 만들기
원제 : Mastering Natural Language Processing with Python
딥티 초프라, 니쉬트 조쉬, 이티 마투르 저 | 유연재 역 | 에이콘출판 | 2017년 07월





ISBN : 9791161750255 / 320쪽 190 x 236 (㎜)
이 상품에 궁금하신점이 있으세요? 1:1상담문의



아래의 도서와 구매하시면 이 도서들의 적립금을 즉시적용해 드립니다.
-

성구(강성규)
-
-

클리커, 강민혁
-

이와사키 히로마사
- 21,600
- 21,600
- 23,400
- 15,120



출판사 리뷰
★ 이 책에서 다루는 내용 ★ ■ 문자열 매칭 알고리즘 및 정규화 기술 구현 ■ 통계 언어 모델링 기법 구현 ■ 스테머, 원형화기, 형태소 생성기 개발에 대한 통찰력 습득 ■ 검색 엔진 개발, n-gram 접근법과 관련된 POS 태깅 개념 및 통계 모델링 개념 구현 ■ 트리뱅크(Treebank) 구조, CFG 생성, CYK 차트 파싱 알고리즘 및 Earley 차트 파싱 알고리즘 개념 습득 ■ NER 기반 시스템 개발과 감정 분석의 개념 이해 및 적용 ■ 정보 검색 및 텍스트 요약의 개념 이해 및 구현 ■ 담화 분석 시... ★ 이 책에서 다루는 내용 ★ ■ 문자열 매칭 알고리즘 및 정규화 기술 구현 ■ 통계 언어 모델링 기법 구현 ■ 스테머, 원형화기, 형태소 생성기 개발에 대한 통찰력 습득 ■ 검색 엔진 개발, n-gram 접근법과 관련된 POS 태깅 개념 및 통계 모델링 개념 구현 ■ 트리뱅크(Treebank) 구조, CFG 생성, CYK 차트 파싱 알고리즘 및 Earley 차트 파싱 알고리즘 개념 습득 ■ NER 기반 시스템 개발과 감정 분석의 개념 이해 및 적용 ■ 정보 검색 및 텍스트 요약의 개념 이해 및 구현 ■ 담화 분석 시스템 및 대용어 복원(anaphora resolution) 기반 시스템 개발 ★ 이 책의 대상 독자 ★ 합리적인 지식 수준과 파이썬에 대한 이해를 바탕으로 NLP 중급 개발자를 대상으로 한다. ★ 이 책의 구성 ★ 1장, ‘문자열을 사용한 작업’에서는 토큰화와 정규화 같은 텍스트에 대한 사전 처리 작업을 수행하는 방법과 다양한 문자열 매칭 방법을 설명한다. 2장, ‘통계 언어 모델링’에서는 단어 빈도를 계산하고 다양한 언어 모델링 기법을 수행하는 방법을 다룬다. 3장, ‘형태학 ? 시작하다’에서는 스테머, 형태소 분석기 및 형태소 생성기 개발 방법을 다룬다. 4장, ‘품사 태깅 - 단어 식별’에서는 품사 태깅 및 n-gram 접근법을 포함한 통계 모델링을 다룬다. 5장, ‘파싱 - 훈련 데이터 분석’에서는 트리 뱅크 구성, CFG 구성, CYK 알고리즘, 차트 파싱 알고리즘 및 음역의 개념에 대한 정보를 살펴본다. 6장, ‘의미 분석 ? 본질 표현’에서는 얕은 의미 분석과 WordNet을 사용하는 WSD의 개념과 애플리케이션에 대해 살펴본다. 7장, ‘감정 분석 ? 나는 행복하다’에서는 감정 분석의 개념을 이해하고 적용하는 데 도움이 되는 정보를 제공한다. 8장, ‘정보 검색 - 정보 접속’에서는 정보 검색 및 텍스트 요약의 개념을 이해하고 적용한다. 9장, ‘담화 분석 - 아는 것은 믿는 것이다’에서는 담화 분석 시스템과 대용어 복원 기반 시스템을 개발한다. 10장, ‘NLP 시스템의 평가 - 성능 분석’에서는 NLP 시스템을 평가하는 개념을 이해하고 적용하는 방법에 대해 살펴본다. ★ 옮긴이의 말 ★ 파이썬은 네덜란드 개발자 귀도 반 로섬(Guido van Rossum)이 만든 프로그래밍 언어 중 하나다. 파이썬은 문법이 복잡하지 않고 쉬워서 초보자들도 쉽게 다가갈 수 있는 인터프리터 프로그래밍 언어다. 하지만 우리나라의 경우 C, JAVA 중심의 프로그래밍 환경이 대중적이라서 파이썬 같은 그 외의 프로그래밍 언어는 접해볼 수 있는 기회가 적다. 심지어 10년 넘게 프로그래머 개발자로 근무한 나의 경우에도 파이썬을 접한 것은 불과 수 년 전이었다. 파이썬은 미국에서 교육용 프로그래밍 언어로 사용하면서 점차 세계적으로 인기를 얻기 시작했고 파이썬을 사용하는 기업과 프로그래머도 증가했다. 이제 국내 대학에서도 교양 수업으로 파이썬을 채택하고 있다. 또한 수많은 라이브러리의 제공으로 자연어 처리, 머신 러닝 등의 분야에서 파이썬을 사용하고 있다. 이 책은 파이썬을 이용한 자연어 처리(NLP)를 다룬다. 자연 언어는 최근에 새롭게 등장한 개념이 아니다. 예전부터 연구됐던 인공지능의 한 분야다. 자연 언어라는 개념이 생소한 독자들은 내용을 이해하는 데 약간의 어려움도 있을 것이다. 개인적으로는 이 책을 살펴보기 전에 학창 시절 배웠던 문장 및 언어의 기본 구조를 살펴보는 것을 추천한다. 이 책을 이해하는 데 많은 도움이 될 것이다. 또한 파이썬 기본서가 아니기에 파이썬에 대한 기본 지식이 있는 독자를 대상으로 한다. 독자들은 이 책으로 문자열 매칭, 알고리즘 및 정규화 기술 구현, 스테머, 검색 엔진 개발, 담화 분석 등을 다양한 예제와 함께 살펴보면서 점점 능숙하게 자연 언어를 처리하는 자신을 발견할 수 있을 것이다.

-
- 구분 : 저서
- 이름 : 딥티 초프라
- 국적 : 기타
- 직업 :
- 분류 : 기타
- 인기지수 [16]
-


- [최근저서]전체보기
- 파이썬과 자연어 처리 - a...
-
- 구분 : 저서
- 이름 : 니쉬트 조쉬
- 국적 : 기타
- 직업 :
- 분류 : 기타
- 인기지수 [16]
-
- [최근저서]전체보기
- 파이썬과 자연어 처리 - a...
-
- 구분 : 저서
- 이름 : 이티 마투르
- 국적 : 기타
- 직업 :
- 분류 : 기타
- 인기지수 [16]
-
- [최근저서]전체보기
- 파이썬과 자연어 처리 - a...

-
- 이름 : 유연재
- 국적 : 대한민국
- 직업 :
- 분류 : 기타
- 인기지수 [22]
-

★ 지은이의 말 ★
파이썬에서 다양한 NLP 작업을 구현하는 방법과 NLP의 최신 연구 주제에 대한 통찰력을 얻을 수 있다. 학생과 연구원이 실제 애플리케이션을 기반으로 자신의 프로젝트를 생성하는 데 도움이 되는 포괄적인 단계별 안내서다.
★ 옮긴이의 말 ★
파이썬은 네덜란드 개발자 귀도 반 로섬(Guido van Rossum)이 만든 프로그래밍 언어 중 하나다. 파이썬은 문법이 복잡하지 않고 쉬워서 초보자들도 쉽게 다가갈 수 있는 인터프리터 프로그래밍 언어다. 하지만 우리나라의 경우 C, JAVA 중심의 프로그래밍 환경이 대중적이라서 파이썬 같은 그 외의 프로그래밍 언어는 접해볼 수 있는 기회가 적다. 심지어 10년 넘게 프로그래머 개발자로 근무한 나의 경우에도 파이썬을 접한 것은 불과 수 년 전이었다.
파이썬은 미국에서 교육용 프로그래밍 언어로 사용하면서 점차 세계적으로 인기를 얻기 시작했고 파이썬을 사용하는 기업과 프로그래머도 증가했다. 이제 국내 대학에서도 교양 수업으로 파이썬을 채택하고 있다. 또한 수많은 라이브러리의 제공으로 자연어 처리, 머신 러닝 등의 분야에서 파이썬을 사용하고 있다.
이 책은 파이썬을 이용한 자연어 처리(NLP)를 다룬다. 자연 언어는 최근에 새롭게 등장한 개념이 아니다. 예전부터 연구됐던 인공지능의 한 분야다. 자연 언어라는 개념이 생소한 독자들은 내용을 이해하는 데 약간의 어려움도 있을 것이다. 개인적으로는 이 책을 살펴보기 전에 학창 시절 배웠던 문장 및 언어의 기본 구조를 살펴보는 것을 추천한다. 이 책을 이해하는 데 많은 도움이 될 것이다. 또한 파이썬 기본서가 아니기에 파이썬에 대한 기본 지식이 있는 독자를 대상으로 한다. 독자들은 이 책으로 문자열 매칭, 알고리즘 및 정규화 기술 구현, 스테머, 검색 엔진 개발, 담화 분석 등을 다양한 예제와 함께 살펴보면서 점점 능숙하게 자연 언어를 처리하는 자신을 발견할 수 있을 것이다.

1장. 문자열을 사용한 작업
__토큰화
____텍스트를 문장으로 토큰화
____다양한 언어의 텍스트 토큰화
____문장을 단어로 토큰화
____TreebankWordTokenizer를 사용한 토큰화
____정규 표현식을 사용한 토큰화
__정규화
____문장 부호 제거
____소문자와 대문자로 변환
____불용어 처리
____영어의 불용어 계산
__토큰의 대체 및 수정
____정규 표현식을 사용한 단어 대체
____텍스트를 다른 텍스트로 대체하는 예제
____토큰화 전에 대체 수행
____반복되는 문자 처리
____반복 문자를 삭제하는 예제
____단어를 동의어로 대체
____단어를 동의어로 대체하는 예제
__텍스트에 지프의 법칙 적용
__유사 척도
____편집 거리 알고리즘을 사용한 유사 척도
____자카드 계수를 사용한 유사 척도
____스미스 워터맨 거리를 사용한 유사 척도 적용
____그 외 문자열 유사도 메트릭
__요약
2장. 통계 언어 모델링
__단어 빈도 이해
____주어진 텍스트의 MLE 개발
____은닉 마르코프 모델 추정
__MLE 모델의 스무딩 적용
____에드온 스무딩
____Good Turing
____크네저 네이 추정
____위튼 벨 추정
__MLE의 백-오프 메커니즘 개발
__믹스 앤 매치를 얻기 위한 데이터 보간법 적용
__혼잡도를 통한 언어 모델 평가
__모델링 언어에서 메트로폴리스 헤이스팅스 적용
__언어 처리에서 깁스 샘플링 적용
__요약
3장. 형태학 ? 시작하기
__형태학 소개
__스테머 이해
__원형복원 이해
__비영어 언어의 스테머 개발
__형태소 분석기
__형태소 생성기
__검색 엔진
__요약
4장. 품사 태깅 - 단어 식별
__품사 태깅 소개
____기본 태깅
__POS-tagged corpora 생성
__기계 학습 알고리즘 선택
__n-gram 접근법과 관련된 통계 모델링
__pos-tagged data를 사용한 청커 개발
__요약
5장. 파싱 - 훈련 데이터 분석
__파싱 소개
__트리뱅크 구성
__트리뱅크의 문맥 자유 문법 규칙 추출
__CFG에서 확률적 문맥 자유 문법 생성
__CYK 차트 파싱 알고리즘
__Earley 차트 파싱 알고리즘
__요약
6장. 의미 분석 - 본질 표현
__의미 분석 소개
____NER 소개
____은닉 마르코프 모델을 사용한 NER 시스템
____기계 학습 툴킷을 사용한 NER 훈련
____POS 태깅을 사용한 NER
__Wordnet의 synset id 생성
__Wordnet을 사용한 의미 판별
__요약
7장. 감정 분석 - 나는 행복하다.
__감정 분석 소개
____NER를 사용한 감정 분석
____기계 학습을 사용한 감정 분석
____NER 시스템의 평가
__요약
8장. 정보 검색 - 정보 접속
__정보 검색 소개
____불용어 제거
____벡터 공간 모델을 사용한 정보 검색
__벡터 공간 스코링 및 질의 연산자 상호 작용
__잠재 의미 색인을 이용한 IR 시스템 개발
__텍스트 요약
__질의 응답 시스템
__요약
9장. 담화 분석 - 아는 것은 믿는 것이다.
__담화 분석 소개
____중심화 이론을 사용한 담화 분석
____대용어복원
__요약
10장. NLP 시스템의 평가 - 성능 분석
__NLP 시스템 평가의 필요성
____NLP 도구(POS 태거, 스테머, 형태소 분석기) 평가
____골드 데이터를 사용한 파서 평가
__IR 시스템의 평가
__오류 식별 메트릭
__어휘 매칭 기반 메트릭
__구문 매칭 기반 메트릭
__얕은 의미 매칭을 사용한 메트릭
__요약

