









출고예상일 안내
주문하신 상품이 한국에서 현지 배송을 위한 출고단계가 이루어질 것으로 예상되는 날짜입니다. 상품을 준비하는 과정에서 내부적인 사정으로 인해 출고예상일에 다소 오차가 생길 수 있습니다.
여러 상품(예약상품포함)을 함께 주문하신 경우 출고예상일이 가장 늦은 날짜에 맞춰 함께 배송됩니다.


Spark로 하는 고속 빅데이터 분석과 처리 분산 클라우드 환경의 고속 클러스터 컴퓨팅
원제 : Fast Data Processing with Spark
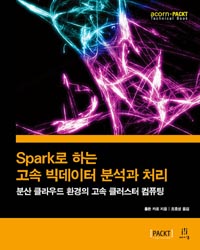





ISBN : 9788960776524 / 144쪽 188 x 235 (㎜)
이 상품에 궁금하신점이 있으세요? 1:1상담문의



아래의 도서와 구매하시면 이 도서들의 적립금을 즉시적용해 드립니다.
-

이와사키 히로마사
-
-
-

클리커, 이희영, 강민혁
- 15,120
- 26,100
- 20,700
- 22,500



출판사 리뷰
출판사 서평 ★ 요약 ★ 이 책은 하둡의 처리속도보다 최대 100배 이상 빨라진 고속의 범용 클러스터 컴퓨팅 시스템을 제공하는 아파치 스파크(Spark)의 입문서이다. 스파크 시스템을 이용하면 SQL과 같은 데이터를? 처리하는 툴 사용, 구조화된 데이터 처리, 머신 러닝, 그래프 데이터 프로세싱을 할 수 있다. 웹 개발자에게 익숙한 자바, 스칼라, 파이썬을 이용해서 로컬 환경뿐 아니라 클러스터 환경에서 고속의 데이터 분석을 할 수 있으므로 빅데이터를 학습하는 학생부터 현장에서 근무하는 엔지니어까지 좋은 지침서로 활용할 수 있다. ★ 이... ★ 요약 ★ 이 책은 하둡의 처리속도보다 최대 100배 이상 빨라진 고속의 범용 클러스터 컴퓨팅 시스템을 제공하는 아파치 스파크(Spark)의 입문서이다. 스파크 시스템을 이용하면 SQL과 같은 데이터를 처리하는 툴 사용, 구조화된 데이터 처리, 머신 러닝, 그래프 데이터 프로세싱을 할 수 있다. 웹 개발자에게 익숙한 자바, 스칼라, 파이썬을 이용해서 로컬 환경뿐 아니라 클러스터 환경에서 고속의 데이터 분석을 할 수 있으므로 빅데이터를 학습하는 학생부터 현장에서 근무하는 엔지니어까지 좋은 지침서로 활용할 수 있다. ★ 이 책에서 다루는 내용 ★ ■ 스파크의 인터랙티브 셸을 이용한 분산 애플리케이션의 프로토타이핑 방법 ■ 스파크의 분산 대표 데이터(RDD)를 이용해서 통신할 수 있는 다양한 방법 ■ 다양한 데이터 소스에서 데이터를 로드하는 방법 ■ SQL과 같은 쿼리 문법을 이용해서 스파크에게 쿼리하는 방법 ■ 분산 소프트웨어를 효과적으로 테스트하는 방법 ■ 스파크 설치를 튜닝하는 방법 ■ 클러스터에 스파크를 설치하고 환경 설정하는 방법 ■ 대규모의 데이터를 효과적으로 처리하는 방법 ★ 이 책의 대상 독자 ★ 이 책은 스파크를 이용해서 분산 프로그램을 개발하는 방법을 배우고자 하는 소프트웨어 개발자를 위한 것이다. 과거에 분산 프로그래밍을 해본 경험이 꼭 필요한 것은 아니다. 단, 이 책은 개발자가 자바, 스칼라, 파이썬에 관한 배경지식이 있다고 가정한다. ★ 이 책의 구성 ★ 1장, ‘스파크 설치와 클러스터 설정’ 다양한 머신에서 스파크를 설치하는 방법과 클러스터 설정 방법을 다룬다. 개발 환경에 적합한 로컬 단일 노드 배포부터 EC2 클러스터에 대한 셰프(Chef)가 관리하는 대규모 클러스터까지 모두 아울러 설명한다. 2장, ‘스파크 셸 사용’ 상호작용 모드에서 첫 번째로 스파크 잡을 동작시킨다. 스파크 셸은 빠르고 유용한 디버깅 도구로서, 특히 스파크를 처음 접할 때 상당히 편리하다. 3장, ‘스파크 앱 개발과 실행’ 스파크 클러스터 환경에서 프로덕션 목적에 적합한 독립적인 잡의 구성 방법을 설명한다. 스파크 셸이 빠른 프로토타입 구성에 적합한 도구일지라도 독립적인 잡의 구성이 스파크와 상호작용하는 방법의 대부분이 될 것이다. 4장, ‘스파크컨텍스트 생성’ 스파크 클러스터와 연결하는 방법을 설명한다. 스파크컨텍스트(SparkContext)는 프로그램을 위한 스파크 클러스터의 시작점이다. 5장, ‘스파크에 데이터 로딩과 저장’ RDD(Resilient Distributed DataSet)의 생성과 저장 방법을 설명한다. 스파크는 하둡 데이터 소스에서 RDD 로딩을 지원한다. 6장, ‘RDD 조작’ 스파크를 이용해 데이터를 분산환경에서 사용하는 방법을 설명한다. 흥미로운 내용이 가득한 단원이다. 7장, ‘샤크-하이브와 스파크의 연동’ 스파크가 설치된 HiveQL과 호환성이 있는 시스템인 샤크(Shark)의 설치방법과 스파크 잡을 하이브(Hive) 쿼리에 결합하는 방법을 설명한다. 8장, ‘테스팅’ 스파크 잡의 테스트 방법을 다룬다. 분산 태스크의 디버깅은 상당히 까다롭기 때문에 테스팅 과정은 매우 중요하다. 9장, ‘팁과 요령’ 스파크 태스크의 성능 향상 방법을 살펴본다. ★ 저자 서문 ★ 이 책은 스파크를 이용해 분산 맵리듀스(MapReduce) 스타일의 프로그램을 작성하는 방법에 대해 설명한다. 이 책은 클러스터에 잡(job)을 할당하고, 용도에 맞게 튜닝하기 위해 분산 프로그램을 효과적으로 작성하는 방법과 스파크 API 내용을 설명한다. 이 책은 다양한 환경(독립적인 하나의 머신, EC2 등)에서 스파크 클러스터를 설정하는 방법과 통신 가능한 분산 코드를 작성하기 위해 인터랙티브 셸(interactive shell)의 사용 방법을 설명한다. 인터랙티브 셸을 사용할 수 있다면, 자바, 스칼라, 파이썬을 이용해서 분산 잡을 구현하고 할당할 수 있는 방법까지 학습할 수 있다. 다음으로 인터랙티브 셸을 사용해서 빠르게 분산 프로그램의 프로토타이핑하는 방법을 살펴보고, 스파크 API를 배운다. 샤크(Shark)를 이용한 SQL과 같은 쿼리 문법을 사용하기 위해 스파크를 하이브(Hive)와 함께 사용할 수 있는 방법도 살펴보면서 RDD(Resilient Distributed Dataset)를 수정해 본다. ★ 옮긴이의 말 ★ 스파크는 대규모 데이터 처리에 효과적인 범용 고속 엔진이다. 스파크는 하둡(Hadoop), 메소스(Mesos)와 연동하거나 독립적으로 클라우드 환경에서 동작할 수 있으며 HDFS, 카산드라(Cassandra), HBase, S3를 포함한 다양한 데이터 소스에 접근할 수 있다. 스파크는 자바, 스칼라, 파이썬 API를 지원하며 개발자는 EC2 환경에서 제품용으로 1,000개 노드까지 확장할 수 있고, 연구 목적은 최대 2,000개의 노드까지 확장할 수 있다. 자세한 자료는 https://en.wikipedia.org/wiki/Apache_Spark를 참고하자. 스파크는 오픈 소스 형태로 누구나 다운로드할 수 있으며 아파치 라이선스 2.0으로 공개되어 있으므로 라이센스 규정을 준수해야 한다. GPL 3.0 버전과 호환성을 이루지만 GPL 1.0과 GPL 2.0과는 호환성을 제공하지 않는다. 아파치 인큐베이터에 통합되기 전 버전인 0.7 이전 버전은 BSD 라이센스로 배포되었다. 기존의 빅데이터 처리 엔진과는 달리 스파크는 두 단계로 구성된 맵리듀스 패러다임을 과감히 버렸으며, 일부 애플리케이션에게 하둡 맵리듀스의 데이터 처리 속도보다 100배까지 빠른 성능을 보장하고 있다. 또한 야후, 인텔 등을 포함해서 30여 곳이 넘는 기업들이 코드 공헌(code contribution)을 지속적으로 유지하고 있어 안정성도 가히 우수하다. 빅데이터를 이용해서 의미 있는 사업을 모색하는 기업이나 개인에게 스파크는 분명 좋은 기회를 제공할 것이다.

-
- 구분 : 저서
- 이름 : 홀든 카로
- 국적 : 기타
- 직업 :
- 분류 : 과학/공학 저자
- 인기지수 [22]
-


- [최근저서]전체보기
- Spark로 하는 고속 빅데...

-
- 이름 : 조효성
- 국적 : 대한민국
- 직업 :
- 분류 : 과학/공학 저자 , 기타
- 인기지수 [72]
-

★ 저자 서문 ★
이 책은 스파크를 이용해 분산 맵리듀스(MapReduce) 스타일의 프로그램을 작성하는 방법에 대해 설명한다. 이 책은 클러스터에 잡(job)을 할당하고, 용도에 맞게 튜닝하기 위해 분산 프로그램을 효과적으로 작성하는 방법과 스파크 API 내용을 설명한다.
이 책은 다양한 환경(독립적인 하나의 머신, EC2 등)에서 스파크 클러스터를 설정하는 방법과 통신 가능한 분산 코드를 작성하기 위해 인터랙티브 셸(interactive shell)의 사용 방법을 설명한다. 인터랙티브 셸을 사용할 수 있다면, 자바, 스칼라, 파이썬을 이용해서 분산 잡을 구현하고 할당할 수 있는 방법까지 학습할 수 있다.
다음으로 인터랙티브 셸을 사용해서 빠르게 분산 프로그램의 프로토타이핑하는 방법을 살펴보고, 스파크 API를 배운다. 샤크(Shark)를 이용한 SQL과 같은 쿼리 문법을 사용하기 위해 스파크를 하이브(Hive)와 함께 사용할 수 있는 방법도 살펴보면서 RDD(Resilient Distributed Dataset)를 수정해 본다.
★ 옮긴이의 말 ★
스파크는 대규모 데이터 처리에 효과적인 범용 고속 엔진이다. 스파크는 하둡(Hadoop), 메소스(Mesos)와 연동하거나 독립적으로 클라우드 환경에서 동작할 수 있으며 HDFS, 카산드라(Cassandra), HBase, S3를 포함한 다양한 데이터 소스에 접근할 수 있다. 스파크는 자바, 스칼라, 파이썬 API를 지원하며 개발자는 EC2 환경에서 제품용으로 1,000개 노드까지 확장할 수 있고, 연구 목적은 최대 2,000개의 노드까지 확장할 수 있다. 자세한 자료는 https://en.wikipedia.org/wiki/Apache_Spark를 참고하자.
스파크는 오픈 소스 형태로 누구나 다운로드할 수 있으며 아파치 라이선스 2.0으로 공개되어 있으므로 라이센스 규정을 준수해야 한다. GPL 3.0 버전과 호환성을 이루지만 GPL 1.0과 GPL 2.0과는 호환성을 제공하지 않는다. 아파치 인큐베이터에 통합되기 전 버전인 0.7 이전 버전은 BSD 라이센스로 배포되었다.
기존의 빅데이터 처리 엔진과는 달리 스파크는 두 단계로 구성된 맵리듀스 패러다임을 과감히 버렸으며, 일부 애플리케이션에게 하둡 맵리듀스의 데이터 처리 속도보다 100배까지 빠른 성능을 보장하고 있다. 또한 야후, 인텔 등을 포함해서 30여 곳이 넘는 기업들이 코드 공헌(code contribution)을 지속적으로 유지하고 있어 안정성도 가히 우수하다.
빅데이터를 이용해서 의미 있는 사업을 모색하는 기업이나 개인에게 스파크는 분명 좋은 기회를 제공할 것이다.

목차
1장 스파크 설치와 클러스터 설정
__싱글 머신에서 스파크 구동
__EC2 환경에서 스파크 구동
____EC2 환경에서 스크립트를 이용한 스파크 구동
__탄력적 맵리듀스에서 스파크 사용
__Chef를 연동한 스파크 배치(opscode)
__Mesos에서 스파크 사용
__YARN에서 구동하는 스파크 사용
__SSH를 통한 머신 집합 사용
__링크와 레퍼런스
__요약
2장 스파크 셸 사용
__텍스트 파일 로딩
__로지스틱 회귀 분석을 위한 스파크 셸 사용
__S3 데이터의 양단간 로딩
__요약
3장 스파크 앱 개발과 실행
__sbt를 이용한 스파크 프로젝트 생성
__메이븐을 이용한 스파크 잡 빌드
__기타 다른 빌드 시스템을 이용한 스파크 잡 빌드
__요약
4장 스파크컨텍스트 생성
__스칼라
__자바
__공유 자바와 스칼라 API
__파이썬
__링크와 참조
__요약
5장 스파크에 데이터 로딩과 저장
__RDDs
__RDD에 데이터를 로딩
__데이터 저장
__링크와 참조
__요약
6장 RDD 조작
__스칼라와 자바를 이용한 RDD 조작
____스칼라 RDD 메소드
____PairRDD 메소드를 결합하는 메소드
____그밖의 PairRDD 메소드
____DoubleRDD 메소드
____일반 RDD 메소드
____자바 RDD 메소드
____스파크 자바 메소드 클래스
______공통 자바 RDD 메소드
____JavaPairRDD 메소드를 조합하는 메소드
______JavaPairRDD 메소드
__파이썬을 이용한 RDD 수정
____표준 RDD 함수
____PairRDD 메소드
__링크와 참조
__요약
7장 샤크-하이브와 스파크의 연동
__하이브/샤크 사용 이유
__샤크 설치
__샤크 구동
__데이터 로딩
__스파크 프로그램에서 하이브 쿼리 사용
__링크와 참조
__요약
8장 테스팅
__자바와 스칼라로 테스트하기
____테스트 가능성을 위한 코드 리팩토링
____스파크컨텍스트의 인터렉션 테스팅
__파이썬을 이용한 테스팅
__링크와 참조
__요약
9장 팁과 요령
__로그 저장 위치
__동시 실행 제약사항
__메모리 사용과 가비지 콜렉션
__직렬화
__IDE 통합
__다른 언어로 스파크 사용
__보안에 대한 간단한 노트
__메일링 리스트
__링크와 참조
__요약

