









출고예상일 안내
주문하신 상품이 한국에서 현지 배송을 위한 출고단계가 이루어질 것으로 예상되는 날짜입니다. 상품을 준비하는 과정에서 내부적인 사정으로 인해 출고예상일에 다소 오차가 생길 수 있습니다.
여러 상품(예약상품포함)을 함께 주문하신 경우 출고예상일이 가장 늦은 날짜에 맞춰 함께 배송됩니다.




- 정가
- $88.00
- 판매가
-
$48.40
(45%↓)

- 적립금
- $0.97 (2%P)
품절된 상품입니다.
이 책을 꼭 원하시는 고객님께서는 아래 "상품문의"를 클릭 후 구매의사를
알려주세요. 책이 확보 될 경우 연락 드리겠습니다.



이책의 개정판 정보
하둡 완벽 가이드 [제4판] 톰 화이트 저 | 한빛미디어 | 2017년 03월
평점 - · 리뷰 0
ISBN : 9788968480201 / 812쪽 188 x 257 (㎜)
이 상품에 궁금하신점이 있으세요? 1:1상담문의



아래의 도서와 구매하시면 이 도서들의 적립금을 즉시적용해 드립니다.
-
홍지수, 홍은지
-
권석만
-
구오제드, 송이핑, 조신
-
천근아, 박정훈, 장지흠, 진재연, 이정한, 민윤기
- 30,000
- 26,100
- 26,100
- 22,500



출판사 리뷰
[ 이 책이 제시하는 핵심 내용]
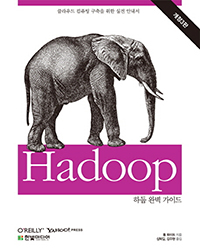
이 책은 구글의 알고리즘을 구현한 최고의 클라우드 컴퓨팅 기술인 하둡에 대해 다룬다. 특히 하둡 2.x와 맵리듀스 2를 다룬 최초의 책이다. 사실 하둡 2.x와 얀으로 불리는 맵리듀스 2는 기존 버전과 많이 다르다. 새로 추가된 기능들은 기존 버전에서 아쉬웠던 부분을 메꿔주기 때문에 반드시 도입해야 한다. 커미터가 직접 쓴 이 책을 밑거름 삼아 더 성공적인 클라우드 컴퓨팅 시스템을 구현하자!
[이 책의 특징과 장점]
하둡 프로젝트의 커미터이자 핵심 설계자인 톰 화이트가 저술한 이 책은 하둡을 가장 완벽하게 다루고 있다. 저자는 하둡 창시자인 더그 커팅을 비롯한 각기 전문가의 강력한 조언을 받았고 이를 본서에 충실하게 반영했다. 이 책은 하둡은 물론이고 하둡과 연동해서 사용할 수 있는, 아파치 하둡 프로젝트의 서브 프로젝트인 피그, 주키퍼, HBase, 하이브, 스쿱, 에이브 등에 대해서도 다룬다. Last.fm, 페이스북, 랙페이스의 하둡 활용 사례를 통해 어떻게 하둡을 활용해야 하는지 배울 수 있다. 본 한글판은 역자주를 통해 하둡 최신 정보를 반영했다.
[어떤 독자를 위한 책인가?]
- 클라우드 컴퓨팅 분야의 학자, 개발자, 기술 기획자
- 데이터 마이닝 등 데이터 분석 및 알고리즘 학자, 개발자
[도서 특징(책 표지 글)]
데이터에 대한 생각을 전환하라!
500기가바이트를 59초 만에, 100테라바이트를 단 173분 만에 정렬하는 하둡은 상상을 초월하는 데이터 분석 성능을 제공한다. 구글의 알고리즘을 구현한 하둡은 맵리듀스 기법으로 데이터에 대한 생각을 변화시키고, 이전에 보존해 두었던 그 어떤 데이터든지 활용할 수 있게 한다. 전에는 너무 오랜 시간이 걸려 결과를 얻을 수 없었던 문제도 이제는 하둡으로 빠르게 해답을 얻을 수 있게 되었고, 이를 통해 새로운 통찰력도 얻을 수 있게 되었다.
하둡, 클라우드 컴퓨팅의 역사를 바꾸다!
2008년 2월 - 뉴욕타임스는 1851년부터 1980년 12월까지 130년 분량의 신문기사 1,100만 매를 '아마존 S3'에 저장하고, 하둡을 이용하여 약 4테라바이트 크기의 데이터를 24시간 만에 변환했다. 이는, 일반 서버로 대략 14년이 걸리는 어마어마한 작업량이다.
2008년 4월 - 하둡은 '맵리듀스로 테라바이트 데이터 소트' 대회에서 전년도 우승자의 297초에 비해 2/3분 수준인 209초 만에 정렬하며 우승했다. 이어 2009년 5월, 야후는 하둡으로 62초 만에 1테라바이트를 정렬했다.
2009년 4월 - '1분 소트' 대회에서 500기가바이트를 59초에(1,400개 노드에서) 정렬하며 우승했다. 또한 100테라바이트를 173분에(3,400개 노드에서) 정렬했다.
[개정판에서 새로워진 내용]
3판_ 아파치 하둡의 새로운 버전 0.22와 2.x(이전에는 0.23)뿐만 아니라, 1.x(이전에는 0.20) 모두를 다룬다. 이 책의 예제는 몇 가지 예외 사항(책에서 별도로 표시)을 제외하고 모든 버전을 위해 작성되었다. 각 버전에 대한 특성들은 1장 '하둡 릴리즈'에서 상세히 다룬다.
이번 개정판은 새로운 맵리듀스 API를 대부분의 예제에 사용한다. 그럼에도 이전 API가 여전히 폭넓게 활용되고 있기 때문에 새로운 API가 나올 때 함께 논의된다. 이 책에서 제시한 웹 사이트에서 새로운 API에 대응하는 이전 API의 소스 코드가 제공될 것이다.
하둡 2.0의 주요 변화는 얀(YARN)으로 명명된 새로운 분산 리소스 관리 시스템으로 구현된 새로운 맵리듀스(맵리듀스 2)다. 얀 기반의 맵리듀스는 6장과 9장에서 각각 작동 방식 및 실행 방식에 대해 다룬다.
맵리듀스에 대한 더 많은 내용도 다룬다. 메이븐으로 맵리듀스 잡 패키징, 사용자의 자바 클래스 경로 설정, MRUnit으로 테스트 코드 작성과 같은 개발에 필요한 실질적인 내용은 5장에 포함되어 있다. 출력 커미터, 분산 캐시, 태스크 메모리 모니터링과 같은 깊이 있는 맵리듀스 특성은 8장과 9장에서 각각 다룬다. 에이브로 데이터 처리를 위한 맵리듀스 잡 작성은 4장에 새롭게 추가되었고, 오지Oozie를 활용한 간단한 맵리듀스 워크플로우 실행은 5장에 새로 추가되었다.
HDFS 고가용성과 HDFS 통합은 기존 HDFS를 다루었던 3장에 새롭게 추가되었고, WebHDFS와 HttpFS 같은 새로운 파일시스템도 3장에서 함께 다룬다.
피그, 하이브, 스쿱, 주키퍼의 각 장들도 최신 릴리즈의 특성과 변화를 반영하여 내용을 새롭게 추가했다.
이와 더불어 책 전반에 걸쳐 내용에 대한 정정과 개선이 이뤄졌다.
2판_ 하이브와 스쿱에 관한 두 개의 새로운 장(12장과 15장), 에이브로를 다루는 새로운 절(4장), 하둡의 새로운 보안 속성에 대한 소개(9장), 하둡을 사용한 대규모 네트워크 그래프 분석에 대한 새로운 사례분석이 추가되었다.
대용량 데이터에 관한 가장 완벽한 책(개정판)!
하둡 프로젝트의 커미터이자 핵심 설계자인 톰 화이트가 저술한 이 책은 하둡을 가장 완벽하게 다루고 있다. 하둡의 개념과 사용법은 물론 Last.fm, 페이스북, 랙페이스의 하둡 활용 사례를 통해 어떻게 하둡을 활용해야 하는지 배울 수 있다. 개정판에서는 최신 변경 내용을 반영하고 하이브, 스쿱, 에이브로 내용을 추가했다.
얀 기반의 맵리듀스
오지(Oozie)를 활용한 맵리듀스 워크플로우 실행
대규모 데이터셋 저장을 위해 하둡 분산파일시스템(HDFS)
맵리듀스를 통한 분산 연산 작업
데이터 압축, 정합성, 직렬화, 영속성을 위한 입출력 빌딩 블록
전용 하둡 클러스터 설계, 구축, 운영 방법
대규모 데이터 처리를 위한 피그
구조화된 데이터와 반-구조화된 데이터를 처리하는 HBase
분산 시스템 구축을 위한 주키퍼
하이브-하둡 데이터웨어하우징 시스템





1장 하둡과의 만남
1.1 데이터!
1.2 데이터 저장소와 분석
1.3 다른 시스템과의 비교
1.4 하둡의 역사
1.5 아파치 하둡과 하둡 생태계
1.6 하둡 릴리즈
2장 맵리듀스
2.1 기상 데이터셋
2.2 유닉스 도구로 데이터 분석하기
2.3 하둡으로 데이터 분석하기
2.4 분산형으로 확장하기
2.5 하둡 스트리밍
2.6 하둡 파이프
3장 하둡 분산 파일시스템
3.1 HDFS 설계
3.2 HDFS 개념
3.3 명령행 인터페이스
3.4 하둡 파일시스템
3.5 자바 인터페이스
3.6 데이터 흐름
3.7 데이터 이관을 위한 플룸과 스쿱
3.9 하둡 아카이브
4장 하둡 I/O
4.1 데이터 무결성
4.2 압축
4.3 직렬화
4.4 에이브로
4.5 파일 기반 데이터 구조
5장 맵리듀스 프로그래밍
5.1 환경 설정 API
5.2 개발 환경 설정하기
5.3 MRUnit으로 유닛 테스트 작성하기
5.4 로컬에서 실행하기
5.5 클러스터에서 실행하기
5.6 잡 튜닝하기
5.7 맵리듀스 작업 흐름
6장 맵리듀스 작동 방법
6.1 맵리듀스 잡 실행 상세분석
6.2 실패
6.3 잡 스케줄링
6.4 셔플과 정렬
6.5 태스크 실행
7장 맵리듀스 타입과 포맷
7.1 맵리듀스 타입
7.2 입력 포맷
7.3 출력 포맷
8장 맵리듀스 기능
8.1 카운터
8.2 정렬
8.3 조인
8.4 사이드 데이터 분배
8.5 맵리듀스 라이브러리 클래스
9장 하둡 클러스터 설정
9.1 클러스터 명세
9.2 클러스터 설정 및 설치
9.3 SSH 설정
9.4 하둡 환경 설정
9.5 얀 환경 설정
9.6 보안
9.7 하둡 클러스터 벤치마킹
9.8 하둡 클라우드
10장 하둡 관리
10.1 HDFS
10.2 모니터링
10.3 관리
11장 피그
11.1 피그의 설치 및 실행
11.2 예제
11.4 피그 라틴
11.5 사용자 정의 함수
11.6 데이터 처리 연산자
11.7 실전 피그 사용
12장 하이브
12.1 하이브 설치하기
12.2 예제
12.3 하이브 실행하기
12.4 전통적인 데이터베이스와의 비교
12.5 HiveQL
12.6 테이블
12.7 데이터 쿼리하기
12.8 사용자 정의 함수
13장 HBase
13.1 HBasics
13.2 개념
13.3 설치
13.4 클라이언트
13.5 예제
13.6 HBase와 RBMS
13.7 연습
14장 주키퍼
14.1 주키퍼의 설치와 실행
14.2 예제
14.3 주키퍼 서비스
14.4 주키퍼로 응용프로그램 구현하기
14.5 주키퍼 실 서비스
15장 스쿱
15.1 스쿱 얻기
15.2 스쿱 커넥터
15.3 임포트 예제
15.4 생성된 코드
15.5 데이터베이스 임포트: 자세히 살펴보기
15.6 불러온 데이터로 작업하기
15.7 대용량 객체 임포트하기
15.8 익스포트 수행하기
15.9 익스포트: 자세히 살펴보기
16장 사례 연구
16.1 Last.fm의 하둡 사용 사례
16.2 페이스북의 하둡과 하이브
16.3 너치 검색 엔진
16.4 랙스페이스에서의 로그 처리
16.5 캐스케이딩
16.6 아파치 하둡의 테라바이트 정렬
16.7 피그와 우공으로 10억 개 간선 네트워크 그래프 탐색하기
부록A_ 아파치 하둡 설치하기
부록B_ 클라우데라의 하둡 배포판
부록C_ NCDC 기상 데이터의 준비

