









출고예상일 안내
주문하신 상품이 한국에서 현지 배송을 위한 출고단계가 이루어질 것으로 예상되는 날짜입니다. 상품을 준비하는 과정에서 내부적인 사정으로 인해 출고예상일에 다소 오차가 생길 수 있습니다.
여러 상품(예약상품포함)을 함께 주문하신 경우 출고예상일이 가장 늦은 날짜에 맞춰 함께 배송됩니다.


빅데이터 처리와 분석을 위한 하둡 맵리듀스 프로그래밍 - acorn+PACKT 시리즈
시리즈 : 에이콘 데이터 과학 시리즈 [54]
스리나스 페레라, 실리나 기나라스네 저 | 안건국,배경숙 역 | 에이콘출판 | 2013년 08월
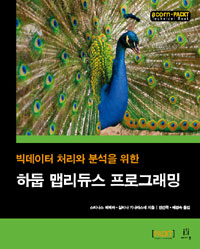





ISBN : 9788960774308 / 388쪽 188 x 235 (㎜)
이 상품에 궁금하신점이 있으세요? 1:1상담문의



아래의 도서와 구매하시면 이 도서들의 적립금을 즉시적용해 드립니다.
-

서길원, 김운호, 허상훈, 박재상, 박경규, 김종욱, 오윤우, 유지영
-
발리아파 락시마난, 하네스 하프케
-
-
제임스 러브록
- 31,500
- 37,800
- 36,000
- 18,900


- [시리즈] 에이콘 데이터 과학 시리즈 [54]

출판사 리뷰
★ 이 책에서 다루는 내용 ★
■ 예제를 실행하기 위해 하둡 맵리듀스와 HDFS를 설치하는 방법
■ 하둡과 HDFS를 안전하게 구성하고 관리하는 방법
■ 하둡 내부와 하둡이 요구 사항을 어떻게 적절히 확장하는지 이해
■ 쉽고 효율적으로 처리하기 위한 HBase와 하이브, 피그(Pig), 머하웃(Mahout), 너치(Nutch)의 사용 방법
■ 분석 문제의 다양한 유형을 해결하기 위한 맵리듀스 사용 방법
■ 분류와 관계 발견, 온라인 마케팅, 추천 같은 복잡한 문제 해결
■ 하둡 연산을 실행하기 위한 클라우드 환경 사용 방법
★ 이 책의 대상 독자 ★
빅데이터에 관심이 있는 사람과 하둡 프로그래머를 위한 책이다. 이 책은 하둡 기반에서 전혀 개발 경험이 없거나, 하둡과 맵리듀스에 대해 알고는 있지만 하둡과 관련해 뭔가를 시도하고 자세한 내용을 알기 원하는 자바 개발자를 위한 책이다. 또한 대부분의 하둡 작업을 원스톱으로 참조할 수 있다.
★ 이 책의 구성 ★
1장, '하둡 시작과 클러스터'에서 실행에서는 클러스터와 싱글 노드에서 하둡을 설치하고 실행하는 방법을 설명한다.
2장, '고급 HDFS'에서는 하둡 맵리듀스로 대규모 데이터를 처리할 때뿐만 아니라 맵리듀스를 사용하지 않는 사례에도 유용한 고급 HDFS 작업을 소개한다.
3장, '고급 하둡 맵리듀스 관리'에서는 하둡 설치 시 하둡의 구성과 보안 변경, 디버깅 방법을 설명한다.
4장, '복잡한 하둡 맵리듀스 애플리케이션 개발'에서는 사용자 정의의 효율적인 맵리듀스 애플리케이션을 개발하기 위한 고급 하둡 맵리듀스 기능 몇 가지를 소개한다.
5장, '하둡 에코시스템'에서는 HBase, 하이브, 피그 등 하둡과 관련된 다른 프로젝트를 소개한다.
6장, '분석'에서는 하둡을 사용해 기본적인 분석을 하는 방법을 설명한다.
7장, '검색과 색인'에서는 대규모 검색과 색인을 수행하는 아파치 하둡에서 사용할 수 있는 몇 가지 도구와 기술을 소개한다.
8장, '분류, 추천, 관계 분석'에서는 하둡을 사용해 분류와 추천, 관계 분석 등과 같은 복잡한 알고리즘을 구현하는 방법을 알아본다.
9장, '대용량 텍스트 데이터 처리'에서는 하둡과 머하웃(Mahout)를 사용해 대용량 텍스트 데이터셋을 처리하는 방법과 하둡을 사용해 데이터를 전처리하고 로딩하는 방법을 알아본다.
10장, '클라우드 환경에서 하둡 배포'에서는 아마존 일래스틱 맵리듀스(Elastic MapReduce, EMR)와 아파치 Whirr로 클라우드 인프라 환경에서 하둡 맵리듀스와 피그, 하이브, HBase 연산을 실행하는 방법을 알아본다.
★ 저자 서문 ★
『하둡 맵리듀스 프로그래밍』은 크고 복잡한 데이터셋을 처리하는 개발자를 위한 책이다. 이 책은 간단한 방법으로 시작하지만, 하둡에 대한 깊이 있는 지식을 제공한다. 하둡을 사용해 잡을 달성하는 방법에 대한 간략한 원스톱 가이드다. 이 책에는 단계별 절차와 실제 사례, 단순하고 이해하기 쉬운 방식으로 제시한 90가지의 예제가 있으며, 아파치 소프트웨어 재단(Apache Software Foundation, http://www.apache.org)에서 개발한 소프트웨어가 이 책에 포함된 예제에 사용됐다.
★ 옮긴이의 말 ★
하둡은 이제 특정 엔지니어의 기술이 아닌, IT에 관련된 대부분 사람들이 들어 봤을 정도로 보편화되었다. 내가 하둡을 처음 전한 건, 2008년 반도체 공정 간의 수많은 데이터를 다룰 때였다. 당시 반도체 제조에서 다뤄야 할 데이터는 테스트 데이터만 해도 5테라바이트가 넘었다. 게다가 실제 데이터는 ROI 측면에 모든 데이터를 RDBMS에 저장할 수 없었기에 이때 처음 하둡을 살펴보게 됐다. 당시에는 하둡의 가능성이 이렇게 커질지 전혀 알지 못했다. 이후 2010년 말에 이르자, 클라우드 컴퓨팅 기술 확산에 따른 데이터를 다루는 기술로 하둡이 다시 각광을 받기 시작했다. 그리고 지금은 '빅데이터'라는 패러다임에서 늘 빠지지 않는 기술로 등장한다.
하지만 하둡에는 많은 변화가 있었고, 변화 속에 하둡 버저닝은 일관성이 보장되지 않아 여전히 어려운 기술이기도 하다. 나는 하둡 소스를 열고 분석하기 시작했고 프로젝트를 진행하면서 하둡을 더 깊이 들여다보기 시작했다. 하지만 '아, 이제 좀 알겠다.'는 시점에 하둡은 또 다른 진화를 했고, 계속 발전 중이며 여전히 학습이 필요하다.
팩트 출판사에서 출간된 이 책의 컨셉은 'Cookbook'이라는 이름처럼 예제를 따라하며 하둡을 빠르게 습득하는 것을 목표로 한다. 따라서 책의 내용은 생각만큼 심오하지 않다. 그렇다고 책의 내용이 매우 친절한 것은 아니다. 그것은 하둡의 운용과 활용이 되는 배경 때문인데, 먼저 하둡을 설치하고 설정을 수정하려면 기본적으로 리눅스와 VI 같은 편집기를 조금은 알아야 한다. 물론 몰라도 배우고 사용할 수 있지만, 모르면 학습 속도가 느려져 지칠 가능성이 크다. 또한 맵리듀스 애플리케이션을 작성해야 하기 때문에 자바나 파이썬을 조금 알고 있어야 하는 학습 곡선(Learning Curve)이 존재한다. 그러나 그만큼 학습할 가치가 충분하다. 이 책은 데이터 처리의 관점에서 하둡의 주요 에코시스템을 빠르게 실행해보고 개념을 잡을 수 있도록 구성됐다. 따라서 데이터를 처리하는 다양한 기법을 확인할 수 있고, 관심 있는 에코시스템의 컴포넌트를 선택해 좀더 깊이 학습하고 기술 내재화를 할 수 있다면 빅데이터 처리 엔지니어로서 초석을 다질 수 있을 것이라고 확신한다.
- 2013년 5월 1일 노동절에
안건국

-
- 구분 : 저서
- 이름 : 스리나스 페레라
- 국적 : 기타
- 직업 :
- 분류 : 과학/공학 저자
- 인기지수 [9]
-


- [최근저서]전체보기
- 빅데이터 처리와 분석을 위한...
-
- 구분 : 저서
- 이름 : 실리나 기나라스네
- 국적 : 기타
- 직업 :
- 분류 : 과학/공학 저자
- 인기지수 [9]
-
- [최근저서]전체보기
- 빅데이터 처리와 분석을 위한...

-
- 이름 : 배경숙
- 국적 : 대한민국
- 직업 :
- 분류 : 과학/공학 저자
- 인기지수 [14]
-
-
- 이름 : 안건국
- 국적 : 대한민국
- 직업 :
- 분류 : 과학/공학 저자
- 인기지수 [25]
-
- [최근저서]전체보기
- 빅데이터 처리와 분석을 위한...

★ 저자 서문 ★
『하둡 맵리듀스 프로그래밍』은 크고 복잡한 데이터셋을 처리하는 개발자를 위한 책이다. 이 책은 간단한 방법으로 시작하지만, 하둡에 대한 깊이 있는 지식을 제공한다. 하둡을 사용해 잡을 달성하는 방법에 대한 간략한 원스톱 가이드다. 이 책에는 단계별 절차와 실제 사례, 단순하고 이해하기 쉬운 방식으로 제시한 90가지의 예제가 있으며, 아파치 소프트웨어 재단(Apache Software Foundation, http://www.apache.org)에서 개발한 소프트웨어가 이 책에 포함된 예제에 사용됐다.
★ 옮긴이의 말 ★
하둡은 이제 특정 엔지니어의 기술이 아닌, IT에 관련된 대부분 사람들이 들어 봤을 정도로 보편화되었다. 내가 하둡을 처음 전한 건, 2008년 반도체 공정 간의 수많은 데이터를 다룰 때였다. 당시 반도체 제조에서 다뤄야 할 데이터는 테스트 데이터만 해도 5테라바이트가 넘었다. 게다가 실제 데이터는 ROI 측면에 모든 데이터를 RDBMS에 저장할 수 없었기에 이때 처음 하둡을 살펴보게 됐다. 당시에는 하둡의 가능성이 이렇게 커질지 전혀 알지 못했다. 이후 2010년 말에 이르자, 클라우드 컴퓨팅 기술 확산에 따른 데이터를 다루는 기술로 하둡이 다시 각광을 받기 시작했다. 그리고 지금은 ‘빅데이터’라는 패러다임에서 늘 빠지지 않는 기술로 등장한다.
하지만 하둡에는 많은 변화가 있었고, 변화 속에 하둡 버저닝은 일관성이 보장되지 않아 여전히 어려운 기술이기도 하다. 나는 하둡 소스를 열고 분석하기 시작했고 프로젝트를 진행하면서 하둡을 더 깊이 들여다보기 시작했다. 하지만 ‘아, 이제 좀 알겠다.’는 시점에 하둡은 또 다른 진화를 했고, 계속 발전 중이며 여전히 학습이 필요하다.
팩트 출판사에서 출간된 이 책의 컨셉은 ‘Cookbook’이라는 이름처럼 예제를 따라하며 하둡을 빠르게 습득하는 것을 목표로 한다. 따라서 책의 내용은 생각만큼 심오하지 않다. 그렇다고 책의 내용이 매우 친절한 것은 아니다. 그것은 하둡의 운용과 활용이 되는 배경 때문인데, 먼저 하둡을 설치하고 설정을 수정하려면 기본적으로 리눅스와 VI 같은 편집기를 조금은 알아야 한다. 물론 몰라도 배우고 사용할 수 있지만, 모르면 학습 속도가 느려져 지칠 가능성이 크다. 또한 맵리듀스 애플리케이션을 작성해야 하기 때문에 자바나 파이썬을 조금 알고 있어야 하는 학습 곡선(Learning Curve)이 존재한다. 그러나 그만큼 학습할 가치가 충분하다. 이 책은 데이터 처리의 관점에서 하둡의 주요 에코시스템을 빠르게 실행해보고 개념을 잡을 수 있도록 구성됐다. 따라서 데이터를 처리하는 다양한 기법을 확인할 수 있고, 관심 있는 에코시스템의 컴포넌트를 선택해 좀더 깊이 학습하고 기술 내재화를 할 수 있다면 빅데이터 처리 엔지니어로서 초석을 다질 수 있을 것이라고 확신한다.
- 2013년 5월 1일 노동절에
안건국


