









출고예상일 안내
주문하신 상품이 한국에서 현지 배송을 위한 출고단계가 이루어질 것으로 예상되는 날짜입니다. 상품을 준비하는 과정에서 내부적인 사정으로 인해 출고예상일에 다소 오차가 생길 수 있습니다.
여러 상품(예약상품포함)을 함께 주문하신 경우 출고예상일이 가장 늦은 날짜에 맞춰 함께 배송됩니다.







ISBN : 9791143032423 / 119쪽 128 x 188 (㎜)
이 상품에 궁금하신점이 있으세요? 1:1상담문의



아래의 도서와 구매하시면 가격이 .35 원 더 내려갑니다.
-
-
-
김지희(릴스 마법사 롱제이)
-
최영규, 천인국
- 19,800 →19,800원
- 22,000 →22,000원
- 20,700 →20,700원
- 26,100 →26,100원


반디앤루니스 리뷰
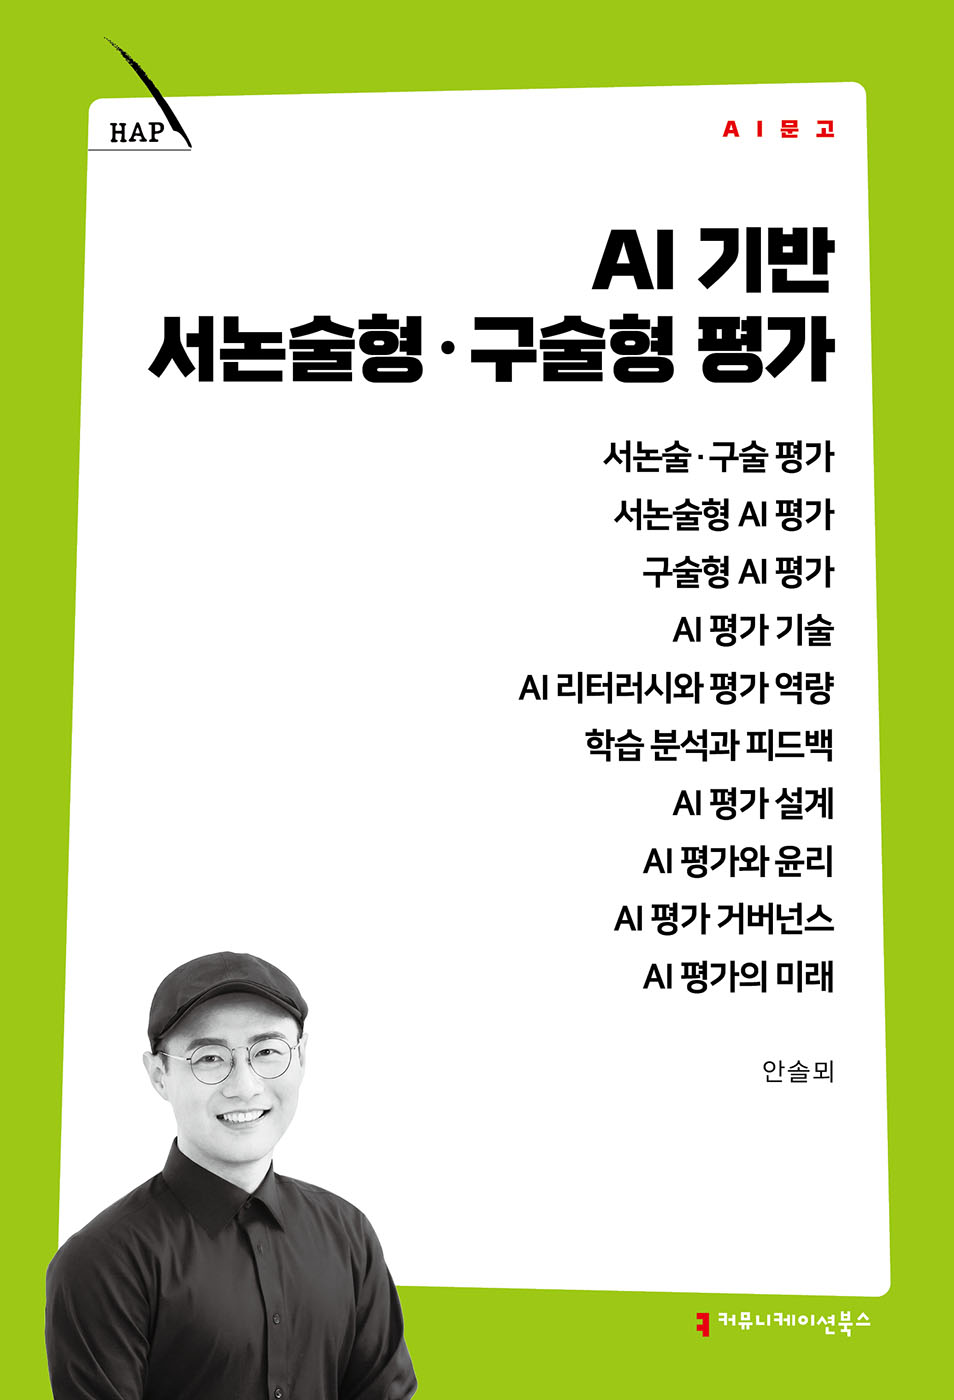
LLM과 음성 인식, 멀티모달 기술이 서논술·구술 평가를 어떻게 바꾸는지 195편의 최신 연구를 토대로 분석한다. 자동 채점의 성능뿐 아니라 타당성·공정성·편향·인간 감독과 거버넌스를 함께 다룬다. 생성형 AI와 함께 쓰고 말하는 시대, 정답과 결과물을 넘어 인간의 사고와 이해를 어떻게 평가할 것인지 묻는다. AI문고. aiseries.oopy.io에서 필요한 인공지능 지식을 찾을 수 있다.
출판사 리뷰
정답을 맞히는 평가에서 사고를 읽는 평가로
선택형 평가는 빠르고 일관되지만 학습자가 어떻게 생각하고 이해했는지까지 보여 주기는 어렵다. 서논술형과 구술형 평가는 비판적 사고와 논리적 추론, 문제 해결 과정을 드러내지만 채점에 많은 시간과 비용이 들고 평가자 간 편차도 크다. 이 책은 LLM, 자동 음성 인식, 멀티모달 기술이 이 오래된 난제를 어디까지 풀고 있는지 살핀다. 2023년 이후 발표된 관련 연구 1만 6114건 가운데 195편을 체계적으로 분석해 자동 에세이 채점과 쓰기 평가, 구술 평가 기술의 성숙도와 한계를 검토한다. 교육뿐 아니라 채용과 HR까지 범위를 넓혀 AI가 사람의 수행을 어떻게 평가하고 의사 결정에 개입하는지도 짚는다. 높은 사람-AI 채점 일치도가 곧 인간 평가자의 퇴장을 뜻하지는 않는다. 평가의 타당성, 편향과 공정성, 설명 가능성, 생체데이터 활용, 인간 감독과 거버넌스가 함께 설계되어야 하기 때문이다. 특히 생성형 AI와 함께 쓰고 말하는 시대에는 결과물만 보고 능력을 판단하기가 더 어려워진다. 이제 평가는 정답이나 완성된 산출물보다 그 안에서 인간이 어떤 사고를 했는지 읽어야 한다. AI 평가의 핵심은 자동화가 아니라 사고의 깊이를 얼마나 타당하고 책임 있게 판단할 수 있는가에 있다.

-
- 저자 : 안솔뫼

서논술과 구술은 같은 구성?반응 평가지만, 평가자가 넘어야 할 문턱은 서로 다르다. 글은 지면에 고정되어 있어, 평가자는 다시 읽거나 밑줄을 긋고 비교하며 판단을 다듬을 수 있다. 그래서 글의 핵심은 해석의 깊이에 있다. 논증의 비약을 알아채고 근거가 탄탄한지 가늠하는 일은, 어휘나 문법 같은 표면적인 요소를 검토하는 일과는 다르다. 반면, 말의 기준은 성격이 다르다. 한 구술형 연구가 언급한 바와 같이, 발화는 일시적이고 소리로만 존재해 붙잡아 두고 되짚으며 개별 피드백을 주기가 유난히 어렵다. 교사들이 말하기 지도를 버거워한 나머지 교실의 말하기 평가가 뒷전으로 밀린다는 지적도 있고, 반대로 대규모 시험에 말하기 평가가 더해지자 교실의 말하기 연습이 늘었다는 관찰도 있다. 즉, 평가가 사라지면 연습도 사라질 수 있다. 시험이 거꾸로 교육의 내용을 규정하는 일종의 환류 효과다.
-01_“서논술·구술 평가” 중에서
구술형 AI 평가는 채용을 비롯한 다양한 평가 맥락으로도 확장되었다. 지원자의 영상과 음성, 텍스트를 함께 분석하는 시도가 상용화 수준에서 다뤄지고, 민감 정보 수집이 제한되는 환경에서도 집단 간 형평성을 지키려는 보정 장치가 연구되어 왔다(Putra et al., 2024). 발화 기반 평가가 채용이라는 고부담 결정의 영역까지 들어온 만큼, 정확도만이 아니라 공정성과 투명성의 설계가 강조된다. 그 질문에 기술이 내놓는 답이 공정성 알고리즘이고, 기술만으로 닿지 못하는 부분은 윤리와 제도가 맡는다.
-03_“구술형 AI 평가” 중에서
한 교실 내에서 모든 학습자에게 맞춤화된 좋은 피드백을 각각 주는 일은 교사 한 사람이 감당할 수 없는, 오래된 과제였다. 그러나 최신의 고도화된 AI 기술은 그동안 이론과 실험실에 머물던 논의를 상용화 수준으로 옮겨왔다. 다만 여전히 AI 피드백의 효과에는 명확한 조건과 한계가 존재한다. 이와 관련해 실험 연구 36편을 메타분석한 한 연구에 따르면, 생성형 AI 피드백이 학업 성취를 일정 수준으로 향상시킨 바는 확인되었지만, 주요한 효과는 도구가 아니라 교수 방법에 따라 나타났음을 보고했다. AI 피드백은 협력 및 자기주도 학습에서는 높은 효과를 보고한 반면, 일방향적 교수 방식에서는 그 효과가 사라졌고, 성과의 유형에 따라서도 편차가 있었다. 인지적 성취에서 가장 컸고, 메타인지에서는 가능성은 보였으나 근거가 부족했으며 동기 같은 비인지 영역에서는 미미했다. 그렇다면 남는 질문은 그 수업을 어떻게 설계하느냐다.
-06_“학습 분석과 피드백” 중에서
국내의 AI 거버넌스 또한 선제적으로 추진되며, 권고 수준의 자율 가이드라인 논의에 머물지 않고 다음 단계로 접어들었다. 2026년 1월 시행된 인공지능기본법은 유럽연합에 이어 포괄적 AI 규율 체계를 갖춘 선진 사례로, 사람의 생명과 신체의 안전, 기본권에 중대한 영향을 미치는 고영향 인공지능을 별도로 규정한 바 있다. 채용과 교육이 그 범주에 포함되면서 AI 평가는 국내에서도 법적 규율의 대상이 되었다. 사업자에게는 설명 방안의 수립과 시행, 안전성·신뢰성 확보 조치의 문서 작성과 보관이 책무로 부과된다. 다만 영향 평가는 성격이 다르다. 기본법은 이를 사전에 실시하도록 노력할 것을 요구하고, 국가기관 등이 영향 평가를 거친 제품을 우선 고려하도록 하는 유인을 언급해 두었다.
-09_“AI 평가 거버넌스” 중에서

정답이 아닌 사고
01 서논술·구술 평가
02 서논술형 AI 평가
03 구술형 AI 평가
04 AI 평가 기술
05 AI 리터러시와 평가 역량
06 학습 분석과 피드백
07 AI 평가 설계
08 AI 평가와 윤리
09 AI 평가 거버넌스
10 AI 평가의 미래

