









출고예상일 안내
주문하신 상품이 한국에서 현지 배송을 위한 출고단계가 이루어질 것으로 예상되는 날짜입니다. 상품을 준비하는 과정에서 내부적인 사정으로 인해 출고예상일에 다소 오차가 생길 수 있습니다.
여러 상품(예약상품포함)을 함께 주문하신 경우 출고예상일이 가장 늦은 날짜에 맞춰 함께 배송됩니다.







ISBN : 9791173400070 / 536쪽 / 1,058g / 188 x 257 (㎜)
이 상품에 궁금하신점이 있으세요? 1:1상담문의



아래의 도서와 구매하시면 가격이 1.11 원 더 내려갑니다.
-
-
리카이푸, 천치우판
-
-
신종홍
- 27,000 →26,999원
- 26,820 →26,819원
- 24,300 →24,299원
- 26,100 →26,099원


반디앤루니스 리뷰
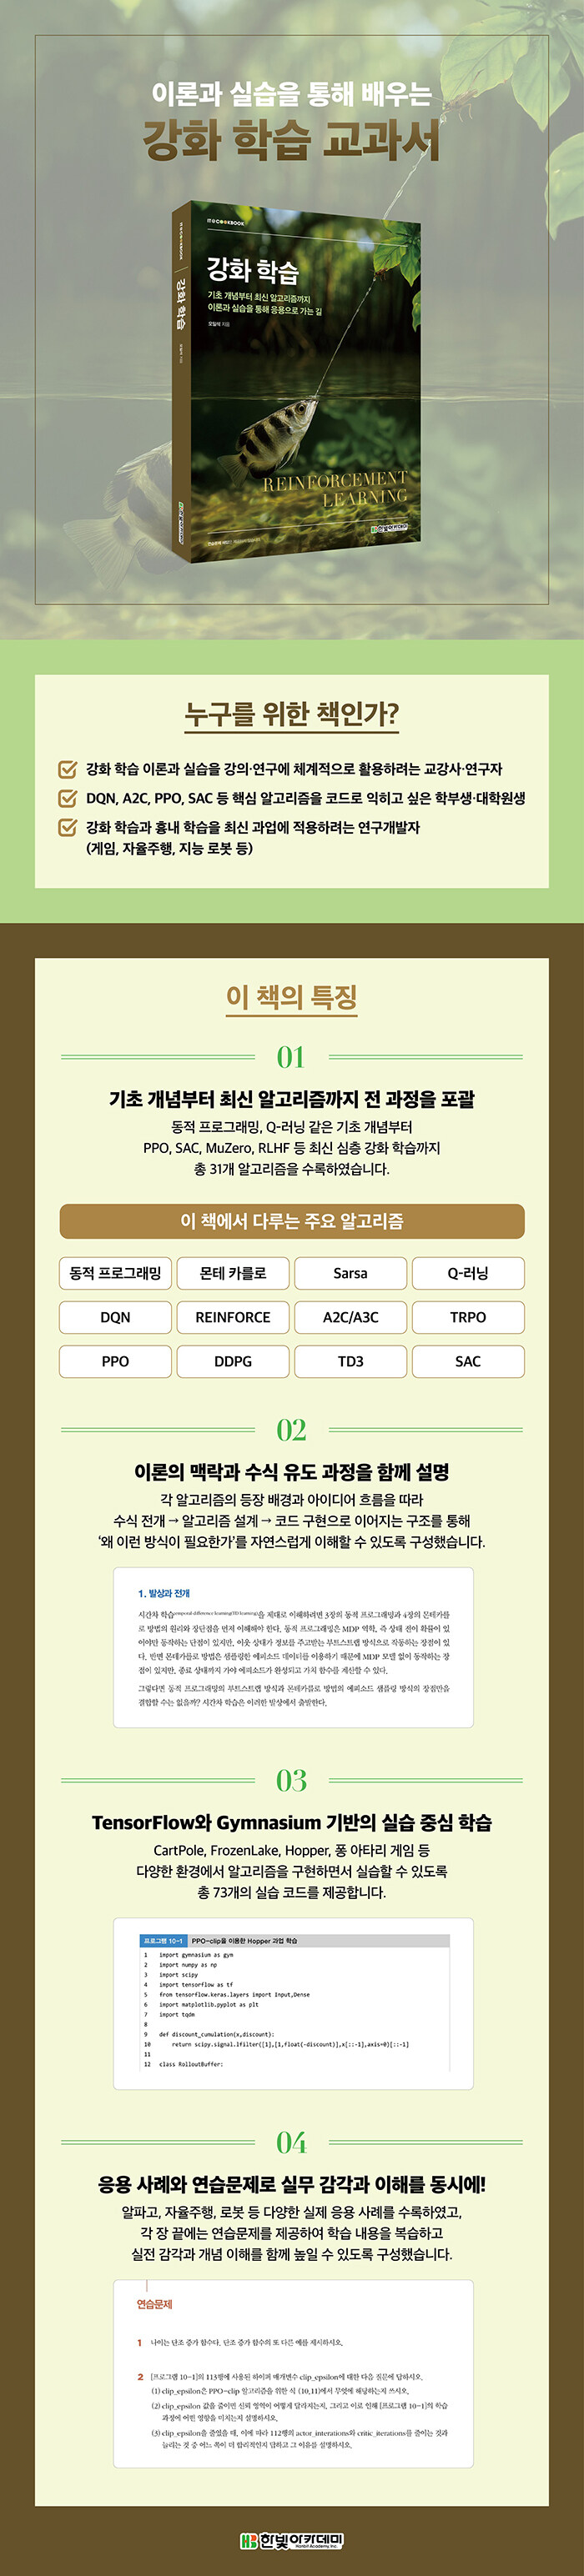
강화 학습의 기초부터 응용까지 체계적으로 배우고자 하는 독자를 대상으로 한다. 먼저 문제 해결을 위한 새로운 아이디어를 소개하고 이를 뒷받침하는 기본 원리를 설명한다. 이어서 수식에 기반한 알고리즘을 제시하고, TensorFlow와 Gymnasium을 사용한 프로그램을 실습하며 알고리즘을 실제 환경에서 직접 구현하고 학습 성능을 평가해 볼 수 있도록 내용을 구성하였다. 또한 전통적인 동적 프로그래밍부터 DQN, PPO, SAC 등 최신 알고리즘까지 다루고 있으며, 자율주행, 지능 로봇, AGI 등 고급 응용 분야와 최신 연구 흐름도 충실히 반영하고 있다.
출판사 리뷰
주요 개념과 알고리즘을 이해하고
실습으로 구현하는 강화 학습 교과서
이 책은 강화 학습의 기초부터 응용까지 체계적으로 배우고자 하는 독자를 대상으로 합니다. 먼저 문제 해결을 위한 새로운 아이디어를 소개하고 이를 뒷받침하는 기본 원리를 설명합니다. 이어서 수식에 기반한 알고리즘을 제시하고, TensorFlow와 Gymnasium을 사용한 프로그램을 실습하며 알고리즘을 실제 환경에서 직접 구현하고 학습 성능을 평가해 볼 수 있도록 내용을 구성하였습니다. 또한 전통적인 동적 프로그래밍부터 DQN, PPO, SAC 등 최신 알고리즘까지 다루고 있으며, 자율주행, 지능 로봇, AGI 등 고급 응용 분야와 최신 연구 흐름도 충실히 반영하고 있습니다.
※ 본 도서는 대학 강의용 교재로 개발되었으므로 연습문제 해답은 제공하지 않습니다.

-
- 저자 : 오일석

CHAPTER 01 소개
1 강화 학습이란
2 기계 학습 = 지도 학습 + 비지도 학습 + 강화 학습
3 성공 사례와 응용 분야
4 간략 역사
5 읽을거리
연습문제
CHAPTER 02 강화 학습 기초 다지기
1 환경과 상호작용하는 에이전트
2 파이썬으로 MDP 프로그래밍
3 랜덤 정책과 최적 정책의 기대 이득 비교
4 정책과 가치 함수
5 강화 학습의 난이도와 접근방법 이해
연습문제
CHAPTER 03 동적 프로그래밍
1 원리
2 벨만 방정식과 정책 반복 알고리즘
3 벨만 최적 방정식과 가치 반복 알고리즘
4 스토캐스틱 과업의 동적 프로그래밍
5 동적 프로그래밍의 특성과 한계
연습문제
CHAPTER 04 몬테카를로 방법
1 에피소드 발생기
2 탐험과 탐사의 균형
3 몬테카를로 방법으로 정책 평가
4 몬테카를로 방법으로 정책 학습
5 성능 향상 기법
연습문제
CHAPTER 05 시간차 학습
1 원리
2 정책 평가
3 Sarsa
4 Q-러닝
5 Q-러닝으로 블랙잭 게임 학습
6 Q-러닝으로 CartPole 학습
7 성능 향상 기법
8 관점 확장
연습문제
CHAPTER 06 신경망을 이용한 근사 방법
1 신경망 기초
2 신경망 구현
3 신경망을 이용한 Q-러닝
4 신경망 기반 Q-러닝 구현: CartPole 과업
5 신경망 기반 Q-러닝 구현: Blackjack 과업
6 신경망에 대한 논쟁과 새로운 길
연습문제
CHAPTER 07 딥러닝 방법
1 딥러닝으로 대전환
2 DQN
3 리플레이 메모리
4 딥러닝 기초
5 아타리 게임 환경
6 DQN을 이용한 퐁 아타리 게임
7 덧붙이는 말
연습문제
CHAPTER 08 정책 그레이디언트 방법
1 정책이 중심인 학습
2 REINFORCE 알고리즘
3 REINFORCE 프로그래밍: 이산 과업
4 연속 과업을 위한 정책 그레이디언트
5 REINFORCE 프로그래밍: 연속 과업
6 파이썬의 배열 연산을 이용한 속도 향상
연습문제
CHAPTER 09 행동가 - 비평가 방법
1 행동가와 비평가의 협력
2 편향-분산 트레이드오프
3 이익 함수
4 A2C와 A3C
5 A2C 프로그래밍: 이산 과업
6 A2C 프로그래밍: 연속 과업
연습문제
CHAPTER 10 신뢰 영역 방법
1 단조 정책 개선
2 TRPO 알고리즘
3 PPO 알고리즘
4 PPO의 효율 향상
5 PPO 프로그래밍: 연속 과업
연습문제
CHAPTER 11 정책 최적화와 DQN의 결합
1 동기와 전개
2 DDPG 학습 알고리즘
3 프로그래밍 실습: DDPG를 이용한 Hopper 과업 학습
4 TD3 학습 알고리즘
5 프로그래밍 실습: TD3을 이용한 Hopper 과업 학습
6 SAC 학습 알고리즘
7 프로그래밍 실습: SAC를 이용한 Hopper 과업 학습
8 벤치마킹 분석
연습문제
CHAPTER 12 흉내 학습
1 발상과 전개
2 행위 복제
3 역강화 학습
4 적대 흉내 학습
5 관찰 흉내
연습문제
CHAPTER 13 고급 응용
1 강화 학습으로 만든 고급 제품: 기회와 도전
2 비디오 게임
3 보드 게임
4 대규모 언어 모델
5 자율주행
6 로봇
7 인공일반지능을 향하여
연습문제
참고문헌
찾아보기

