









출고예상일 안내
주문하신 상품이 한국에서 현지 배송을 위한 출고단계가 이루어질 것으로 예상되는 날짜입니다. 상품을 준비하는 과정에서 내부적인 사정으로 인해 출고예상일에 다소 오차가 생길 수 있습니다.
여러 상품(예약상품포함)을 함께 주문하신 경우 출고예상일이 가장 늦은 날짜에 맞춰 함께 배송됩니다.


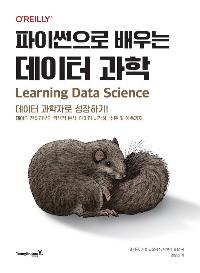





ISBN : 9788931481488 / 696쪽 / 1,322g / 188 x 257 (㎜)
이 상품에 궁금하신점이 있으세요? 1:1상담문의



아래의 도서와 구매하시면 가격이 1.05 원 더 내려갑니다.
-
천인국
-
강수진
-
-
공여사들
- 30,600 →30,599원
- 25,200 →25,199원
- 22,000 →21,999원
- 18,900 →18,899원


반디앤루니스 리뷰
데이터 과학자로 시작하기 위한 이론과 실무 설명서!
이 책은 데이터 과학이 무엇인지 알려줍니다. 잠깐 생겼다가 사라지는 기술이 아닌 데이터 과학의 기본 구성 요소를 제공합니다. 데이터 과학의 한 부분만을 다루는 것이 아닌 데이터를 어떻게 해석하고 전체 주기를 따르면서 데이터 분석의 처음과 끝을 다룰 수 있게 도와주고 있습니다.
이 책은 6개의 부와 21개의 장으로 이루어져 있습니다.
1부 (1-5장)
1부는 데이터 과학 주기 전반을 기초적인 수준으로 훑어보면서 데이터 과학 주기에 대해서 설명
하고, 이 책 전반에서 사용하는 개념을 소개합니다. 이 부는 버스 도착 시간에 대한 짧은 예제로
마무리합니다.
2부 (6-7장)
2부에서는 데이터프레임과 데이터 간의 관계, 판다스(pandas)와 SQL을 사용해서 데이터를 다
루는 코드를 어떻게 작성하는지를 다룹니다.
3부 (8-12장)
3부는 데이터를 획득하고, 데이터의 특징을 탐색하고, 문제점을 찾아내는 것을 다룹니다. 이런
개념을 이해하고 나면, 데이터 파일을 가지고 데이터셋의 흥미로운 점을 발견하고 다른 사람들
에게 제시할 수 있을 것입니다. 이 부는 대기질에 대한 예제로 마무리합니다.
4부 (13-14장)
4부에서는 널리 사용되는 대안 데이터인 텍스트, 바이너리, 인터넷에서 가져오는 데이터에 대
해 살펴봅니다.
5부 (15-18장)
5부에서는 데이터를 사용해서 상황을 이해하는 법을 살펴봅니다. 여기서는 모델 적합, 피처 엔
지니어링, 모델 선택뿐만 아니라 가설 검정과 신뢰 구간 같은 추론 관련 주제도 다룹니다. 이
부의 말미에는 케냐의 수의사들이 당나귀 체중을 예측하는 것에 대한 예제를 다룹니다.
6부 (19-21장)
6부에서는 회귀 분석과 최적화를 사용한 지도 학습을 학습하며 이 책을 마무리합니다. 이 부의
끝에서는 뉴스 기사가 진짜인지 가짜인지 예측하는 예제를 다룹니다.
이 책의 부록에는 이 책에서 소개한 많은 주제에 대해서 더 학습하고자 할 때 필요한 자료와 이 책에서 사용한 데이터셋 목록을 추가했습니다.
【 대상 독자층 】
- 데이터 과학을 처음 배우는 대학생, 직장인
- 통계적 사고와 데이터 분석 실습을 배우고 싶은 사람
- 데이터 과학자의 분석 처리 방법을 단계별로 배워 보고 싶은 사람
출판사 리뷰
이 책은 가장 기본적인 데이터 과학의 주기를 알려주는 것으로 시작합니다. 가장 기초적이면서도 가장 중요한 부분입니다. 데이터를 얻고, 이해하고, 상황을 이해하는 것은 데이터 과학자가 갖춰야 하는 기본적인 소양이라고 할 수 있습니다. 그리고 데이터를 아무리 많이 갖고 있더라도 제대로 된 질문이 없다면 데이터 분석에 의미가 없어집니다. 이 책은 실제 데이터를 다루면서 질문을 시작으로 어떻게 탐색할 수 있는지를 보여줍니다.
이론적으로 생각해야 할 전체적인 과정과 실제 데이터를 통해 어떻게 분석하고 예측할 수 있는지 설명하고 있어 데이터 과학자라면 꼭 필요한 내용을 배울 수 있었습니다.
이 책에 있는 분석 방법과 예제를 반복 학습해 보면서 데이터 과학자에 입문해 보시기 바랍니다.
역자의 말
오늘날 우리는 인공지능(AI)이 많은 것을 해결해 주는 시대에 살고 있습니다. 버튼 하나로 복잡한 데이터 분석이 가능해지고, 정교한 예측 모델이 순식간에 만들어지기도 합니다. 하지만 화려한 기술의 이면에는 여전히 데이터를 이해하고 올바른 질문을 던지며, 분석 결과를 비판적으로 해석하는 ‘사람’의 역할이 중요하게 자리하고 있습니다. 인공지능이라는 강력한 도구를 제대로 활용하는 시대를 맞이하면서, 우리는 데이터 분석의 근간을 이루는 기본 원리와 철학을 명확히 이해하고 있어야 합니다. 그런 의미에서 이 책은 데이터 분석가와 데이터 과학자를 꿈꾸는 이들은 물론, 이미 현업에서 데이터를 다루고 있는 분들에게도 자신의 지식을 점검하고 새로운 영감을 얻을 수 있는 훌륭한 길잡이가 되어줄 것이라고 생각합니다.


-
- 저자 : 샘 라우, 조셉 곤잘레스, 데보라 놀란

-
- 역자 :

1부 데이터 과학 주기
1장 데이터 과학 주기
1.1 데이터 과학 주기의 단계
1.2 데이터 과학 주기를 보여주는 예제
1.3 정리
2장 질문과 데이터 범위
2.1 빅데이터와 새로운 기회
2.2 대상 집단, 접근 프레임, 표본
2.3 수단 및 프로토콜
2.4 자연현상 측정
2.5 정확도
2.6 정리
3장 시뮬레이션과 데이터 설계
3.1 항아리 모델
3.2 예제: 선거 여론조사의 편향과 변동 시뮬레이션
3.3 예제: 백신 무작위 임상시험 시뮬레이션
3.4 예시: 대기질 측정
3.5 정리
4장 요약 통계량 모델링
4.1 상수 모델
4.2 손실 최소화
4.3 정리
5장 예제: 왜 내가 타는 버스는 맨날 늦을까?
5.1 질문과 범위
5.2 데이터 전처리
5.3 버스 시간 탐색
5.4 대기 시간 모델링
5.5 정리
2부 테이블 데이터
6장 Pandas를 사용한 데이터 프레임 다루기
6.1 나누기
6.2 집계
6.3 조인
6.4 변환
6.5 데이터 프레임은 다른 데이터 표현형과 어떻게 다를까?
6.6 정리
7장 SQL을 사용해서 관계형 데이터 다루기
7.1 나누기
7.2 집계
7.3 조인
7.4 변환과 공통 테이블 표현식(CTE)
7.5 정리
3부 데이터 이해
8장 파일 처리
8.1 데이터 예제
8.2 파일 형식
8.3 파일 인코딩
8.4 파일 크기
8.5 쉘과 명령어
8.6 테이블의 형태 및 구분 방식
8.7 정리
9장 데이터 프레임 전처리
9.1 예제: 마우나 로아 관측소에서의 CO_2 측정치 전처리
9.2 품질 확인
9.3 결측치와 기록
9.4 데이터 변환과 타임스탬프
9.5 구조 변경
9.6 예제: 식당 안전성 위반 사항 전처리
9.7 정리
10장 탐색적 데이터 분석
10.1 특성 유형
10.2 분포를 확인할 때
10.3 관계를 확인할 때
10.4 다변량 경우의 비교
10.5 탐색 시의 지침 사항
10.6 예제: 주택 거래가
10.7 정리
11장 데이터 시각화
11.1 구조 파악을 위한 축의 범위 선택
11.2 데이터 평활법과 집계
11.3 의미 있는 비교 유도하기
11.4 데이터 설계 통합
11.5 맥락 추가하기
11.6 plotly를 사용해서 그래프 그리기
11.7 그 외 시각화 도구
11.8 정리
12장 예제: 대기질 측정 내용은 얼마나 정확할까요?
12.1 질문, 설계, 범위
12.2 근처에 배치된 센서 찾기
12.3 AQS 센서 데이터 전처리
12.4 퍼플에어 센서 데이터 전처리
12.5 퍼플에어와 AQS 측정치 탐색
12.6 퍼플에어 측정치 보정을 위한 모델 생성
12.7 정리
4부 다른 유형의 데이터
13장 텍스트 다루기
13.1 텍스트와 처리 작업 예제
13.2 문자열 조작
13.3 정규표현식
13.4 텍스트 분석
13.5 정리
14장 데이터 교환
14.1 NetCDF 데이터
14.2 JSON 데이터
14.3 HTTP
14.4 REST
14.5 XML, HTML 및 XPath
14.6 정리
5부 선형 모델링
15장 선형 모델링
15.1 단순 선형 모델
15.2 예제: 대기질 측정을 위한 단순 선형 모델
15.3 단순 선형 모델 적합화
15.4 다중 선형 모델
15.5 다중 선형 모델 적합화
15.6 예제: 어디에 기회의 땅이 있습니까?
15.7 수치 측정치를 위한 특성 공학
15.8 범주형 측정치를 위한 특성 공학
15.9 정리
16장 모델 선택
16.1 과적합
16.2 훈련-테스트 분할
16.3 교차 검증
16.4 정규화
16.5 모델 편향 및 분산
16.6 정리
17장 추론 및 예측 이론
17.1 분포: 모집단, 경험치, 표본 추출
17.2 가설검정의 기본 사항
17.3 추론을 위한 부트스트랩
17.4 신뢰 구간의 기본 사항
17.5 예측 구간의 기본 사항
17.6 추론 및 예측을 위한 확률
17.7 정리
18장 예제: 당나귀의 체중을 재는 법
18.1 당나귀 연구의 질문 및 범위
18.2 전처리 및 변환
18.3 탐색
18.4 당나귀의 체중 모델링
18.5 정리
6부 분류
19장 분류
19.1 예제: 바람에 피해를 입은 나무
19.2 모델링 및 분류
19.3 비율(및 확률) 모델링
19.4 로지스틱 모델의 손실 함수
19.5 확률에서 분류로
19.6 정리
20장 수치 최적화
20.1 경사 하강법의 기본 사항
20.2 후버 손실 최소화하기(Minimizing Huber Loss)
20.3 볼록하고 미분 가능한 손실 함수
20.4 경사 하강법의 변형
20.5 정리
21장 예제: 가짜 뉴스 탐지
21.1 질문과 범위
21.2 데이터 수집 및 전처리
21.3 데이터 탐색
21.4 모델링
21.5 정리
부록 1 추가 자료
부록 2 데이터 원본

