









출고예상일 안내
주문하신 상품이 한국에서 현지 배송을 위한 출고단계가 이루어질 것으로 예상되는 날짜입니다. 상품을 준비하는 과정에서 내부적인 사정으로 인해 출고예상일에 다소 오차가 생길 수 있습니다.
여러 상품(예약상품포함)을 함께 주문하신 경우 출고예상일이 가장 늦은 날짜에 맞춰 함께 배송됩니다.


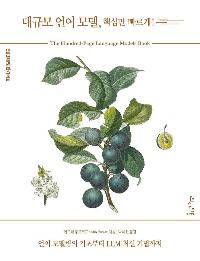





ISBN : 9788966264940 / 220쪽 / 418g / 172 x 225 (㎜)
이 상품에 궁금하신점이 있으세요? 1:1상담문의



아래의 도서와 구매하시면 가격이 .7 원 더 내려갑니다.
-
-
-
김지희(릴스 마법사 롱제이)
-
최영규, 천인국
- 20,000 →19,999원
- 13,500 →13,499원
- 20,700 →20,699원
- 26,100 →26,099원



반디앤루니스 리뷰
복잡한 이론은 덜고, 꼭 필요한 핵심만 담았다!
언어 모델링을 익히는 가장 간결한 안내서
이 책은 안드리 부르코프의 베스트셀러 《머신러닝, 핵심만 빠르게!》의 후속작으로, 언어 모델링의 기초부터 시작하여 최신 대규모 언어 모델(LLM)을 간결하면서도 철저하게 다룬다. 독자들은 이 책을 통해 현대 머신러닝과 신경망의 수학적 기초, 파이썬으로 구현하는 카운트, RNN 기반 언어 모델, 파이토치로 직접 만드는 트랜스포머, LLM 실습(지시 미세 튜닝, 프롬프트 엔지니어링)까지 체계적으로 학습할 수 있다.
실행 가능한 파이썬 코드와 구글 코랩 환경을 기반으로 실습형으로 구성된 이 책은 누구나 단계별로 따라가며 이해를 확장할 수 있다. 언어 모델이 단순한 n-그램 통계에서 출발해 오늘날 AI의 핵심 기술로 성장해 온 과정을 카운트 기반 방.법부터 시작해서 최신 트랜스포머 아키텍처까지 설명하며, 원리와 구현을 함께 다룬다. 각 장은 앞선 내용을 토대로 점진적으로 발전하며, 복잡한 개념도 명확한 설명과 그림, 실습을 통해 쉽게 이해할 수 있도록 구성되어 있다.
이 책에서 다루는 내용
ㆍ머신러닝과 신경망의 핵심 개념
ㆍ텍스트 표현 기법과 기본 언어 모델링
ㆍ파이토치로 RNN과 트랜스포머 구현하기
ㆍ언어 모델의 미세 튜닝과 프롬프트 엔지니어링 실무 지침
ㆍ환각 문제와 모델 평가에 관한 주요 고려 사항
출판사 리뷰
대규모 언어 모델(large language model, LLM)의 등장으로 모든 것이 바뀌었습니다. 처음으로 컴퓨터가 사람과 유창하게 대화하고 놀라울 정도로 정확하게 음성 지시를 따를 수 있게 되었습니다. 하지만 모든 도구와 마찬가지로 이런 모델의 엄청난 능력에는 한계가 있습니다. 일부는 다루기 쉽지만, 어떤 것은 미묘하며, 적절히 다루기 위해 고도의 전문 기술이 필요합니다. 도구에 대해 완전히 이해하지 못한 채 마천루를 세우려고 한다면 결국에는 산더미처럼 쌓인 콘크리트와 철근만 남을 뿐입니다. 언어 모델도 마찬가지입니다. 대규모 텍스트 처리를 수행하거나 신뢰할 만한 상용 제품을 만들려면 정밀함과 지식이 필요합니다. 추측은 고려 대상이 아닙니다.
- '지은이의 글' 중에서
추천사
빈트 서프 (인터넷 개척자이자 튜링상 수상자)
“이 책은 머신러닝이 실제로 어떻게 작동하는지에 관한 개념적 혼란을 정리해 준다.
머신러닝을 명료하게 담아낸 보석 같은 책이다.”
토마시 미콜로프 (word2vec와 FastText의 개발자)
“언어 모델링에 처음 발을 들여 최첨단을 향해 나아가고자 하는 이들에게 훌륭한 출발점이다.”
플로리앙 두에토 (Dataiku의 공동 창업자 겸 CEO)
“안드리는 선형대수 기초부터 트랜스포머 구현까지 100여 번의 멋진 붓질로 여정을 그려낸다.”
제리 리우 (LlamaIndex의 공동 창업자 겸 CEO)
“LLM의 내부 작동 원리를 깊이 이해할 수 있는 가장 포괄적이면서도 간결한 안내서 중 하나다.”
호르헤 토레스 (MindsDB의 CEO)
“안드리는 거대한 AI 개념을 한 입 크기로 줄여, 독자가 ‘이제 이해했어!’라고 느끼게 만드는 거의 초자연적인 재능을 가지고 있다.”

-
- 저자 : 안드리 부르코프

-
- 역자 : 박해선

옮긴이의 글
추천의 글
지은이의 글
1장 머신러닝 기초
1.1 AI와 머신러닝
1.2 모델
1.3 네 단계 머신러닝 프로세스
1.4 벡터
1.5 신경망
1.6 행렬
1.7 경사 하강법
1.8 자동 미분
2장 언어 모델링 기초
2.1 BoW
2.2 단어 임베딩
2.3 바이트 페어 인코딩
2.4 언어 모델
2.5 카운트 기반 언어 모델
2.6 언어 모델 평가
2.6.1 혼잡도
2.6.2 ROUGE
2.6.3 사람의 평가
3장 순환 신경망
3.1 엘만 RNN
3.2 미니 배치 경사 하강법
3.3 RNN 구현하기
3.4 RNN 언어 모델
3.5 임베딩 층
3.6 RNN 언어 모델 훈련시키기
3.7 Dataset과 DataLoader
3.8 훈련 데이터와 손실 계산
4장 트랜스포머
4.1 디코더 블록
4.2 셀프 어텐션
4.3 위치별 다층 퍼셉트론
4.4 로터리 위치 임베딩
4.5 멀티헤드 어텐션
4.6 잔차 연결
4.7 RMS 정규화
4.8 키-값 캐싱
4.9 트랜스포머 구현
5장 대규모 언어 모델
5.1 규모가 클수록 좋은 이유
5.1.1 대규모 파라미터 개수
5.1.2 큰 문맥 크기
5.1.3 대규모 훈련 데이터셋
5.1.4 대량의 계산량
5.2 지도 학습 미세 튜닝
5.3 사전훈련된 모델 미세 튜닝하기
5.3.1 기준 감정 분류기
5.3.2 감정 레이블 생성하기 |
5.3.3 지시를 따르도록 미세 튜닝하기
5.4 언어 모델의 샘플링
5.4.1 온도를 사용한 기본 샘플링
5.4.2 탑-k 샘플링
5.4.3 뉴클리어스(탑-p) 샘플링
5.4.4 페널티
5.5 LoRA
5.5.1 핵심 아이디어
5.5.2 PEFT
5.6 분류용 LLM
5.7 프롬프트 엔지니어링
5.7.1 좋은 프롬프트의 특징
5.7.2 행동에 대한 후속조치
5.7.3 코드 생성
5.7.4 문서 동기화
5.8 환각 182
5.8.1 환각의 원인
5.8.2 환각 방지
5.9 LLM, 저작권, 윤리
5.9.1 훈련 데이터
5.9.2 생성된 콘텐츠
5.9.3 오픈 웨이트 모델
5.9.4 광범위한 윤리적 고려사항
6장 추가 자료
6.1 MoE
6.2 모델 병합
6.3 모델 압축
6.4 선호도 기반 정렬
6.5 고급 추론
6.6 언어 모델 보안
6.7 비전 언어 모델
6.8 과대적합 방지
6.9 맺음말
6.10 저자의 다른 책

