









출고예상일 안내
주문하신 상품이 한국에서 현지 배송을 위한 출고단계가 이루어질 것으로 예상되는 날짜입니다. 상품을 준비하는 과정에서 내부적인 사정으로 인해 출고예상일에 다소 오차가 생길 수 있습니다.
여러 상품(예약상품포함)을 함께 주문하신 경우 출고예상일이 가장 늦은 날짜에 맞춰 함께 배송됩니다.


밑바닥부터 만들면서 배우는 LLM GPT를 내 손으로 직접 단계별로 만들어보면서 대규모 언어 모델의 기본기를 탄탄히 채우기

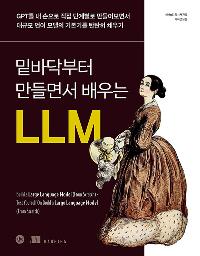





ISBN : 9791140715848 / 560쪽 / 1,064g / 183 x 235 (㎜)
이 상품에 궁금하신점이 있으세요? 1:1상담문의



아래의 도서와 구매하시면 가격이 1.17 원 더 내려갑니다.
-
-
-
-
김지희(릴스 마법사 롱제이)
- 27,000 →26,999원
- 16,200 →16,199원
- 24,300 →24,299원
- 20,700 →20,699원



반디앤루니스 리뷰
대규모 언어 모델의 구조와 동작 원리를 처음부터 끝까지 직접 구현하며 학습할 수 있는 실전형 LLM 입문서다. 단순히 개념을 설명하는 데 그치지 않고 텍스트 전처리와 토큰화, 임베딩 과정을 출발점으로 삼아, 셀프 어텐션과 멀티헤드 어텐션, 트랜스포머 블록을 차근차근 구축해 나간다. 이어서 이러한 구성 요소들을 통합하여 실제 GPT 모델을 완성하고, 모델의 파라미터 수와 훈련 안정화 기법, 활성화 함수와 정규화 방법 등 최신 아키텍처 설계의 핵심 요소들을 직접 다뤄본다.
또한 사전 학습과 미세 튜닝 과정을 깊이 있게 안내한다. 레이블 없는 데이터에서 사전 훈련을 진행하고, 텍스트 분류와 같은 다운스트림 작업에 맞춰 모델을 튜닝하며, 최근 각광받는 지시 기반 학습 기법까지 실습할 수 있다. LoRA 기반의 파라미터 효율적 미세 조정(PEFT) 같은 최신 내용도 담아 LLM을 실제 서비스와 연구에 연결할 수 있는 방법까지 폭넓게 제시한다. 모든 개념은 파이토치 코드로 구현되어 있으며, 일반 노트북 환경에서도 실습할 수 있도록 최적화했다.
출판사 리뷰


-
- 저자 : 세바스찬 라시카

-
- 역자 : 박해선

1장 대규모 언어 모델 이해하기
1.1 LLM이란 무엇인가요?
1.2 LLM 애플리케이션
1.3 LLM의 구축 단계
1.4 트랜스포머 구조 소개
1.5 대규모 데이터셋 활용하기
1.6 GPT 구조 자세히 살펴보기
1.7 대규모 언어 모델 만들기
1.8 요약
2장 텍스트 데이터 다루기
2.1 단어 임베딩 이해하기
2.2 텍스트 토큰화하기
2.3 토큰을 토큰 ID로 변환하기
2.4 특수 문맥 토큰 추가하기
2.5 바이트 페어 인코딩
2.6 슬라이딩 윈도로 데이터 샘플링하기
2.7 토큰 임베딩 만들기
2.8 단어 위치 인코딩하기
2.9 요약
3장 어텐션 메커니즘 구현하기
3.1 긴 시퀀스 모델링의 문제점
3.2 어텐션 메커니즘으로 데이터 의존성 포착하기
3.3 셀프 어텐션으로 입력의 서로 다른 부분에 주의 기울이기
__3.3.1 훈련 가능한 가중치가 없는 간단한 셀프 어텐션 메커니즘
__3.3.2 모든 입력 토큰에 대해 어텐션 가중치 계산하기
3.4 훈련 가능한 가중치를 가진 셀프 어텐션 구현하기
__3.4.1 단계별로 어텐션 가중치 계산하기
__3.4.2 셀프 어텐션 파이썬 클래스 구현하기
3.5 코잘 어텐션으로 미래의 단어를 감추기
__3.5.1 코잘 어텐션 마스크 적용하기
__3.5.2 드롭아웃으로 어텐션 가중치에 추가적으로 마스킹하기
__3.5.3 코잘 어텐션 클래스 구현하기
3.6 싱글 헤드 어텐션을 멀티 헤드 어텐션으로 확장하기
__3.6.1 여러 개의 싱글 헤드 어텐션 층 쌓기
__3.6.2 가중치 분할로 멀티 헤드 어텐션 구현하기
3.7 요약
4장 밑바닥부터 GPT 모델 구현하기
4.1 LLM 구조 구현하기
4.2 층 정규화로 활성화 정규화하기
4.3 GELU 활성화 함수를 사용하는 피드 포워드 네트워크 구현하기
4.4 숏컷 연결 추가하기
4.5 어텐션과 선형 층을 트랜스포머 블록에 연결하기
4.6 GPT 모델 만들기
4.7 텍스트 생성하기
4.8 요약
5장 레이블이 없는 데이터를 활용한 사전 훈련
5.1 텍스트 생성 모델 평가하기
__5.1.1 GPT를 사용해 텍스트 생성하기
__5.1.2 텍스트 생성 손실 계산하기
__5.1.3 훈련 세트와 검증 세트의 손실 계산하기
5.2 LLM 훈련하기
5.3 무작위성을 제어하기 위한 디코딩 전략
__5.3.1 온도 스케일링
__5.3.2 탑-k 샘플링
__5.3.3 텍스트 생성 함수 수정하기
5.4 파이토치로 모델 로드하고 저장하기
5.5 오픈AI에서 사전 훈련된 가중치 로드하기
5.6 요약
6장 분류를 위해 미세 튜닝하기
6.1 여러 가지 미세 튜닝 방법
6.2 데이터셋 준비
6.3 데이터 로더 만들기
6.4 사전 훈련된 가중치로 모델 초기화하기
6.5 분류 헤드 추가하기
6.6 분류 손실과 정확도 계산하기
6.7 지도 학습 데이터로 모델 미세 튜닝하기
6.8 LLM을 스팸 분류기로 사용하기
6.9 요약
7장 지시를 따르도록 미세 튜닝하기
7.1 지시 미세 튜닝 소개
7.2 지도 학습 지시 미세 튜닝을 위해 데이터셋 준비하기
7.3 훈련 배치 만들기
7.4 지시 데이터셋을 위한 데이터 로더 만들기
7.5 사전 훈련된 LLM 로드하기
7.6 지시 데이터에서 LLM 미세 튜닝하기
7.7 응답을 추출하여 저장하기
7.8 미세 튜닝된 LLM 평가하기
7.9 결론
__7.9.1 다음 단계는?
__7.9.2 빠르게 발전하는 분야의 최신 정보 얻기
__7.9.3 맺음말
7.10 요약
부록 A 파이토치 소개
A.1 파이토치란 무엇인가요?
__A.1.1 파이토치의 세 가지 핵심 요소
__A.1.2 딥러닝이란?
__A.1.3 파이토치 설치
A.2 텐서 이해하기
__A.2.1 스칼라, 벡터, 행렬, 텐서
__A.2.2 텐서 데이터 타입
__A.2.3 자주 사용하는 파이토치 텐서 연산
A.3 모델을 계산 그래프로 보기
A.4 자동 미분을 손쉽게
A.5 다층 신경망 만들기
A.6 효율적인 데이터 로더 설정하기
A.7 일반적인 훈련 루프
A.8 모델 저장과 로드
A.9 GPU로 훈련 성능 최적화하기
__A.9.1 GPU 장치를 사용한 파이토치 계산
__A.9.2 단일 GPU 훈련
__A.9.3 다중 GPU 훈련
A.10 요약
부록 B 참고 및 더 읽을 거리
부록 C 연습문제 해답
부록 D 훈련 루프에 부가 기능 추가하기
D.1 학습률 웜업
D.2 코사인 감쇠
D.3 그레이디언트 클리핑
D.4 수정된 훈련 함수
부록 E LoRA를 사용한 파라미터 효율적인 미세 튜닝
E.1 LoRA 소개
E.2 데이터셋 준비하기
E.3 모델 초기화하기
E.4 LoRA를 사용한 파라미터 효율적인 미세 튜닝
[워크북 목차]
1장 대규모 언어 모델 이해하기
2장 텍스트 데이터 다루기
3장 어텐션 메커니즘 구현하기
4장 밑바닥부터 GPT 모델 구현하기
5장 레이블이 없는 데이터를 활용한 사전 훈련
6장 분류를 위해 미세 튜닝하기
7장 지시를 따르도록 미세 튜닝하기
부록 A 파이토치 소개
부록 D 훈련 루프에 부가 기능 추가하기
부록 E LoRA를 사용한 파라미터 효율적인 미세 튜닝

