









출고예상일 안내
주문하신 상품이 한국에서 현지 배송을 위한 출고단계가 이루어질 것으로 예상되는 날짜입니다. 상품을 준비하는 과정에서 내부적인 사정으로 인해 출고예상일에 다소 오차가 생길 수 있습니다.
여러 상품(예약상품포함)을 함께 주문하신 경우 출고예상일이 가장 늦은 날짜에 맞춰 함께 배송됩니다.


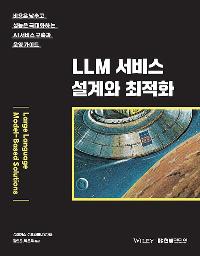





ISBN : 9791169213646 / 296쪽 / 562g / 183 x 235 (㎜)
이 상품에 궁금하신점이 있으세요? 1:1상담문의



아래의 도서와 구매하시면 가격이 .93 원 더 내려갑니다.
-
최영규, 천인국
-
윤인성
-
-
- 26,100 →26,099원
- 25,200 →25,199원
- 16,200 →16,199원
- 13,500 →13,499원

- 컴퓨터/IT > 컴퓨터공학 > 인공지능/신경망/퍼지

반디앤루니스 리뷰
AI와 머신러닝의 발전으로 거대 언어 모델(LLM)에 대한 관심은 급증했지만, 높은 비용 때문에 수많은 기업이 도입을 주저하고 있다. 이 책은 적은 비용으로 LLM을 구축하고 배포하는 효율적인 접근법을 소개한다. 모델 선택, 프롬프트 엔지니어링, 파인튜닝, 배포의 각 단계에서 성능 저하를 최소화 하면서 비용을 효과적으로 최소화하는 방법을 만나 보자.
검색 시스템이나 AI 에이전트와 같은 생성형 AI 애플리케이션 구현에 필요한 실용적이고 기술적인 지식을 제공한다. 모델 양자화, 스케일링 등의 추론 최적화 기법과 인프라 비용 절감 방법을 탐구하여 생성형 AI 서비스의 경쟁력을 강화해 보자.
출판사 리뷰


-
- 저자 : 슈레야스 수브라마니암

-
- 역자 : 김현준, 박은주

CHAPTER 1 LLM 기초
_1.1 생성형 AI 애플리케이션과 LLM
_1.2 생성형 AI 애플리케이션의 상용화를 위한 길
_1.3 비용 최적화의 중요성
_1.4 요약
CHAPTER 2 비용 최적화를 위한 튜닝 기법
_2.1 파인튜닝 및 커스터마이징
_2.2 파라미터 효율적 파인튜닝(PEFT)
_2.3 PEFT의 비용 및 성능에 대한 영향
_2.4 요약
CHAPTER 3 비용 최적화를 위한 추론 테크닉
_3.1 추론 테크닉 소개
_3.2 프롬프트 엔지니어링
_3.3 벡터 스토어를 이용한 캐싱
_3.4 긴 문서를 관리하는 체인
_3.5 텍스트 요약
_3.6 효율적인 추론을 위한 배칭 프롬프트
_3.7 모델 최적화 방법
_3.8 파라미터 효율적 파인튜닝(PEFT)
_3.9 비용 및 성능 영향
_3.10 요약
CHAPTER 4 모델 선택과 대안
_4.1 모델 선택의 중요성
_4.2 효율적인 소형 모델
_4.3 성공적인 소형 모델 사례
_4.4 도메인 특화 모델
_4.5 범용 모델을 활용한 프롬프트의 성능
_4.6 요약
CHAPTER 5 인프라 및 배포 튜닝 전략
_5.1 튜닝 전략
_5.2 하드웨어 활용 및 배치 튜닝
_5.3 추론 가속화 도구
_5.4 모니터링과 옵저버빌리티
_5.5 요약
CHAPTER 6 성공적인 생성형 AI 도입의 열쇠
_6.1 성능과 비용의 균형
_6.2 생성형 AI 애플리케이션의 미래 트렌드
_6.3 요약

