









출고예상일 안내
주문하신 상품이 한국에서 현지 배송을 위한 출고단계가 이루어질 것으로 예상되는 날짜입니다. 상품을 준비하는 과정에서 내부적인 사정으로 인해 출고예상일에 다소 오차가 생길 수 있습니다.
여러 상품(예약상품포함)을 함께 주문하신 경우 출고예상일이 가장 늦은 날짜에 맞춰 함께 배송됩니다.


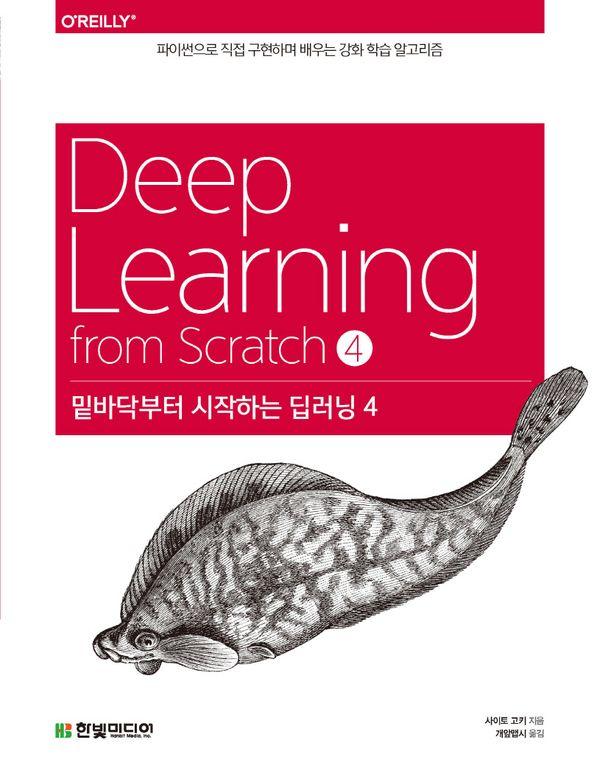





ISBN : 9791169211956 / 372쪽 / 707g / 183 x 235 (㎜)
이 상품에 궁금하신점이 있으세요? 1:1상담문의



아래의 도서와 구매하시면 이 도서들의 적립금을 즉시적용해 드립니다.
-
엥지유니버스
-
-

서길원, 김운호, 허상훈, 박재상, 박경규, 김종욱, 오윤우, 유지영
-
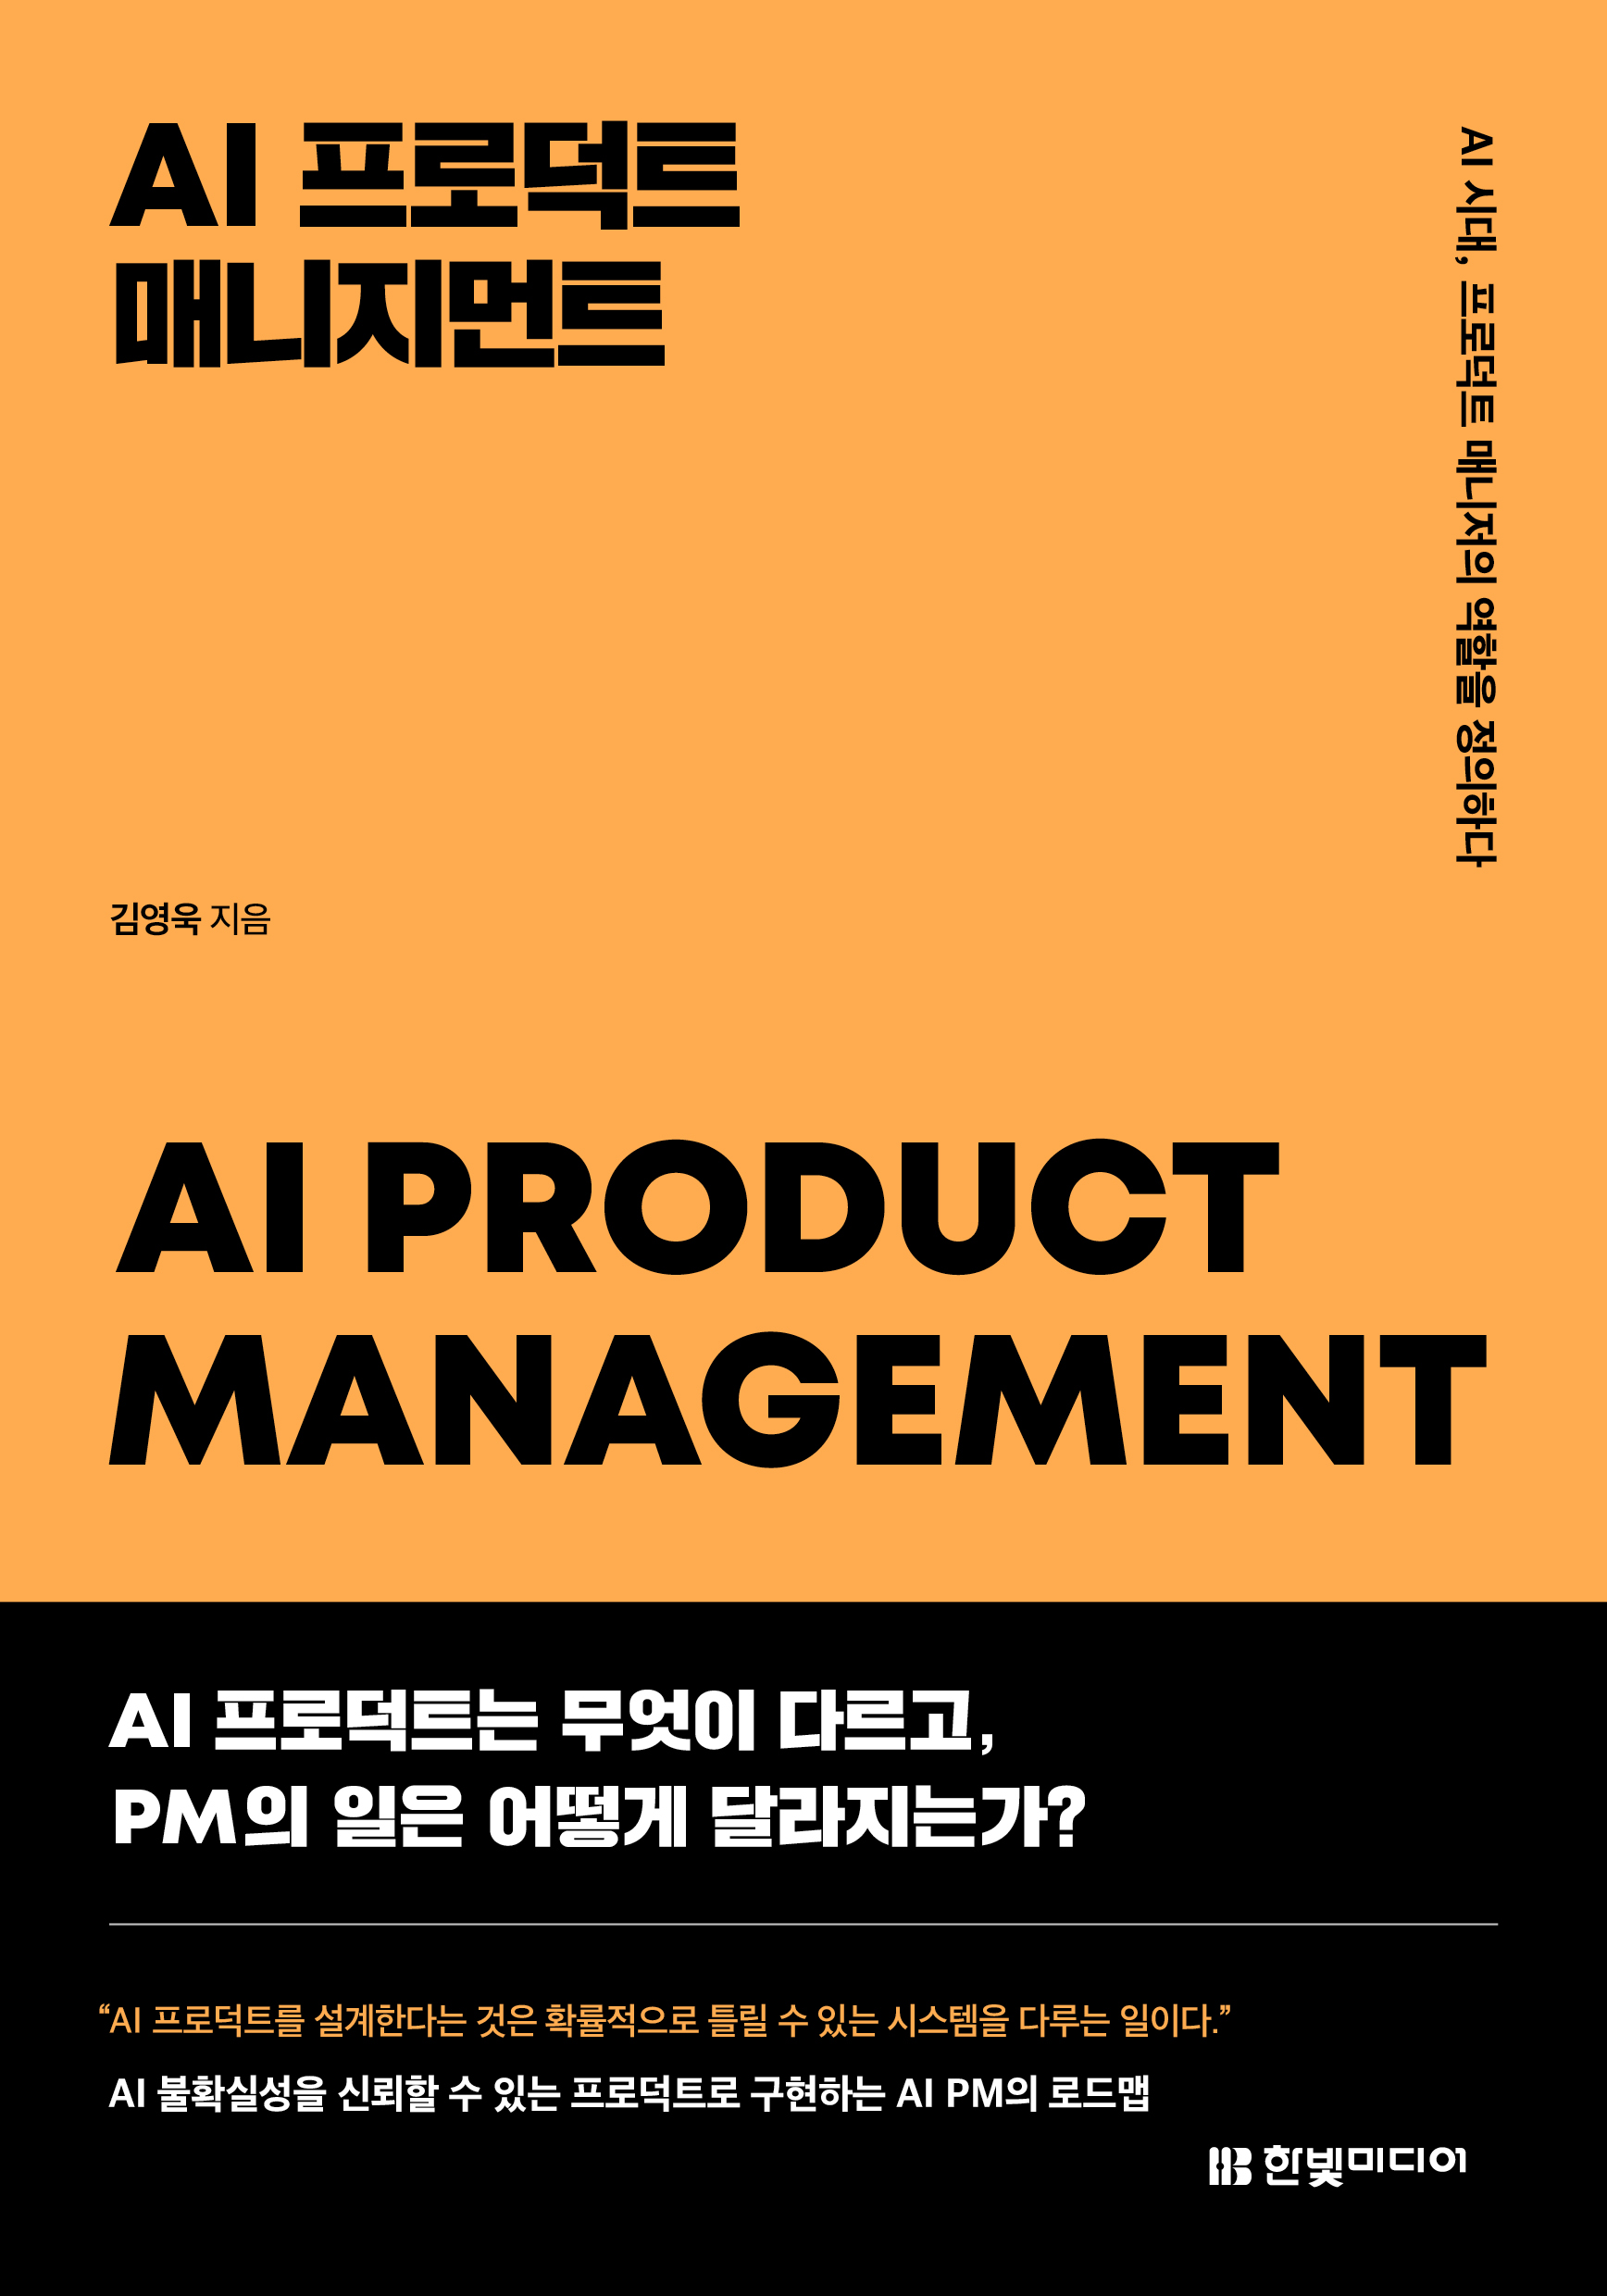
김영욱
- 27,000
- 17,550
- 31,500
- 23,400



출판사 리뷰
강화 학습 마스터의 지름길은 기초를 다지는 것! 딥러닝은 매우 핫한 분야여서 하루가 멀다 하고 새로운 알고리즘과 응용 사례가 발표되고 있습니다. 엄청난 발전 속도에 따라 관련 기술과 서비스도 빠르게 진화해서, 이전에는 유행이었던 것들이 지금은 사라지기도 합니다. 하지만 한편으로는 변하지 않고 전해져 내려오는 것도 있죠. 이 책에서는 배우는 지식이 바로 그 변하지 않는 것입니다. 강화 학습의 기초를 이루는 아이디어와 기술은 예나 지금이나 변함이 없습니다. 최신 알고리즘도 오래전부터 존재해온 아이디어를 토대로 합니다. 강화 학습의 기본 원리, 마르코프 결정 과정, 벨만 방정식, Q 러닝, 신경망 등과 같은 주제는 앞으로도 변함없이 중요하게 여겨질 것입니다. 따라서 현재의 강화 학습, 나아가 심층 강화 학습까지 이해하려면 강화 학습의 기초부터 차근차근 학습하는 것이 오히려 지름길입니다. 파이썬과 수학에 대한 기초만 있다면 읽을 수 있도록 수식 기호 하나하나, 코드 한 줄 한 줄 친절히 설명합니다. 이 책으로 강화 학습의 기초를 제대로 배우고 ‘변하지 않는 것’의 아름다움을 맛보기 바랍니다. 여러분 곁에 포스가 함께 하기를… 대상 독자 - 강화 학습의 원리를 제대로 배우고자 하는 독자 - 딥러닝을 더 깊게 이해하고 싶은 개발자 - 파이썬 지식이 있으며 딥러닝과 강화 학습에 흥미가 있는 데이터 과학 입문자 주요 내용 - 여러 후보 가운데 가장 좋은 것을 순차적으로 찾는 '밴디트 문제' 풀어보기(1장) - 일반적인 강화 학습 문제를 ‘마르코프 결정 과정’으로 정의하기(2장) - 마르코프 결정 과정에서 최적의 답을 찾는 데 핵심이 되는 ‘벨만 방정식’ 도출하기(3장) - 벨만 방정식을 풀기 위한 방법: 동적 프로그래밍(4장), 몬테카를로법(5장), TD법(6장) - 딥러닝에 대해 알아보고 딥러닝을 강화 학습 알고리즘에 적용하기(7장) - DQN을 구현하고 DQN을 확장한 방법 알아보기(8장) - DQN과는 다른 접근법: ‘정책 경사법’ 알고리즘(9장) - A3C/DDPG/TRPO/레인보우 알고리즘과 심층 강화 학습(10장)

-
- 저자 : 사이토 고키

CHAPTER 1 밴디트 문제
_1.1 머신러닝 분류와 강화 학습
_1.2 밴디트 문제
_1.3 밴디트 알고리즘
_1.4 밴디트 알고리즘 구현
_1.5 비정상 문제
_1.6 정리
CHAPTER 2 마르코프 결정 과정
_2.1 마르코프 결정 과정(MDP)이란?
_2.2 환경과 에이전트를 수식으로
_2.3 MDP의 목표
_2.4 MDP 예제
_2.5 정리
CHAPTER 3 벨만 방정식
_3.1 벨만 방정식 도출
_3.2 벨만 방정식의 예
_3.3 행동 가치 함수(Q 함수)와 벨만 방정식
_3.4 벨만 최적 방정식
_3.5 벨만 최적 방정식의 예
_3.6 정리
CHAPTER 4 동적 프로그래밍
_4.1 동적 프로그래밍과 정책 평가
_4.2 더 큰 문제를 향해
_4.3 정책 반복법
_4.4 정책 반복법 구현
_4.5 가치 반복법
_4.6 정리
CHAPTER 5 몬테카를로법
_5.1 몬테카를로법 기초
_5.2 몬테카를로법으로 정책 평가하기
_5.3 몬테카를로법 구현
_5.4 몬테카를로법으로 정책 제어하기
_5.5 오프-정책과 중요도 샘플링
_5.6 정리
CHAPTER 6 TD법
_6.1 TD법으로 정책 평가하기
_6.2 SARSA
_6.3 오프-정책 SARSA
_6.4 Q 러닝
_6.5 분포 모델과 샘플 모델
_6.6 정리
CHAPTER 7 신경망과 Q 러닝
_7.1 DeZero 기초
_7.2 선형 회귀
_7.3 신경망
_7.4 Q 러닝과 신경망
_7.5 정리
CHAPTER 8 DQN
_8.1 OpenAI Gym
_8.2 DQN의 핵심 기술
_8.3 DQN과 아타리
_8.4 DQN 확장
_8.5 정리
CHAPTER 9 정책 경사법
_9.1 가장 간단한 정책 경사법
_9.2 REINFORCE
_9.3 베이스라인
_9.4 행위자-비평자
_9.5 정책 기반 기법의 장점
_9.6 정리
CHAPTER 10 한 걸음 더
_10.1 심층 강화 학습 알고리즘 분류
_10.2 정책 경사법 계열의 고급 알고리즘
_10.3 DQN 계열의 고급 알고리즘
_10.4 사례 연구
_10.5 심층 강화 학습이 풀어야 할 숙제와 가능성
_10.6 정리
APPENDIX A 오프-정책 몬테카를로법
A.1 오프-정책 몬테카를로법 이론
A.2 오프-정책 몬테카를로법 구현
APPENDIX B n단계 TD법
APPENDIX C Double DQN 이해하기
C.1 DQN에서의 과대적합이란?
C.2 과대적합 해결 방법
APPENDIX D 정책 경사법 증명
D.1 정책 경사법 도출
D.2 베이스라인 도출

