









출고예상일 안내
주문하신 상품이 한국에서 현지 배송을 위한 출고단계가 이루어질 것으로 예상되는 날짜입니다. 상품을 준비하는 과정에서 내부적인 사정으로 인해 출고예상일에 다소 오차가 생길 수 있습니다.
여러 상품(예약상품포함)을 함께 주문하신 경우 출고예상일이 가장 늦은 날짜에 맞춰 함께 배송됩니다.


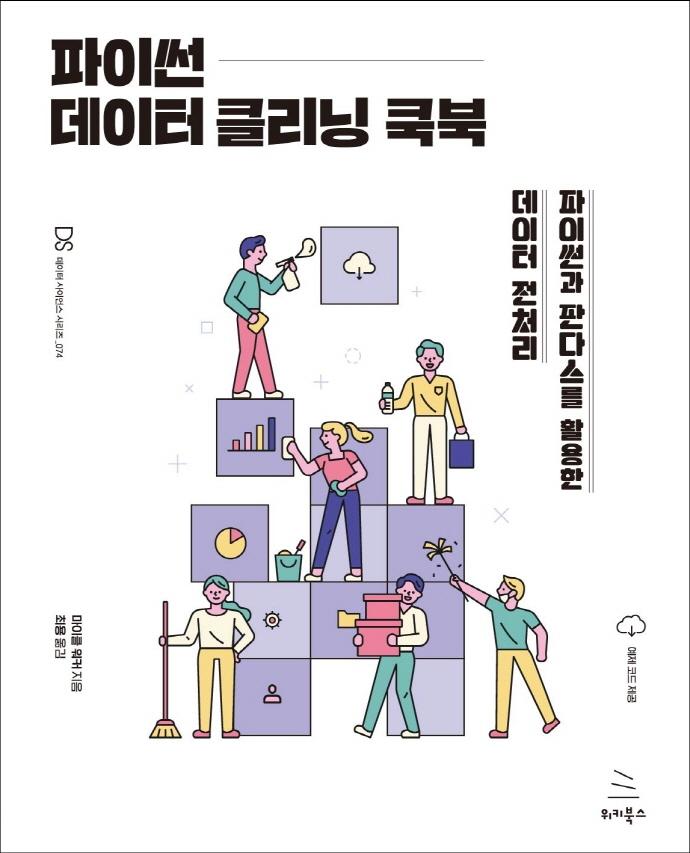





ISBN : 9791158392789 / 388쪽 / 737g / 188 x 240 (㎜)
이 상품에 궁금하신점이 있으세요? 1:1상담문의



아래의 도서와 구매하시면 이 도서들의 적립금을 즉시적용해 드립니다.
-

클리커, 강민혁
-
발리아파 락시마난, 하네스 하프케
-
이지영
-
- 23,400
- 37,800
- 27,000
- 20,700


출판사 리뷰
★ 이 책에서 다루는 내용 ★ ◎ 다양한 데이터 소스로부터 데이터를 읽고 분석하는 법 ◎ 데이터프레임, 열, 행의 어트리뷰트를 요약하는 법 ◎ 데이터를 필터링하고 주어진 요건을 충족하는 열을 선택 ◎ 날짜, 누락값이 있는 데이터 등 지저분한 데이터를 다루기 ◎ 메서드 체이닝으로 파이썬 판다스 작업 생산성을 향상 ◎ 시각화를 통해 통찰을 얻고 잠재적인 데이터 이슈를 식별 ◎ 데이터의 변동을 파악하는 능력을 향상 ◎ 사용자 정의 함수 및 클래스를 작성해 데이터 정제를 자동화

-
- 저자 : 마이클 워커

▣ 01장: 표 데이터를 판다스로 가져올 때의 데이터 정제
___1.1 CSV 파일 가져오기
___1.2 엑셀 파일 가져오기
___1.3 SQL 데이터베이스의 데이터를 가져오기
___1.4 SPSS, Stata, SAS 데이터 가져오기
___1.5 R 데이터 가져오기
___1.6 표 데이터 저장
▣ 02장: HTML과 JSON을 판다스로 가져올 때의 데이터 정제
___2.1 단순한 JSON 데이터 가져오기
___2.2 API를 통해 복잡한 JSON 데이터 가져오기
___2.3 웹페이지의 데이터 가져오기
___2.4 JSON 데이터 저장
▣ 03장: 데이터 측정
___3.1 처음 데이터를 훑어보기
___3.2 열을 선택하고 정돈하기
___3.3 행을 선택하기
___3.4 범주형변수의 빈도를 생성하기
___3.5 연속변수의 요약통계 생성하기
▣ 04장: 데이터의 부분집합에서 누락값과 이상값 식별
___4.1 누락값 찾기
___4.2 변수가 1개인 이상값 식별하기
___4.3 이변량 관계의 이상값과 예상치 못한 값 식별하기
___4.4 부분집합을 이용해 변수 간의 논리적 불일치를 찾기
___4.5 선형 회귀를 활용해 유의한 영향을
___4.6 k-최근접 이웃을 활용해 이상값을 찾기
___4.7 아이솔레이션 포레스트를 활용한 이상 탐지
▣ 05장: 시각화를 활용해 예상치 못한 값을 식별하기
___5.1 히스토그램을 활용해 연속변수의 분포를 조사하기
___5.2 박스플롯을 활용해 연속변수의 이상값을 식별하기
___5.3 그룹별 박스플롯으로 특정 그룹에서 예상치 못한 값을 드러내기
___5.4 바이올린 플롯으로 분포 형태와 이상값을 조사하기
___5.5 산점도를 활용해 이변량 관계를 보기
___5.6 라인 플롯으로 연속변수의 추세를 조사하기
___5.7 상관행렬을 기반으로 히트맵을 작성하기
▣ 06장: 데이터 정제, 탐색 및 시리즈 연산
___6.1 판다스 시리즈에서 값을 얻기
___6.2 판다스 시리즈에 대한 요약통계 표시
___6.3 시리즈 값 변경
___6.4 조건에 따라 시리즈 값을 변경
___6.5 문자열 시리즈 데이터 평가와 정제
___6.6 날짜 다루기
___6.7 누락 데이터 식별과 정제
___6.8 k-최근접 이웃으로 누락값 대치
▣ 07장: 집계 시 지저분한 데이터 다루기
___7.1 itertuples을 활용한 데이터 순회(안티 패턴)
___7.2 넘파이 배열의 그룹별 요약을 계산
___7.3 groupby를 사용해 데이터를 그룹별로 조직화하기
___7.4 좀 더 복잡한 집계 함수를 groupby와 함께 사용하기
___7.5 사용자 정의 함수 및 apply와 groupby
___7.6 groupby를 사용해 데이터프레임의 분석 단위를 바꾸기
▣ 08장: 데이터프레임들을 결합할 때의 데이터 문제 해결
___8.1 데이터프레임을 수직으로 결합하기
___8.2 일대일 병합
___8.3 병합 기준 열을 여러 개 사용하기
___8.4 일대다 병합
___8.5 다대다 병합
___8.6 병합 루틴 개발
▣ 09장: 데이터 타이딩과 리셰이핑
___9.1 중복 행 제거하기
___9.2 다대다 관계 수정하기
___9.3 stack과 melt로 넓은 데이터를 긴 포맷으로 리셰이핑
___9.4 열 그룹을 녹이기
___9.5 unstack과 pivot을
▣ 10장: 사용자 정의 함수와 클래스로 데이터 정제를 자동화
___10.1 데이터를 처음 살펴보는 함수
___10.2 요약통계와 빈도를 표시하는 함수
___10.3 이상치와 예상치 못한 값을 식별하는 함수
___10.4 데이터 집계와 결합을 위한 함수
___10.5 시리즈 값을 업데이트하는 로직을 담은 클래스
___10.6 표 형태가 아닌 데이터 구조를 다루는 클래스

