









출고예상일 안내
주문하신 상품이 한국에서 현지 배송을 위한 출고단계가 이루어질 것으로 예상되는 날짜입니다. 상품을 준비하는 과정에서 내부적인 사정으로 인해 출고예상일에 다소 오차가 생길 수 있습니다.
여러 상품(예약상품포함)을 함께 주문하신 경우 출고예상일이 가장 늦은 날짜에 맞춰 함께 배송됩니다.


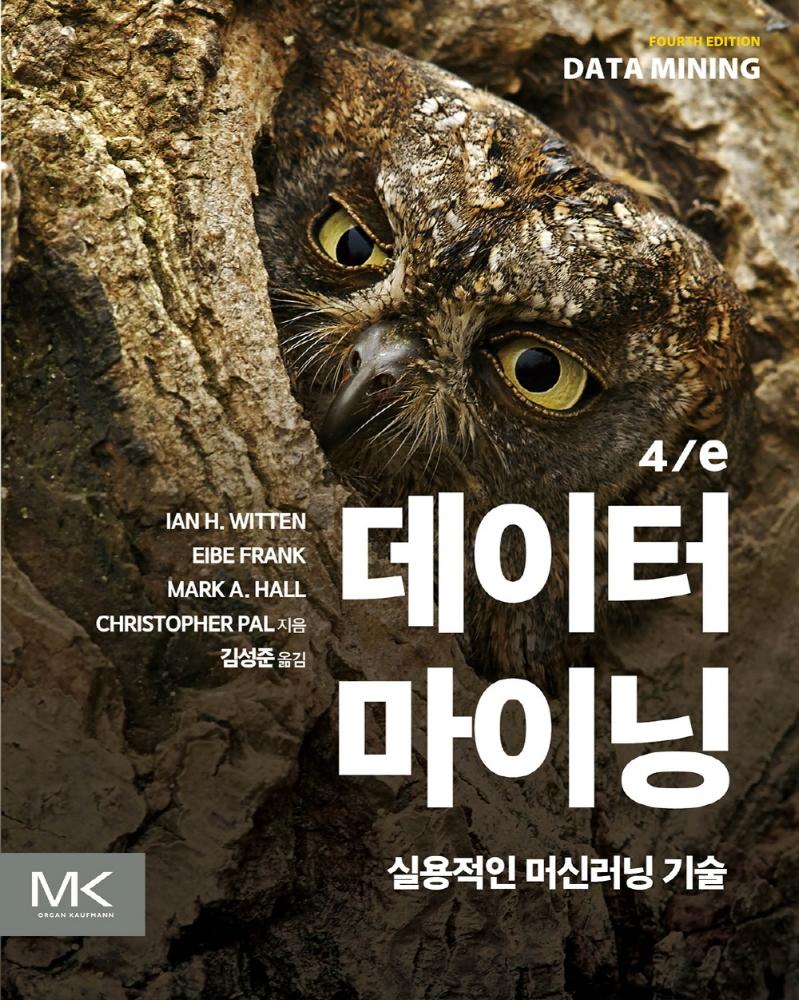





ISBN : 9791161756424 / 808쪽 / 1,535g / 188 x 235 (㎜)
이 상품에 궁금하신점이 있으세요? 1:1상담문의



아래의 도서와 구매하시면 이 도서들의 적립금을 즉시적용해 드립니다.
-
-
이지영
-
-
칼릭스(손윤석)
- 19,800
- 27,000
- 17,550
- 19,800


출판사 리뷰
○이안 위튼(지은이)의 말 컴퓨팅과 커뮤니케이션의 융합으로 사회는 많은 정보를 창출하기 시작했다. 그러나 대부분의 정보는 원시 형태인 데이터이며, 기록된 사실을 기반으로 데이터가 특정 지어지면 정보는 데이터의 기초가 되는 패턴 또는 예상의 집합이 된다. 데이터베이스에는 막대한 양의 정보가 들어 있다. 이 정보는 잠재적으로 중요하지만 아직 밝혀지지 않았거나 설명되지 않은 정보다. 우리의 임무는 그것을 밖으로 이끌어 내는 것이다. 데이터 마이닝(data mining)은 묵시적이면서 사전에 알려지지 않고 잠재적으로 유용할 정보를 데이터로부터 추출하는 작업이다. 이에 대한 아이디어는 자동으로 데이터베이스를 검색해 패턴이나 규칙성을 찾는 컴퓨터 프로그램을 구축하는 것이다. 강력한 패턴이 발견되면 이는 일반화를 거쳐 향후 데이터에 대한 정확한 예측에 사용된다. 물론 문제가 있을지도 모른다. 모든 패턴이 다 쓸모 있지는 않다. 어떤 것들은 사용된 특정 데이터셋에서 우연을 가장한 가짜일 것이다. 그리고 실제 데이터는 불완전하며 일부는 왜곡되고 일부는 누락된다. 발견된 모든 것은 정확하지 않으며 모든 규칙에 예외가 있고 어떤 규칙도 적용되지 않는 경우도 있다. 알고리듬은 불완전한 데이터에 대처하고 정확하지 않지만 유용한 규칙을 추출할 수 있을 만큼 강력해야 한다. 머신러닝은 데이터 마이닝의 기술적 기반을 제공한다. 데이터베이스의 원시 데이터에서 정보를 추출하는 데 사용되며, 다시 말하면 이상적으로는 이해할 수 있는 형식으로 표현되고 다양한 목적으로 사용될 수 있다. 이 과정은 추상화 중 하나이며 데이터 및 나쁜 점까지 모두 취하고 그 기반이 되는 구조를 추론한다. 이 책은 데이터의 구조적 패턴을 찾고 가능한 경우 이를 정리하고자 실제 데이터 마이닝에 사용되는 머신러닝의 도구와 기술에 관한 것이다. 상업적 관심을 받고 있는 급성장하는 신기술이 그렇듯이 머신러닝의 사용은 기술적 (때로는 인기있는) 언론에서 엄청난 과대 광고로 둘러싸여 있다. 데이터의 바다에서 학습 알고리듬을 느슨하게 설정해 밝혀 낼 수 있는 비밀에 대한 과장된 보고서를 쉽게 찾을 수 있다. 그러나 머신러닝에는 마법, 숨겨진 힘, 연금술 따위는 없다. 대신 원시 데이터에서 유용한 정보를 추출할 수 있는 간단하고 실용적인 기술의 식별 가능한 무엇이 있을 뿐이다. 이 책은 그 간단하고 실용적인 기술을 설명하고 작동 방식을 보여 준다. 많은 애플리케이션에서 머신러닝으로 예제로부터 구조적 정보를 얻을 수 있다. 발견된 정보는 예측, 정보, 이해에 사용된다. 일부 데이터 마이닝 애플리케이션은 예측에 중점을 두며, 과거에 일어난 일의 정보를 제공하는 데이터에서 새로운 상황에서 일어날 일을 예측하고, 종종 새로운 사례의 분류를 추측한다. 그러나 우리는 '학습'의 결과가 예제를 분류하는 데 사용할 수 있는 구조의 실제 정보가 되는 애플리케이션에도 동일하게(어쩌면 더 많이) 관심이 있다. 이 구조적 정보는 예측뿐 아니라 해당 정보를 쉽게 이해하도록 만든다. 대부분 경험상 사용자가 얻은 인사이트는 실제 데이터 마이닝 애플리케이션에서 중요하며 실제로 이는 고전적인 통계 모델링을 넘어선 머신러닝의 주요 장점 중 하나다. 이 책은 다양한 머신러닝 방법을 설명한다. 기본 아이디어가 어떻게 동작하는지를 간단한 구조로 설명했기 때문에 교육적으로도 동기 부여가 될 것이다. ○역자후기 데이터 마이닝이라는 용어는 2000년도 초반에 잠깐 유행했었다. 당시에는 그냥 데이터를 어떻게 잘 모을까에 집중했었는데(지금 생각해 보면 이 개념이 데이터 레이크 등으로 이어진 것 같다) 분석 등에 대해서는 마땅한 도구가 없었던 것 같다. 사실 분석 방법은 옛날부터 나이브 베이즈와 같이 고전적인 방법들이 많이 있었는데 수많은 데이터에 적용시킬 방법이 없었던 것 같다. 그래서 2000년도 초반에 잠깐 데이터 마이닝이라는 분야가 나왔다가 다시 가라앉았던 기억이 있다. R이나 파이썬과 같은 언어들이 나오면서 다양한 수학적 연산이 쉽게 가능해졌다. 이에 따라 다시 예전에는 적용에 엄두도 못 냈던 과거의 방법들이 라이브러리로 구현되면서 데이터 마이닝 분야도 다시 활기를 띠기 시작했다. 파이썬도 이제 다양한 라이브러리를 제공한다. 하지만 이 라이브러리들을 언제 써야 하는지 그리고 데이터에 유실 등의 문제가 발생하면 어떻게 대처해야 하는지를 모르는 경우가 많다. 이 책은 데이터 분석의 '기본'을 토대로 방향을 제시해 주는 책이다. 데이터 분석, 신경망 등에 대한 기본을 알려 주는 책들은 연일 쏟아지지만 문제가 발생할 때의 해결, 좀 더 나은 성능 개선 등을 알려 주는 책은 별로 없기 때문에 이 책이 더 빛이 나는 게 아닐까 싶다.

-
- 저자 : 이안 위튼

1부. 데이터 마이닝의 소개
1장. 데이터 마이닝… 이게 다 뭐죠?
2장. 입력 - 콘셉트, 인스턴스, 속성
3장. 출력 - 지식의 표현
4장. 알고리듬 - 기본 방식
5장. 신뢰성 - 학습에 대한 평가
2부. 고급 머신러닝 기술
6장. 트리와 규칙
7장. 인스턴스 기반 및 선형 모델의 확장
8장. 데이터 변환
9장. 확률적 방법
10장. 딥러닝
11장. 지도 및 비지도 학습을 넘어서
12장. 앙상블 학습
13장. 응용 영역, 그 너머의 세계
부록 A. 이론적 기초
부록 B. WEKA 워크벤치

