









출고예상일 안내
주문하신 상품이 한국에서 현지 배송을 위한 출고단계가 이루어질 것으로 예상되는 날짜입니다. 상품을 준비하는 과정에서 내부적인 사정으로 인해 출고예상일에 다소 오차가 생길 수 있습니다.
여러 상품(예약상품포함)을 함께 주문하신 경우 출고예상일이 가장 늦은 날짜에 맞춰 함께 배송됩니다.


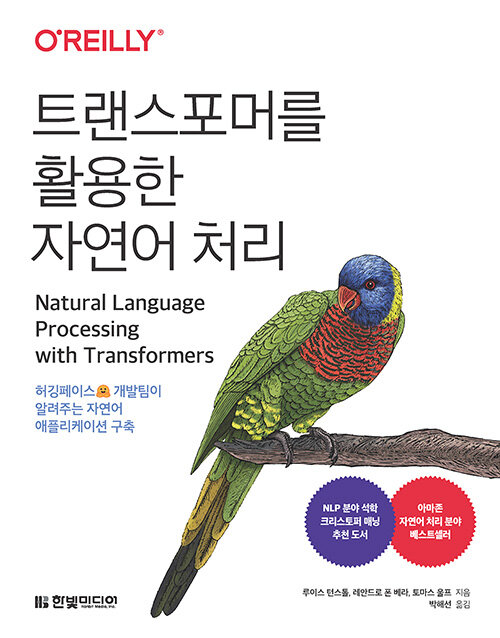
트랜스포머를 활용한 자연어 처리 허깅페이스 개발팀이 알려주는 자연어 애플리케이션 구축
루이스 턴스톨 , 레안드로 폰 베라 , 토마스 울프 저 | 박해선 역 | 한빛미디어 | 2022년 11월






ISBN : 9791169210508 / 484쪽 183 x 235 (㎜)
이 상품에 궁금하신점이 있으세요? 1:1상담문의



아래의 도서와 구매하시면 이 도서들의 적립금을 즉시적용해 드립니다.
-
엥지유니버스
-
-

클리커, 강민혁
-

코리아교육그룹 교육연구소
- 27,000
- 26,100
- 23,400
- 19,800



출판사 리뷰
자연어 처리 애플리케이션을 만드는 큐브, 트랜스포머
이 책은 머신러닝 지식을 갖춘 엔지니어와 연구자를 대상으로 직접 모델을 구현하며 트랜스포머를 업무에 적용하는 실용적인 방법을 전달한다. 트랜스포머를 이용하는 데 필요한 기본적인 이론과 방법을 소개한 뒤, 다국어 텍스트의 개체명 인식(NER)을 비롯해 텍스트 생성, 텍스트 요약, 질문 답변(QA) 같은 목적에 맞는 다양한 자연어 처리 모델을 훈련해본다. 다양한 트랜스포머 모델에 표준화된 인터페이스를 제공하는 라이브러리인 허깅페이스 트랜스포머스를 개발한 팀의 안내를 따라 내게 필요한 모델을 구축해보자.
대상 독자
ㆍ트랜스포머를 입맛에 맞게 조정하고 싶은 데이터 과학자와 머신러닝 엔지니어
ㆍ자기만의 자연어 처리 애플리케이션을 만들고 싶은 개발자
주요 내용
ㆍ텍스트 분류, 개체명 인식 등 NLP 작업을 위한 트랜스포머 모델을 빌드 및 디버깅, 최적화하는 방법
ㆍ언어 간 전이 학습에 트랜스포머를 사용하는 방법
ㆍ레이블링된 데이터가 부족한 상황에서 트랜스포머를 적용해 모델 성능을 높이는 방법
ㆍ지식 정제와 양자화, 가지치기 같은 기술을 사용한 트랜스포머 모델 효율화 방법
ㆍ대규모 트랜스포머 모델을 밑바닥부터 훈련하고 여러 GPU 및 분산 환경으로 확장하는 방법


-
- 저자 : 루이스 턴스톨 , 레안드로 폰 베라 , 토마스 울프

CHAPTER 1 트랜스포머 소개
_1.1 인코더-디코더 프레임워크
_1.2 어텐션 메커니즘
_1.3 NLP의 전이 학습
_1.4 허깅페이스 트랜스포머스
_1.5 트랜스포머 애플리케이션 둘러보기
__1.5.1 텍스트 분류
__1.5.2 개체명 인식
__1.5.3 질문 답변
__1.5.4 요약
__1.5.5 번역
__1.5.6 텍스트 생성
_1.6 허깅페이스 생태계
__1.6.1 허깅페이스 허브
__1.6.2 허깅페이스 토크나이저
__1.6.3 허깅페이스 데이터셋
__1.6.4 허깅페이스 액셀러레이트
_1.7 트랜스포머의 주요 도전 과제
_1.8 결론
CHAPTER 2 텍스트 분류
_2.1 데이터셋
__2.1.1 허깅페이스 데이터셋 처음 사용하기
__2.1.2 데이터셋에서 데이터프레임으로
__2.1.3 클래스 분포 살펴보기
__2.1.4 트윗 길이 확인
_2.2 텍스트에서 토큰으로
__2.2.1 문자 토큰화
__2.2.2 단어 토큰화
__2.2.3 부분단어 토큰화
__2.2.4 전체 데이터셋 토큰화하기
_2.3 텍스트 분류 모델 훈련하기
__2.3.1 트랜스포머를 특성 추출기로 사용하기
__2.3.2 트랜스포머 미세 튜닝하기
_2.4 결론
CHAPTER 3 트랜스포머 파헤치기
_3.1 트랜스포머 아키텍처
_3.2 인코더
__3.2.1 셀프 어텐션
__3.2.2 피드 포워드 층
__3.2.3 층 정규화 추가하기
__3.2.4 위치 임베딩
__3.2.5 분류 헤드 추가하기
_3.3 디코더
_3.4 트랜스포머 유니버스
__3.4.1 트랜스포머 가계도
__3.4.2 인코더 유형
__3.4.3 디코더 유형
__3.4.4 인코더-디코더 유형
_3.5 결론
CHAPTER 4 다중 언어 개체명 인식
_4.1 데이터셋
_4.2 다중 언어 트랜스포머
_4.3 XLM-R 토큰화
__4.3.1 토큰화 파이프라인
__4.3.2 SentencePiece 토크나이저
_4.4 개체명 인식을 위한 트랜스포머
_4.5 트랜스포머 모델 클래스
__4.5.1 바디와 헤드
__4.5.2 토큰 분류를 위한 사용자 정의 모델 만들기
__4.5.3 사용자 정의 모델 로드하기
_4.6 NER 작업을 위해 텍스트 토큰화하기
_4.7 성능 측정
_4.8 XLM-RoBERTa 미세 튜닝하기
_4.9 오류 분석
_4.10 교차 언어 전이
__4.10.1 제로 샷 전이가 유용할 때
__4.10.2 다국어에서 동시에 미세 튜닝하기
_4.11 모델 위젯 사용하기
_4.12 결론
CHAPTER 5 텍스트 생성
_5.1 일관성 있는 텍스트 생성의 어려움
_5.2 그리디 서치 디코딩
_5.3 빔 서치 디코딩
_5.4 샘플링 방법
_5.5 탑-k 및 뉴클리어스 샘플링
_5.6 어떤 디코딩 방법이 최선일까요?
_5.7 결론
CHAPTER 6 요약
_6.1 CNN/DailyMail 데이터셋
_6.2 텍스트 요약 파이프라인
__6.2.1 요약 기준 모델
__6.2.2 GPT-2
__6.2.3 T5
__6.2.4 BART
__6.2.5 PEGASUS
_6.3 요약 결과 비교하기
_6.4 생성된 텍스트 품질 평가하기
__6.4.1 BLEU
__6.4.2 ROUGE
_6.5 CNN/DailyMail 데이터셋에서 PEGASUS 평가하기
_6.6 요약 모델 훈련하기
__6.6.1 SAMSum에서 PEGASUS 평가하기
__6.6.2 PEGASUS 미세 튜닝하기
__6.6.3 대화 요약 생성하기
_6.7 결론
CHAPTER 7 질문 답변
_7.1 리뷰 기반 QA 시스템 구축하기
__7.1.1 데이터셋
__7.1.2 텍스트에서 답 추출하기
__7.1.3 헤이스택을 사용해 QA 파이프라인 구축하기
_7.2 QA 파이프라인 개선하기
__7.2.1 리트리버 평가하기
__7.2.2 리더 평가하기
__7.2.3 도메인 적응
__7.2.4 전체 QA 파이프라인 평가하기
_7.3 추출적 QA를 넘어서
_7.4 결론
CHAPTER 8 효율적인 트랜스포머 구축
_8.1 의도 탐지 예제
_8.2 벤치마크 클래스 만들기
_8.3 지식 정제로 모델 크기 줄이기
__8.3.1 미세 튜닝에서의 지식 정제
__8.3.2 사전 훈련에서의 지식 정제
__8.3.3 지식 정제 트레이너 만들기
__8.3.4 좋은 스튜던트 선택하기
__8.3.5 옵투나로 좋은 하이퍼파라미터 찾기
__8.3.6 정제 모델 벤치마크 수행하기
_8.4 양자화로 모델 속도 높이기
_8.5 양자화된 모델의 벤치마크 수행하기
_8.6 ONNX와 ONNX 런타임으로 추론 최적화하기
_8.7 가중치 가지치기로 희소한 모델 만들기
__8.7.1 심층 신경망의 희소성
__8.7.2 가중치 가지치기 방법
_8.8 결론
CHAPTER 9 레이블 부족 문제 다루기
_9.1 깃허브 이슈 태거 만들기
__9.1.1 데이터 다운로드하기
__9.1.2 데이터 준비하기
__9.1.3 훈련 세트 만들기
__9.1.4 훈련 슬라이스 만들기
_9.2 나이브 베이즈 모델 만들기
_9.3 레이블링된 데이터가 없는 경우
_9.4 레이블링된 데이터가 적은 경우
__9.4.1 데이터 증식
__9.4.2 임베딩을 룩업 테이블로 사용하기
__9.4.3 기본 트랜스포머 미세 튜닝하기
__9.4.4 프롬프트를 사용한 인-컨텍스트 학습과 퓨-샷 학습
_9.5 레이블링되지 않은 데이터 활용하기
__9.5.1 언어 모델 미세 튜닝하기
__9.5.2 분류기 미세 튜닝하기
__9.5.3 고급 방법
_9.6 결론
CHAPTER 10 대규모 데이터셋 수집하기
_10.1 대규모 데이터셋 수집하기
__10.1.1 대규모 말뭉치 구축의 어려움
__10.1.2 사용자 정의 코드 데이터셋 만들기
__10.1.3 대용량 데이터셋 다루기
__10.1.4 허깅페이스 허브에 데이터셋 추가하기
_10.2 토크나이저 구축하기
__10.2.1 토크나이저 모델
__10.2.2 토크나이저 성능 측정하기
__10.2.3 파이썬 코드를 위한 토크나이저
__10.2.4 토크나이저 훈련하기
__10.2.5 허브에 사용자 정의 토크나이저 저장하기
_10.3 밑바닥부터 모델을 훈련하기
__10.3.1 사전 훈련 목표
__10.3.2 모델 초기화
__10.3.3 데이터로더 구축하기
__10.3.4 훈련 루프 정의하기
__10.3.5 훈련 실행
_10.4 결과 및 분석
_10.5 결론
CHAPTER 11 향후 방향
_11.1 트랜스포머 확장
__11.1.1 규모의 법칙
__11.1.2 규모 확장의 어려움
__11.1.3 어텐션 플리즈!
__11.1.4 희소 어텐션
__11.1.5 선형 어텐션
_11.2 텍스트를 넘어서
__11.2.1 비전
__11.2.2 테이블
_11.3 멀티모달 트랜스포머
__11.3.1 스피치-투-텍스트
__11.3.2 비전과 텍스트
_11.4 다음 목적지는?

