









출고예상일 안내
주문하신 상품이 한국에서 현지 배송을 위한 출고단계가 이루어질 것으로 예상되는 날짜입니다. 상품을 준비하는 과정에서 내부적인 사정으로 인해 출고예상일에 다소 오차가 생길 수 있습니다.
여러 상품(예약상품포함)을 함께 주문하신 경우 출고예상일이 가장 늦은 날짜에 맞춰 함께 배송됩니다.


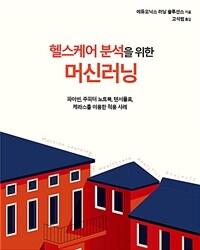





ISBN : 9791161756233 / 216쪽 188 x 235 (㎜)
이 상품에 궁금하신점이 있으세요? 1:1상담문의



아래의 도서와 구매하시면 이 도서들의 적립금을 즉시적용해 드립니다.
-

코리아교육그룹 교육연구소
-
-
정그린
-

클리커, 이희영, 강민혁
- 19,800
- 36,000
- 23,400
- 22,500


출판사 리뷰
◈ 이 책의 대상 독자 ◈ 머신러닝 알고리듬을 적용해 스마트 인공지능 애플리케이션을 만들어보려는 데이터 과학자, 머신러닝 기술자, 헬스케어 전문가를 위한 책이다. 파이썬이나 다른 프로그래밍 언어의 기초 지식을 갖춘 독자를 대상으로 한다. ◈ 이 책의 구성 ◈ 1장, '유방암 진단'에서는 유방암 진단 프로젝트를 다룬다. 데이터를 전처리하고 데이터에 대한 이해를 높이기 위한 탐색 과정을 설명한다. 또한 히스토그램과 산점도를 만들어보면서 분포와 변수들 간의 선형 관계도 살펴본다. 테스트 매개변수를 구현하고 KNN 분류자와 SVC 모델을 만들고, 분류 보고서를 사용해 결과들을 비교해볼 것이다. 2장, '당뇨병 발병 예측'에서는 케라스(Keras)로 딥 신경망을 구성해볼 것이다. 사이킷런(Scikit-learn)의 그리드 탐색(Grid search)을 사용해 최적 초매개변수(hyperparameter)를 탐색하고 초매개변수를 조절해 모델을 최적화하는 방법도 배운다. 3장, 'DNA 분류하기'에서는 대장균 염기서열이 프로모터(promotor)인지 여부를 분류해주는 머신러닝 모델을 만들어볼 것이다. 분류 알고리듬으로 모델을 만들고 학습시킨 후 분류 보고서를 사용해 모델들의 성능을 서로 비교해본다. 4장, '관상 동맥 질환 진단'에서는 사이킷런과 케라스를 사용한다. 판다스(Pandas)의 read_csv() 함수를 사용해 UCI 데이터 저장소에서 데이터를 임포트하고, 이것을 프로세싱한다. 데이터를 정리해 기술하는 방법을 배우고 우리가 다루는 것이 무엇인지 알아내기 위해 히스토그램을 출력해볼 것이다. 5장, '머신러닝을 이용한 자폐증 스크리닝'에서는 약 90%의 정확도로 자폐증을 예측하는 머신러닝을 만들어볼 것이다. 카테고리형 데이터를 처리하는 방법인 원-핫 인코딩을 설명한다. 드롭아웃 정규화로 과적합을 줄이는 방법도 소개한다. 부록에서는 역자가 추가로 작성한 내용으로, 파이썬 데이터 과학 가이드를 제공한다. 파이썬 언어 환경을 구성하는 방법과 데이터 과학에 필수적인 주피터 노트북을 중심으로 다룬다.

-
- 저자 : 에듀오닉스 러닝 솔루션스

01장. 유방암 세포 진단
__SVM, KNN 모델을 사용한 유방암 진단
__데이터 전처리와 데이터 탐색
__데이터셋 분리
__모델 학습
____머신러닝을 사용한 예측
__요약
02장. 당뇨병 발병 예측
__딥러닝과 그리드 탐색을 사용한 당뇨병 진단
__데이터셋 소개
____데이터 전처리
____데이터 정규화
__케라스 모델 정의
__사이킷런을 사용한 그리드 탐색법 수행
__드롭아웃 정규화를 사용해 과적합 줄이기
__최적 초매개변수 찾기
__뉴런의 개수 최적화
__최적의 초매개변수를 사용해 예측하기
____보너스
__요약
03장. DNA 분류하기
__DNA 염기서열 분류
____데이터 전처리
____DNA 염기서열 생성
____머신러닝을 이용한 염기 서열 분류
__요약
04장. 관상 동맥 질환 진단
__데이터셋
__결측값 처리
__데이터셋 분리
__신경망 훈련
__다중 분류와 이진 분류의 비교
__요약
05장. 머신러닝을 이용한 자폐증 스크리닝
__머신러닝을 이용한 ADS 스크리닝
__데이터셋 소개
____필요한 라이브러와 데이터 임포트
____데이터셋 탐색
____데이터 전처리
__데이터셋을 훈련 데이터와 테스트 데이터로 나누기
__신경망 구현
__신경망 테스트
____드롭아웃 정규화를 사용해 과적합 해결하기
__요약
부록 A. 파이썬 데이터 과학을 시작하는 보건 의료인을 위한 안내서
__컴퓨터에 파이썬 설치
____파이썬 버전에 대해
____아나콘다 파이썬 배포판 설치
__파이썬 가상 환경 만들기
____콘다 가상 환경 만들기
____파이썬 패키지는 가상 환경에 설치
____파이썬 패키지를 설치
__데이터 과학을 위한 최고의 실행 환경: 주피터 노트북
____가상 환경에 jupyter 패키지 설치와 실행
____주피터 노트북 실행시키기
____주피터 노트북 파일
____프로젝트 폴더에서 주피터 노트북 실행하기
____주피터 노트북의 발전된 형태: 주피터랩
__플레인 파이썬 인터프리터, 파이썬 스크립트 실행, ipython 인터프리터
____ipython 인터프리터 좀 더 들여다보기
__주피터 노트북 커널(Kernel)에 대해
__구글 콜래보터리
__주피터 노트북의 활용
__요약
부록 B. 주피터 노트북, 주피터랩, VS Code
__주피터 노트북 설치와 실행
__주피터 노트북 셀에 내용을 입력하는 방법
____셀의 종류
____파이썬 코드의 입력과 실행
____셀 모드와 단축키 사용
__ipython 커널에서 유래한 기능
____리치 아웃풋: ipython 디스플레이 시스템
__노트북 대시보드, 주피터 노트북 파일 관리
__주피터 노트북 파일과 활용
__주피터 노트북의 기능 확장(nbextensions)
__R 커널 추가하기
____주피터 노트북에 R 언어에 대한 커널을 추가하기
__주피터랩
____주피터랩의 설치와 실행
____노트북 작업
____다양한 콘텐츠 뷰어
____사용자 커스터마이징
__광대한 주피터 에코시스템
__Visual Studio Code 텍스트 편집기와 주피터 노트북
____Visual Studo Code 설치와 간단한 사용
____VS Code에서 파이썬 사용하기
__컴퓨테이셔널 노트북

