









출고예상일 안내
주문하신 상품이 한국에서 현지 배송을 위한 출고단계가 이루어질 것으로 예상되는 날짜입니다. 상품을 준비하는 과정에서 내부적인 사정으로 인해 출고예상일에 다소 오차가 생길 수 있습니다.
여러 상품(예약상품포함)을 함께 주문하신 경우 출고예상일이 가장 늦은 날짜에 맞춰 함께 배송됩니다.


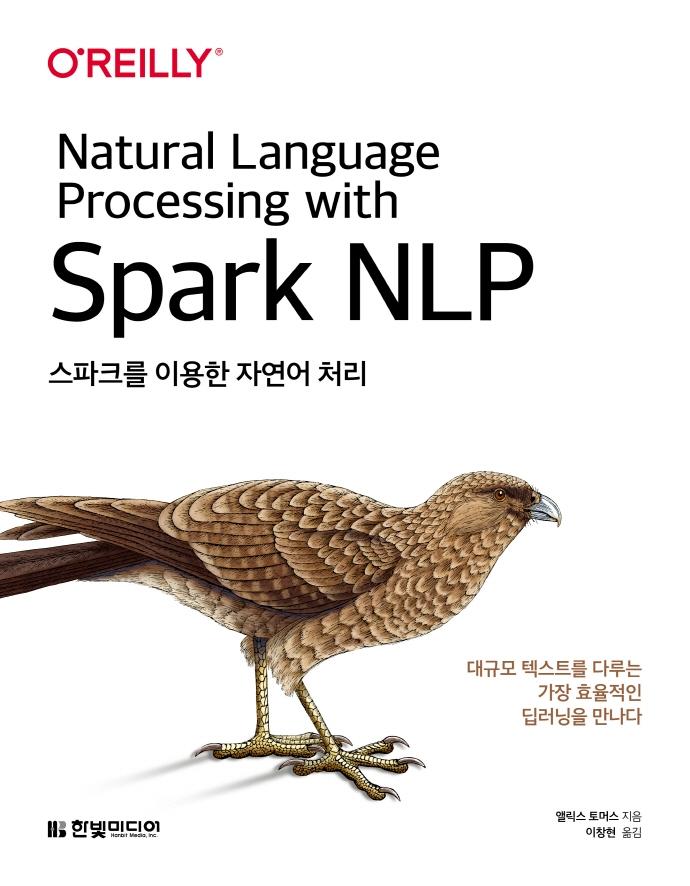





ISBN : 9791162244654 / 440쪽 183 x 235 (㎜)
이 상품에 궁금하신점이 있으세요? 1:1상담문의



아래의 도서와 구매하시면 이 도서들의 적립금을 즉시적용해 드립니다.
-
엥지유니버스
-
칼릭스(손윤석)
-

서길원, 김운호, 허상훈, 박재상, 박경규, 김종욱, 오윤우, 유지영
-

거트루드(박태현)
- 27,000
- 19,800
- 31,500
- 23,400


출판사 리뷰
언어학자, 데이터 과학자, 소프트웨어 개발자의 눈으로 구현하는 자연어 처리 애플리케이션
자연어 처리는 사람과 기계를 소통할 수 있게 만드는 기술입니다. 최근에는 의료 산업, 기계번역, 작문, 챗봇과 같이 데이터를 분석해 서비스를 제공하는 애플리케이션의 개발과 기술 도입이 활발하게 확대되고 있습니다. 자연어 처리 기술을 쉽게 구현하도록 돕는 라이브러리 중 하나인 Spark NLP는 아파치 스파크 기반으로 정확성과 확장 가능성, 빠른 속도를 자랑합니다.
그러나 애플리케이션을 만들기 전에 유념해야 할 부분은 우리가 다룰 데이터(텍스트, 이미지, 영상, 음성)가 컴퓨터를 염두에 두고 만들어지지 않았다는 점입니다. 이 책에서는 이런 데이터를 잘 분석하고 처리하기 위해서 언어학, 데이터 과학, 소프트웨어 공학 측면에서 이를 살펴봐야 한다는 새로운 관점을 제시합니다. 애플리케이션을 구현하기 전, 언어학자가 되어 추출하려는 데이터의 내용에 초점을 맞춰 살펴보고, 데이터 과학자가 되어 데이터에서 필요한 정보를 추출하는 방법을 고민하고, 소프트웨어 개발자가 되어 애플리케이션이 수행해야 할 작업에 초점을 맞춰 접근하는 방법을 알아봅니다.
세 가지 관점으로 구현하려는 애플리케이션과 데이터를 바라보면 NLP 애플리케이션을 효율적으로 개발할 수 있고, 사용자에게 더 유용한 애플리케이션을 제공할 수 있습니다. 이 책에서 Spark NLP 사용법과 NLP 애플리케이션을 현명하게 구현하는 방법을 배워 자연어 처리 전문가가 되어봅시다.
주요 내용
●\t자연어 처리와 Spark NLP, 딥러닝 기초를 설명합니다.
●\t토큰화, 문장 분할, 개체명 인식 방법을 살펴보고 각각의 작동 방식을 이해합니다.
●\t자신만의 NLP 애플리케이션 구축에 필요한 설계, 개발, 실험 과정을 차례대로 살펴봅니다.
●\tNLP 애플리케이션 제작과 배포 시 고려해야 할 중요한 항목을 알아봅니다.
6. 추천사
딥러닝 기초부터 전이 학습을 적용한 언어 모델까지 실제 산업용 AI 애플리케이션을 구축하는 과정을 완벽하게 풀어냈습니다.
_데이비드 탈비, John Snow Labs CTO

-
- 저자 : 앨릭스 토머스

[PART I 기초]
CHAPTER 1 시작하기
1.1 Spark NLP와 자연어 처리
1.2 기타 도구
1.3 환경 설정
1.4 아파치 스파크에 익숙해지기
1.5 Spark NLP를 사용한 Hello World
CHAPTER 2 자연어 처리 기초
2.1 자연어 처리 정의
2.2 언어학
2.3 사회언어학
2.4 화용론
2.5 문자
2.6 인코딩
2.7 연습 문제: 토큰화
2.8 참고 자료
CHAPTER 3 아파치 스파크의 NLP 라이브러리
3.1 병렬처리, 동시성과 분산 컴퓨팅
3.2 아파치 스파크의 아키텍처
3.3 스파크 SQL과 Spark MLlib
3.4 NLP 라이브러리
3.5 Spark NLP
3.6 연습 문제: 토픽 모델 구축
3.7 참고 자료
CHAPTER 4 딥러닝 기초
4.1 경사 하강법
4.2 역전파
4.3 합성곱 신경망
4.4 순환 신경망
4.5 연습 문제 1
4.6 연습 문제 2
4.7 참고 자료
[PART II 빌딩 블록]
CHAPTER 5 단어 처리
5.1 토큰화
5.2 어휘 감소
5.3 단어 가방
5.4 CountVectorizer
5.5 n-gram
5.6 시각화: 단어 및 문서 분산
5.7 연습 문제
5.8 참고 자료
CHAPTER 6 정보 검색
6.1 역 인덱스
6.2 벡터 공간 모델
6.3 연습 문제
6.4 참고 자료
CHAPTER 7 분류와 회귀
7.1 BoW 기능
7.2 정규식 특성
7.3 특성 선택
7.4 모델링
7.5 반복
7.6 연습 문제
CHAPTER 8 케라스를 사용한 시퀀스 모델링
8.1 문장 분할
8.2 섹션 분할
8.3 품사 태깅
8.4 조건부 무작위장
8.5 청킹 및 구문 분석
8.6 언어 모델
8.7 순환 신경망
8.8 연습 문제: 문자 n-gram
8.9 연습 문제: 단어 언어 모델
8.10 참고 자료
CHAPTER 9 정보 추출
9.1 개체명 인식
9.2 상호 참조 해결
9.3 어서션 상태 감지
9.4 관계 추출
9.5 마치며
9.6 연습 문제
CHAPTER 10 주제 모델링
10.1 k-평균
10.2 잠재 의미 분석
10.3 음수 미포함 행렬 분해
10.4 잠재 디리클레 할당
10.5 연습 문제
CHAPTER 11 단어 임베딩
11.1 Word2Vec
11.2 글로브
11.3 패스트텍스트
11.4 변환자
11.5 ELMo, BERT와 XLNet
11.6 doc2vec
11.7 연습 문제
[PART III 애플리케이션]
CHAPTER 12 감성 분석과 감지
12.1 문제 진술과 제약
12.2 프로젝트 계획
12.3 솔루션 설계
12.4 솔루션 구현
12.5 솔루션 테스트와 측정
12.6 검토
12.7 마치며
CHAPTER 13 지식 베이스 구축
13.1 문제 진술과 제약
13.2 프로젝트 계획
13.3 솔루션 설계
13.4 솔루션 구현
13.5 솔루션 테스트와 측정
13.6 검토
13.7 마치며
CHAPTER 14 검색엔진
14.1 문제 진술과 제약 조건
14.2 프로젝트 계획
14.3 솔루션 설계
14.4 솔루션 구현
14.5 솔루션 테스트 및 측정
14.6 검토
14.7 마치며
CHAPTER 15 챗봇
15.1 문제 진술 및 제약
15.2 프로젝트 계획
15.3 솔루션 설계
15.4 솔루션 구현
15.5 솔루션 테스트 및 측정
15.6 검토
15.7 마치며
CHAPTER 16 객체 문자 인식
16.1 OCR 작업의 종류
16.2 문제 진술 및 제약
16.3 프로젝트 계획
16.4 솔루션 구현
16.5 솔루션 테스트 및 측정
16.6 모델 중심 지표
16.7 검토
16.8 마치며
[PART IV NLP 시스템 구축]
CHAPTER 17 다국어 지원
17.1 언어 유형
17.2 시나리오: 학술 논문 분류
17.3 다양한 언어의 텍스트 처리
17.4 전이 학습과 다국어 딥러닝
17.5 언어 간 검색
17.6 체크리스트
17.7 마치며
CHAPTER 18 수동 레이블링
18.1 가이드라인
18.2 시나리오: 학술 논문 분류
18.3 레이블러 간 동의
18.4 반복 레이블링
18.5 텍스트 레이블링
18.6 체크리스트
18.7 마치며
CHAPTER 19 NLP 애플리케이션 제작
19.1 Spark NLP 모델 캐시
19.2 Spark NLP와 텐서플로 통합
19.3 체크리스트
19.4 마치며

