









출고예상일 안내
주문하신 상품이 한국에서 현지 배송을 위한 출고단계가 이루어질 것으로 예상되는 날짜입니다. 상품을 준비하는 과정에서 내부적인 사정으로 인해 출고예상일에 다소 오차가 생길 수 있습니다.
여러 상품(예약상품포함)을 함께 주문하신 경우 출고예상일이 가장 늦은 날짜에 맞춰 함께 배송됩니다.


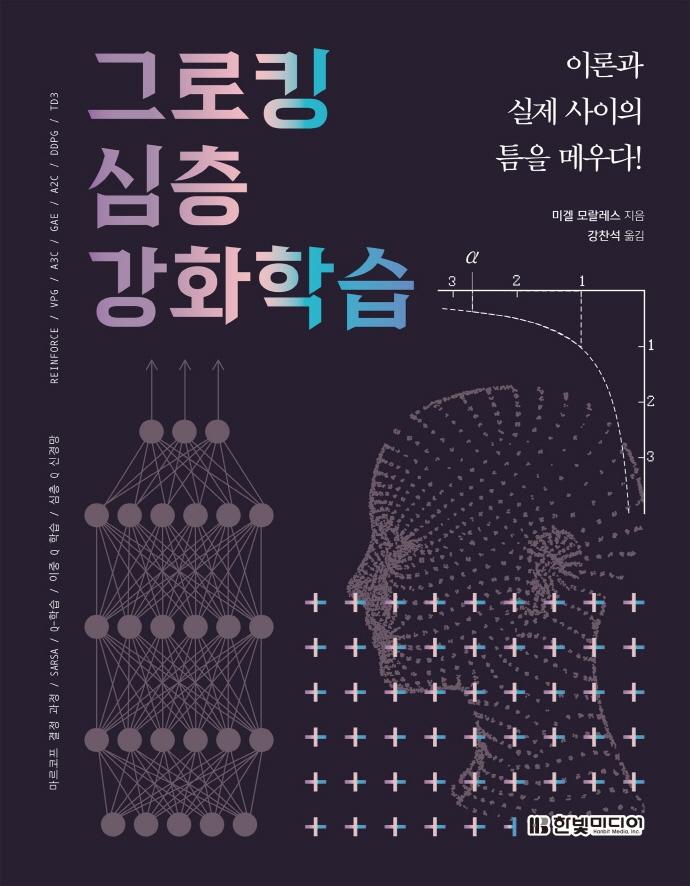





ISBN : 9791162244838 / 500쪽 183 x 235 (㎜)
이 상품에 궁금하신점이 있으세요? 1:1상담문의



아래의 도서와 구매하시면 이 도서들의 적립금을 즉시적용해 드립니다.
-

클리커, 강민혁
-
장세림
-
빨간고래(박정아)
-

서길원, 김운호, 허상훈, 박재상, 박경규, 김종욱, 오윤우, 유지영
- 23,400
- 21,600
- 24,300
- 31,500


출판사 리뷰
수학 공식부터 코드 예제까지
모든 걸 갖춘 심층 강화학습 풀 코스
이 책은 강화학습과 심층 강화학습이 무엇인지 이해하고 실제로 적용해보고 싶은 사람들을 위해 기본 이론부터 실제 적용 방법까지 차례로 안내합니다. 자세한 예제와 적절한 비유가 섞인 개념 설명으로 시작해, 해당 개념을 수학적으로 확인할 수 있는 공식들과 이를 직접 만들어볼 수 있는 코드까지 제공하며 강화학습을 떠먹여줍니다. 눈과 손을 통해 들어오는 설명을 하나씩 차례대로 소화해나가다 보면 어렵게만 느껴졌던 심층 강화학습이 어느새 여러분의 것이 되어 있을 겁니다.
대상 독자
인공지능이란 연구 영역에 익숙하고 파이썬 코드를 볼 줄 알아야 합니다. 여기저기 있는 수학과 수많은 직관적인 설명을 이해하며 재미있고 자세한 예제를 바탕으로 학습하고자 하는 사람이라면 이 책을 재미있게 볼 수 있습니다. 인공지능에 대해 모르더라도, 파이썬 코드를 읽을 줄 알고 학습에 대한 흥미만 있다면 많은 내용을 얻어갈 수 있습니다. 기본적인 딥러닝 지식이 요구되긴 하지만, 이 책은 신경망과 역전파 방식 및 관련 기법을 간단하게 복습합니다. 결론적으로 이 책 한 권에서 원하는 지식을 모두 얻어갈 수 있으며 인공지능 에이전트를 가지고 놀고 싶은 사람이나 심층 강화학습을 깊게 이해하려는 사람에게 좋습니다.
주요 내용
● 심층 강화학습의 기본 원리
● 최신 심층 강화학습 기법
● 인간처럼 학습하는 심층 강화학습 에이전트 개발법
● 복잡한 상황에 적용할 수 있는 심층 강화학습 접근법

-
- 저자 : 미겔 모랄레스

CHAPTER 1 심층 강화학습의 기초
1.1 심층 강화학습이란 무엇인가?
1.2 심층 강화학습의 과거와 현재 그리고 미래
1.3 심층 강화학습의 적절성
1.4 두 가지의 명확한 기대치 설정
1.5 요약
CHAPTER 2 강화학습의 수학적 기초
2.1 강화학습의 구성 요소
2.2 MDP: 환경의 엔진
2.3 요약
CHAPTER 3 순간 목표와 장기 목표 간의 균형
3.1 의사결정을 내리는 에이전트의 목적
3.2 이상적인 행동들에 대한 계획
3.3 요약
CHAPTER 4 정보의 수집과 사용 간의 균형
4.1 평가가능한 피드백 해석의 어려움
4.2 전략적인 탐색
4.3 요약
CHAPTER 5 에이전트의 행동 평가
5.1 정책들의 가치를 추정하는 학습
5.2 여러 단계를 통해서 추정하는 학습
5.3 요약
CHAPTER 6 에이전트의 행동 개선
6.1 강화학습 에이전트의 구조
6.2 행동에 대한 정책을 개선하기 위한 학습
6.3 학습에서 행동을 분리하기
6.4 요약
CHAPTER 7 조금 더 효율적인 방법으로 목표에 도달하기
7.1 강건한 목표를 활용한 정책 개선 학습
7.2 상호작용, 학습 그리고 계획하는 에이전트
7.3 요약
CHAPTER 8 가치 기반 심층 강화학습 개요
8.1 심층 강화학습 에이전트가 사용하는 피드백의 유형
8.2 강화학습을 위한 함수 근사화
8.3 NFQ: 가치 기반 심층 강화학습을 위한 첫 번째 시도
8.4 요약
CHAPTER 9 조금 더 안정적인 가치 기반 학습 방법들
9.1 DQN: 강화학습을 지도학습처럼 만들기
9.2 이중 DQN: 행동-가치 함수에 대한 과도추정 극복
9.3 요약
CHAPTER 10 샘플 효율적인 가치 기반 학습 방법들
10.1 듀얼링 DDQN: 강화학습에 초점을 맞춘 신경망 구조
10.2 PER: 유의미한 경험 재현에 대한 우선순위 부여
10.3 요약
CHAPTER 11 정책-경사법과 액터-크리틱 학습법
11.1 REINFORCE: 결과기반 정책 학습
11.2 VPG: 가치함수 학습하기
11.3 A3C: 병렬적 정책 갱신
11.4 GAE: 강력한 이점 추정
11.5 A2C: 동기화된 정책 갱신
11.6 요약
CHAPTER 12 발전된 액터-크리틱 학습법
12.1 DDPG: 결정적 정책에 대한 근사화
12.2 TD3: DDPG를 넘어선 성능을 보이는 개선점들
12.3 SAC: 기대 반환값과 엔트로피를 최대화하기
12.4 PPO: 최적화 과정을 제한하기
12.5 요약
CHAPTER 13 범용 인공지능을 향한 길
13.1 다룬 내용과 다루지 못한 내용
13.2 범용 인공지능에 대한 조금 더 발전된 개념들
13.3 이후의 내용들
13.4 요약
부록 A 구글 콜랩에서의 실습 환경

