









출고예상일 안내
주문하신 상품이 한국에서 현지 배송을 위한 출고단계가 이루어질 것으로 예상되는 날짜입니다. 상품을 준비하는 과정에서 내부적인 사정으로 인해 출고예상일에 다소 오차가 생길 수 있습니다.
여러 상품(예약상품포함)을 함께 주문하신 경우 출고예상일이 가장 늦은 날짜에 맞춰 함께 배송됩니다.


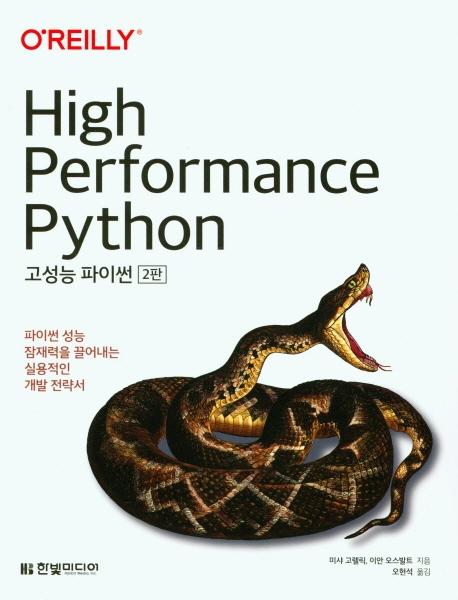
고성능 파이썬 [2판] 파이썬 성능 잠재력을 끌어내는 실용적인 개발 전략서
원제 : High Performance Python: Practical Performant Programming for Humans 2nd Edition
미샤 고렐릭, 이안 오스발트 저 | 오현석 역 | 한빛미디어 | 2021년 05월





ISBN : 9791162244210 / 528쪽 183 x 235 (㎜)
이 상품에 궁금하신점이 있으세요? 1:1상담문의



아래의 도서와 구매하시면 이 도서들의 적립금을 즉시적용해 드립니다.
-

클리커, 이희영, 강민혁
-
이지영
-

서길원, 김운호, 허상훈, 박재상, 박경규, 김종욱, 오윤우, 유지영
-
- 22,500
- 27,000
- 31,500
- 21,600


출판사 리뷰
▶ 파이썬 3 대응! ▶ 사전 지식 - 파이썬 중급 ▶ 먼저 보면 좋은 책 - 『혼자 공부하는 파이썬』 - 『처음 시작하는 파이썬(2판)』 - 『나의 첫 파이썬(2판)』 - 『파이썬 정복』 대상 독자 파이썬을 충분히 사용해보았고 특정 부분이 왜 느린지 생각해본 적이 있으며, 이를 위한 해법으로 거론되는 사이썬, 넘파이, PyPy 같은 기술을 들어본 독자가 대상이다. 또한 다른 언어로 프로그래밍해본 경험이 있어서 성능을 개선하는 방법이 여러 가지임을 아는 독자를 대상으로 한다. 또한 데이터 이동 문제를 포함하여 손쉽게 성능을 높일 수 있는 JIT 컴파일러(예컨대 PyPy)와 비동기 I/O를 사용하는 방법 등 웹 개발자가 직면할 수 있는 문제도 다룬다. 이 책은 중고급 파이썬 프로그래머를 위한 책이다. 의욕이 넘치는 초보 파이썬 프로그래머도 잘 따라올 수 있겠지만, 이 책을 읽기 전에 파이썬 기초를 먼저 다지기를 추천한다. 주요 내용 ● 넘파이, 사이썬, 프로파일러 더 잘 이해하기 ● 파이썬이 하부의 컴퓨터 아키텍처 추상화 방법 배우기 ● 프로파일링을 통해 CPU 소비 시간이나 메모리 사용량에서 병목 찾기 ● 적절한 데이터 구조를 선택해 효율적인 프로그램 작성하기 ● 행렬과 벡터 계산의 속도 높이기 ● 파이썬을 기계어로 번역하는 도구 사용하기 ● 다양한 입출력과 계산 연산을 동시 실행하고 관리하기 ● 다중 프로세싱 코드를 지역, 원격 클러스터에서 실행하도록 변환하기 ● 도커 등의 도구를 사용해 빠르게 프로그램 배치하기

-
- 저자 : 미샤 고렐릭, 이안 오스발트

-
- 역자 : 오현석

CHAPTER 1 고성능 파이썬 이해하기
1.1 기본 컴퓨터 시스템
1.2 기본 요소 조합하기
1.3 파이썬을 쓰는 이유
1.4 뛰어난 성과를 거두는 파이썬 프로그래머가 되는 방법
CHAPTER 2 프로파일링으로 병목 지점 찾기
2.1 효과적으로 프로파일하기
2.2 줄리아 집합
2.3 전체 줄리아 집합 계산하기
2.4 시간을 측정하는 간단한 방법: print와 데커레이터
2.5 유닉스 time 명령어를 이용한 간단한 시간 측정
2.6 cProfile 모듈 사용하기
2.7 SnakeViz로 cProfile 결과 시각화하기
2.8 line_profiler로 한 줄씩 측정하기
2.9 memory_profiler로 메모리 사용량 진단하기
2.10 PySpy로 기존 프로세스 살펴보기
2.11 바이트코드: 내부 작동
2.12 최적화 중에 단위 테스트하기
2.13 성공적인 코드 프로파일링 전략
2.14 마치며
CHAPTER 3 리스트와 튜플
3.1 더 효율적인 탐색
3.2 리스트와 튜플
3.3 마치며
CHAPTER 4 사전과 셋
4.1 사전과 셋의 동작 원리
4.2 사전과 네임스페이스
4.3 마치며
CHAPTER 5 이터레이터와 제너레이터
5.1 이터레이터로 무한급수 표현하기
5.2 제너레이터의 지연 계산
5.3 마치며
CHAPTER 6 행렬과 벡터 계산
6.1 문제 소개
6.2 파이썬의 리스트만으로 충분할까?
6.3 메모리 단편화
6.4 넘파이를 이용한 확산 방정식 해법
6.5 numexpr: 제자리 연산을 더 빠르고 간편하게 쓰기
6.6 경고: '최적화' 검증(사이파이)
6.7 행렬 최적화에서 얻은 교훈
6.8 팬더스
6.9 마치며
CHAPTER 7 C 언어로 컴파일하기
7.1 가능한 속도 개선의 종류
7.2 JIT 대 AOT 컴파일러
7.3 타입 정보가 실행 속도에 영향을 주는 이유
7.4 C 컴파일러 사용하기
7.5 줄리아 집합 예제 다시 보기
7.6 사이썬
7.7 pyximport
7.8 사이썬과 넘파이
7.9 Numba
7.10 PyPy
7.11 속도 향상 결과 정리
7.12 각 기술의 사용 시점
7.13 GPU
7.14 외부 함수 인터페이스
7.15 마치며
CHAPTER 8 비동기 I/O
8.1 비동기 프로그래밍 소개
8.2 async/await의 동작 방식
8.3 CPU 공유: I/O 부하
8.4 마치며
CHAPTER 9 multiprocessing 모듈
9.1 multiprocessing 모듈 소개
9.2 몬테 카를로 방식을 사용해 원주율 추정하기
9.3 프로세스와 스레드를 사용해 원주율 추정하기
9.4 소수 찾기
9.5 프로세스 간 통신을 사용해 소수 검증하기
9.6 multiprocessing과 넘파이 데이터 공유하기
9.7 파일과 변수 접근 동기화하기
9.8 마치며
CHAPTER 10 클러스터와 작업 큐
10.1 클러스터링의 이점
10.2 클러스터링의 단점
10.3 일반적인 클러스터 설계
10.4 클러스터화한 해법을 시작하는 방법
10.5 클러스터 사용 시 고통을 피하는 방법
10.6 두 가지 클러스터링 솔루션
10.7 강건한 프로덕션 클러스터링을 위한 NSQ
10.8 살펴볼 만한 다른 클러스터링 도구들
10.9 도커
10.10 마치며
CHAPTER 11 RAMM 덜 사용하기
11.1 값비싼 원시 타입 객체
11.2 컬렉션이 사용하는 RAM 이해하기
11.3 바이트와 유니코드
11.4 RAM에 많은 텍스트를 효율적으로 저장하기
11.5 사이킷런의 FeatureHasher를 사용해 더 많은 텍스트 모델링하기
11.6 DictVectorizer와 FeatureHasher
11.7 사이파이의 희소 행렬
11.8 RAM을 덜 사용하기 위한 팁
11.9 확률적 자료구조
CHAPTER 12 현장에서 얻은 교훈
12.1 특성 엔진으로 피처 엔지니어링 파이프라인 흐름 만들기
12.2 고성과 데이터 사이언스 팀
12.3 Numba
12.4 최적화 vs. 생각
12.5 어댑티브 랩의 소셜 미디어 분석, 소마(2014)
12.6 RadimRehurek.com의 딥러닝 플라이 만들기(2014)
12.7 Lyst.com의 대규모 머신러닝(2014)
12.8 스메시에서의 대규모 소셜 미디어 분석(2014)
12.9 성공적인 웹과 데이터 처리 시스템을 위한 PyPy(2014)
12.10 Lanyrd.com의 작업 큐(2014)

