









출고예상일 안내
주문하신 상품이 한국에서 현지 배송을 위한 출고단계가 이루어질 것으로 예상되는 날짜입니다. 상품을 준비하는 과정에서 내부적인 사정으로 인해 출고예상일에 다소 오차가 생길 수 있습니다.
여러 상품(예약상품포함)을 함께 주문하신 경우 출고예상일이 가장 늦은 날짜에 맞춰 함께 배송됩니다.




- 정가
- $80.00
- 판매가
-
$58.32
(27%↓)

- 적립금
- $1.17 (2%P)
품절된 상품입니다.
이 책을 꼭 원하시는 고객님께서는 아래 "상품문의"를 클릭 후 구매의사를
알려주세요. 책이 확보 될 경우 연락 드리겠습니다.



평점 - · 리뷰 0
ISBN : 9791161754925 / 460쪽 155 x 235 (㎜)
이 상품에 궁금하신점이 있으세요? 1:1상담문의



아래의 도서와 구매하시면 이 도서들의 적립금을 즉시적용해 드립니다.
-
엥지유니버스
-
321web(미쓰이 마사유키)
-

서길원, 김운호, 허상훈, 박재상, 박경규, 김종욱, 오윤우, 유지영
-

성구(강성규)
- 27,000
- 16,200
- 31,500
- 21,600


반디앤루니스 리뷰
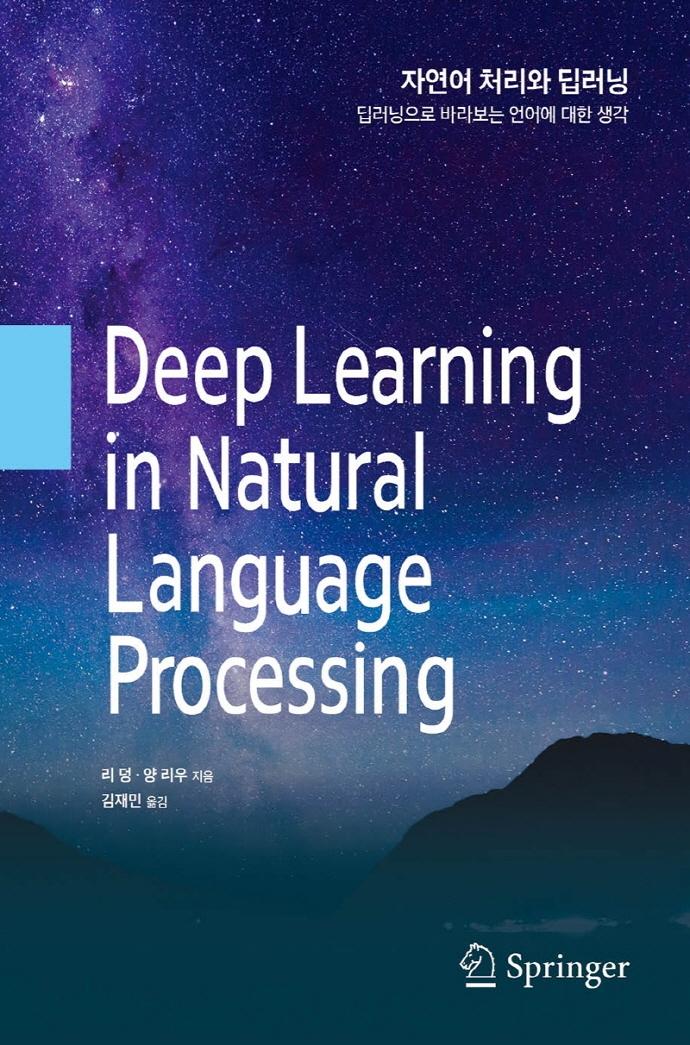
딥러닝을 포함한 머신러닝의 역사, 딥러닝과 통계 기반 머신러닝이 적용되는 영역, 딥러닝 디자인, 디자인 한계점과 해결 방법, 향후 연구 과제 등 코드 이면에 담겨있는 이야기를 전달하고자 여러 전문가가 참여했다. 문자 데이터의 컴퓨터 인식과 학습, 결과물 제시를 통해 만들 수 있는 자연어 처리 애플리케이션에 관심이 있다면 깊이 있는 지식과 혜안을 얻을 뿐만 아니라, 실무에 필요한 솔루션에 대해서도 아이디어를 얻을 수 있을 것이다.
출판사 리뷰
★ 이 책의 구성 ★
이 책은 11개의 장으로 구성된다.
1장: 자연어 처리와 딥러닝 소개(Li Deng과 Yang Liu)
2장: 대화 이해에 적용되는 딥러닝(Gokhan Tur, Asli Celikyilmaz, Xiaodong He, Dilek Hakkani-Tur, Li Deng)
3장: 음성 및 텍스트 기반 대화 시스템의 딥러닝(Asli Celikyilmaz, Li Deng, Dilek Hakkani-Tur)
4장: 어휘 분석 및 문법 분석에서 딥러닝(Wanxiang Che와 Yue Zhang)
5장: 지식 그래프의 딥러닝(Zhiyuan Liu와 Xianpei Han)
6장: 기계번역의 딥러닝(Yang Liu와 Jiajun Zhang)
7장: 질의응답의 딥러닝(Kang Liu와 Yansong Feng)
8장: 감성 분석의 딥러닝(Duyu Tang과 Meishan Zhang)
9장: 소셜 컴퓨팅의 딥러닝(Xin Zhao와 Chenliang Li)
10장: 이미지로부터 자연어 생성에서 딥러닝(Xiaodong He와 Li Deng)
11장: 에필로그(Li Deng과 Yang Liu)
1장에서는 자연어 처리와 딥러닝 전체 소개와 이후에 다룰 주요 내용을 리뷰한 다음 역사적인 발전을 세 가지 물결로 연계하고 향후 방향을 살펴본다. 2장에서 10장까지는 자연어 처리에 적용된 최근 학습 방법의 개별 애플리케이션을 다루는 장으로 구성된다. 각 장은 주요 연구자가 각 분야에서 적극적으로 실행했던 연구를 기반으로 한다.

-
- 저자 : 리 덩, 양 리우

-
- 역자 : 김재민

★ 지은이의 말 ★
컴퓨터가 인간의 언어를 지능적으로 처리하는 자연어 처리는 인공지능, 컴퓨터 과학, 인지 과학, 정보 처리 및 언어학과 다양하게 결합되는 중요한 학제 간 영역이다. 음성인식, 대화 시스템, 정보 검색, 질의응답, 기계번역 등 컴퓨터와 인간 언어의 상호작용을 통해 생성된 자연어 처리 애플리케이션은 사람들이 정보를 얻고 사용하는 생활 방식을 바꿔놓기 시작했다.
자연어 처리의 발전은 이성주의, 실증주의, 딥러닝 등 세 가지 주요 물결로 설명된다. 첫 번째 물결인 이성주의 접근법은 언어에 대한 지식을 물려받아 그 지식과 규칙이 사전에 고정돼 있다는 가정하에 자연어 처리 시스템에 지식을 통합하기 위해 사람 손으로 만든 규칙 설계를 옹호했다. 두 번째 물결인 실증주의 접근법은 자연어의 상세한 구조를 학습하는 데 감각기관에서 나온 풍부한 투입값과 관찰 가능한 언어 데이터가 필요충분조건임을 가정한다. 결과적으로 대규모 말뭉치에서 언어의 규칙성을 발견할 수 있는 확률 모델이 개발된다. 세 번째 물결에서는 딥러닝이 인간 인지능력을 시뮬레이션하는 방식으로 언어 데이터에서 내재적 표상(representation)을 학습하기 위해 생물학적 신경계에서 영감을 받은 비선형 계층모델을 활용한다.
딥러닝과 자연어 처리의 교차는 업무에 놀라운 성공을 가져왔다. 음성인식은 딥러닝이 큰 영향을 미친 최초의 산업용 자연어 처리 애플리케이션이다. 대규모 학습 데이터를 사용할 수 있게 되면서 심층신경망(Deep Neural Network) 방식은 전통적 실증 방식에 비해 인식 오류를 현저히 낮췄다. 자연어 처리에서 딥러닝을 성공적으로 적용한 또 다른 방법은 기계번역이다. 신경망을 사용해 언어 간 매핑을 모델링하는 엔드 투 엔드(end-to-end) 신경망 기계번역은 번역 품질을 크게 향상시켰다. 신경망 기계번역은 구글, 마이크로소프트, 페이스북, 바이두 등 대형 기술 회사가 제공하는 주요 상용 온라인 번역 서비스에서 사실상의 표준 기술이 됐다. 딥러닝을 활용하는 자연어 처리 제3의 물결에 올라타 언어 이해와 대화, 어휘 분석 및 구문 분석, 지식 그래프, 정보검색, 텍스트 형식의 질의 답변, 소셜 컴퓨팅, 언어 생성 및 텍스트 감정 분석 등 많은 분야에서 큰 진전을 이루고 있다. 현시점에서 딥러닝은 사실상 모든 자연어 처리 작업에 적용되는 지배적 방법이다.
★ 옮긴이의 말 ★
나는 IT업계에 종사하고 있는 딥러닝 전문가는 아니다. 대학에서 경영전략을 가르치고 연구하는 경영학자이지만, 마케팅과 경영전략을 위한 데이터 분석(Data Analysis for Marketing & Business Strategy)을 강의하고 있어서 데이터 과학의 변화에 정신줄을 놓지 않으려고 꾸준히 노력하고 있다. 전략경영을 주제로 연구하면서 자연스럽게 이르게 되는 종착지점은 “조직 의사결정자”들의 생각과 관심이었다. 그들이 생각하는 방향과 관심은 기업의 전략 변화와 행동에 영향을 미치기 때문에 학자에게는 좋은 연구 주제다. 또한 투자자에게는 경영자 위험(executive risks)을 줄일 수 있는 예측 모델의 정확성을 높일 수 있도록 하고 다양한 이해 관계자에게는 사회에 영향을 미칠 수 있는 기업 행동의 가능성을 판단하는 데 중요한 신호가 된다.
조직 의사 결정자뿐만 아니라 사회생활을 영위해 가고 있는 개인도 급성장해온 소셜미디어 덕분에 다양한 방식으로 소통하고 인터넷상에 엄청난 양의 글을 남기고 있다. 이처럼 글로 된 자료는 많아져도, 행과 열에 맞게 쉽게 정리할 수 있었던 숫자 데이터와 달리, 글은 다양한 문자 조합을 통해 개인마다 쓰는 스타일이 다르고, 같은 말을 해도 뜻이 다르다. 심지어 같은 의미지만 말하는 순서도 다른 문자 데이터를 컴퓨터에게 알려주고 이해시켜 결과를 받아낸다는 아이디어 자체가 어렵기 때문에 자연어로 된 문자 데이터 분석에 진입장벽이 있다.
이번 책을 번역하기 전에는 문자 데이터 분석에 대한 인류의 노력이 얼마나 오랫동안 진행돼 왔는지 몰랐다. 다만 문서를 활용해 진행해왔던 나의 연구 방법 변화는 저자들이 1장에서 소개한 딥러닝 기반 자연어 처리에 이르는 역사적 과정과 매우 유사해 놀랐고, 사람들이 생각하는 흐름이 비슷하단 깨달음에 반갑기도 했다. 박사과정에서 글을 분석할 때 처음 사용했던 방법은 분석 대상 문서의 내용을 인식할 수 있는 단어와 구가 들어간 ‘사전(dictionary)’을 개발하는 작업이었다. 이 부분은 책의 저자들이 말하는 룰(rule) 기반 학습에 해당한다. 미리 준비한 사전에 충분한 어휘들이 있고 분석해야 할 표적 문서에 있는 단어들을 커버할 수 있다면 효율적인 방식이지만, 단어 의미와 사용법이 시간과 장소가 변하면서 달라지기도 하고 새로운 용어들이 등장하기 때문에 적용 범위가 매우 협소하다는 치명적인 문제점이 있다.
협소한 적용 범위의 일반화 한계점을 극복하기 위해 여러 방법을 찾던 중 머신러닝을 알게 됐는데, 저자들이 말하는 통계 기반 학습과 일치한다. 혼자서 머신러닝을 배우기 시작했을 때, 머신러닝이 소위 ‘낮은 학습(shallow learning)’과 ‘깊은 학습(deep learning, 딥러닝)’으로 나뉘는지 몰랐다. 낮은 학습은 수집한 문서를 컴퓨터가 인식하고, 조건부 확률 방식으로 내용을 분류하는 모델을 학습하기 때문에 특정 ‘사전’에 의존하는 원칙 기반 방식에 비해 적용 범위가 넓어졌다. 하지만 컴퓨터가 의미를 이해하고 분류한 것이냐는 원천적인 질문에 대한 답변은 룰 기반과 마찬가지로 오로지 구조로만 판단하는 문제점 때문에 사람이 분류된 내용을 직접 읽어서 검증해야 한다는 한계점에 부딪치게 됐다.
결국 인류에게 한계점 극복에 대한 욕망의 끝은 없는 것 같다. 번역자인 나는 기계에게 말의 구조뿐만 아니라 의미까지 학습시켜서 진정으로 문서를 분석했다고 말하고 싶기 때문에 해결책의 방향은 자연스럽게 딥러닝으로 향한다. 개인적으로는 딥러닝 방법론을 사용해 경영학 저널에 논문을 출판해 보겠다는 목표가 있으며, 번역을 통해 구체적으로 적용 방법에 관한 큰 그림을 그릴 수 있어 즐거웠다. 이 책은 코드를 보고 따라 하면서 결과물을 실행할 수 있는 공구 상자를 제공하지 않는다. 대신 딥러닝을 포함한 머신러닝의 역사, 딥러닝과 통계 기반 머신러닝이 적용되는 영역, 딥러닝 디자인, 디자인 한계점과 해결 방법, 향후 연구 과제 등 코드 이면에 담겨 있는 이야기를 여러 전문가의 참여로 제작했다.
나처럼 숫자 데이터를 넘어 문자 데이터의 컴퓨터 인식과 학습, 결과물 제시를 통해 만들 수 있는 자연어 처리 애플리케이션에 관심이 있다면 좋은 지식과 혜안, 아이디어를 줄 수 있는 책이라 생각한다. 실제로 R과 파이썬으로 자연어 처리 작업을 진행하면서 어떤 솔루션을 적용해야 할지에 대한 아이디어가 깊어진다고 느끼는 것은 이 책에서 얻을 수 있었던 또 다른 즐거움이었다.


1장. 자연어 처리와 딥러닝 소개
1.1 자연어 처리: 기본 내용
1.2 첫 번째 물결: 이성주의
1.3 두 번째 물결: 실증주의
1.4 세 번째 물결: 딥러닝
1.5 미래로의 전환
1.5.1 실증주의에서 딥러닝으로: 혁명
1.5.2 현재 딥러닝 기술의 한계
1.6 자연어 처리의 향후 방향
1.6.1 신경망과 기호의 통합
1.6.2 구조, 기억 그리고 지식
1.6.3 비지도학습과 생성 딥러닝
1.6.4 다중양식 및 멀티태스킹 딥러닝
1.6.5 메타러닝
1.7 요약
2장. 대화 이해에 사용되는 딥러닝
2.1 소개
2.2 역사적 관점
2.3 주요 언어 이해 작업
2.3.1 도메인 탐지 및 의도 결정
2.3.2 슬롯 채우기
2.4 기술의 고도화: 통계 모델링에서부터 딥러닝까지
2.4.1 도메인 탐지와 의도 결정
2.4.2 슬롯 채우기
2.4.3 멀티태스크 멀티도메인 연결 모델링
2.4.4 문맥에서 이해하기
2.5 요약
3장. 음성 및 텍스트 기반 대화 시스템에 사용되는 딥러닝
3.1 서론
3.2 대화 시스템의 구성 요소 학습 방법
3.2.1 판별 방법
3.2.2 생성 방법
3.2.3 의사 결정
3.3 목표 지향 신경 대화 시스템
3.3.1 신경망 언어 이해
3.3.2 대화 상태 추적기
3.3.3 심층 대화 관리자
3.4 모델 기반 사용자 시뮬레이터
3.5 자연어 생성
3.6 대화 시스템 구축을 위한 엔드 투 엔드 딥러닝 방식
3.7 오픈 대화 시스템을 위한 딥러닝
3.8 대화 모델링을 위한 데이터셋
3.8.1 카네기 멜론 커뮤니케이터 말뭉치
3.8.2 ATIS: 항공 여행 정보 시스템 파일럿 말뭉치
3.8.3 대화 상태 추적 챌린지 데이터셋
3.8.4 말루바 프레임 데이터셋
3.8.5 페이스북 대화 데이터셋
3.8.6 우분투 대화 말뭉치
3.9 오픈소스 대화 소프트웨어
3.10 대화 시스템 평가
3.11 요약
4장. 어휘 분석과 문장 분석에 사용되는 딥러닝
4.1 배경
4.2 어휘 분석과 문법 분석
4.2.1 단어 세분화
4.2.2 형태소 분석
4.2.3 구문 분석
4.2.4 구조화된 예측
4.3 구조화 예측 방법
4.3.1 그래프 기반 방법
4.3.2 전이 기반 방법들
4.4 신경그래프 기반 방법
4.4.1 신경조건부 랜덤 필드
4.4.2 신경망 그래프 기반의 의존 분석
4.5 신경망 전이 기반 방법
4.5.1 그리디 이동 축소 의존 분석
4.5.2 그리디 시퀀스 레이블링
4.5.3 전역 최적화 모델
4.6 요약
5장. 지식 그래프에서 사용되는 딥러닝
5.1 서론
5.1.1 기본 개념
5.1.2 전형적인 지식 그래프
5.2 지식 표상 학습
5.3 신경망 관계 추출
5.3.1 문장 수준 신경망 관계 추출
5.3.2 문서 수준 신경망 관계 추출
5.4 텍스트와 지식 연결: 개체 연결
5.4.1 개체 연결 프레임워크
5.4.2 개체 연결 딥러닝
5.5 요약
6장. 기계번역에 사용되는 딥러닝
6.1 서론
6.2 통계 기계번역과 그 과제
6.2.1 기본 내용
6.2.2 통계 기계번역 과제
6.3 기계번역을 위한 구성 요소 수준 딥러닝
6.3.1 단어 배열을 위한 딥러닝
6.3.2 번역 규칙 확률 추정 딥러닝
6.3.3 구 재배열을 위한 딥러닝
6.3.4 언어 모델링을 위한 딥러닝
6.3.5 피처 조합을 위한 딥러닝
6.4 기계번역을 위한 엔드 투 엔드 딥러닝
6.4.1 인코더 - 디코더 프레임워크
6.4.2 기계번역에 사용되는 신경망 관심
6.4.3 잘 쓰이지 않는 어휘의 기술적 문제점 다루기
6.4.4 평가 지표를 최적화하는 엔드 투 엔드 학습
6.4.5 사전 지식 투입하기
6.4.6 자원이 부족한 언어 번역
6.4.7 신경망 기계번역에서 네트워크 구조
6.4.8 통계 기계번역과 신경망 기계번역의 조합
6.5 요약
7장. 질의응답에 사용되는 딥러닝
7.1 서론
7.2 지식 기반 질의에 사용되는 딥러닝
7.2.1 정보 추출 스타일
7.2.2 의미 분석 스타일
7.2.2
7.2.3 정보 추출 스타일 대 의미 분석 스타일
7.2.4 데이터 종류
7.2.5 도전 과제
7.3 기계 이해에 사용되는 딥러닝
7.3.1 태스크 설명
7.3.2 기계 이해에서 피처 엔지니어링 방법
7.3.3 기계 이해를 위한 딥러닝
7.4 요약
8장. 딥러닝으로 하는 감성 분석
8.1 소개
8.2 감성 기반 단어 임베딩
8.3 문장 수준 감성 분석
8.3.1 컨볼루션 신경망
8.3.2 순환 신경망
8.3.3 재귀신경망
8.3.4 외부 자원 통합
8.4 문서 수준 감성 분류
8.5 정밀하게 정제된 감성 분석
8.5.1 의견 마이닝
8.5.2 표적 감성 분석
8.5.3 특정 면 수준 감성 분석
8.5.4 입장 포착
8.5.5 풍자 감지
8.6 요약
9장. 소셜 컴퓨팅에서 사용되는 딥러닝
9.1 소셜 컴퓨팅 소개
9.2 딥러닝으로 하는 사용자 생성 콘텐츠 모델링
9.2.1 전통적 의미 표상
9.2.2 얕은 임베딩으로 의미 표상하기
9.2.3 심층신경망으로 하는 의미 표상
9.2.4 관심 메커니즘으로 의미 표상 강화하기
9.3 딥러닝을 사용한 소셜 커넥션 모델링
9.3.1 소셜미디어 소셜 커넥션
9.3.2 소셜 커넥션을 모델링하는 네트워크 학습법
9.3.3 얕은 임베딩 모델
9.3.4 심층신경망 모델
9.3.5 네트워크 임베딩 적용
9.4 딥러닝을 이용한 추천
9.4.1 소셜미디어에서 추천
9.4.2 전통 추천 알고리즘
9.4.3 얕은 임베딩 기반 모델
9.4.4 심층신경망 기반 모델
9.5 요약
10장. 이미지로부터 자연어 생성을 위한 딥러닝
10.1 소개
10.2 배경
10.3 이미지에서 나온 자연어 생성을 위한 딥러닝 프레임워크
10.3.1 엔드 투 엔드 프레임워크
10.3.2 구성 프레임워크
10.3.3 기타 프레임워크
10.4 평가 지표 및 벤치마크
10.5 이미지 캡셔닝의 산업 배치
10.6 예제: 이미지에 대한 자연어 설명
10.7 이미지에서 스타일리시한 자연어 생성 최근 연구
10.8 요약
11장. 에필로그: 딥러닝 시대에 자연어 처리의 경계
11.1 소개
11.2 두 가지 새로운 관점
11.2.1 태스크 관점
11.2.2 표상 관점
11.3 자연어 처리를 위한 딥러닝의 주요 발전과 연구 경계선
11.3.1 일반화를 위한 구성
11.3.2 자연어 처리에 대한 비지도학습
11.3.3 자연어 처리를 위한 강화학습
11.3.4 자연어 처리를 위한 메타학습
11.3.5 해석 가능성: 약한 센스와 강한 센스
11.4 요약

