









출고예상일 안내
주문하신 상품이 한국에서 현지 배송을 위한 출고단계가 이루어질 것으로 예상되는 날짜입니다. 상품을 준비하는 과정에서 내부적인 사정으로 인해 출고예상일에 다소 오차가 생길 수 있습니다.
여러 상품(예약상품포함)을 함께 주문하신 경우 출고예상일이 가장 늦은 날짜에 맞춰 함께 배송됩니다.


데이터 과학 트레이닝 북 넘파이, 사이파이, 판다스, 매트플롯립을 활용하여 직접 실습해 보는
츠카모토 쿠니타카, 야마다 노리카즈, 오오사와 후미타카 저 | 최재원 역 | 인사이트 | 2020년 12월
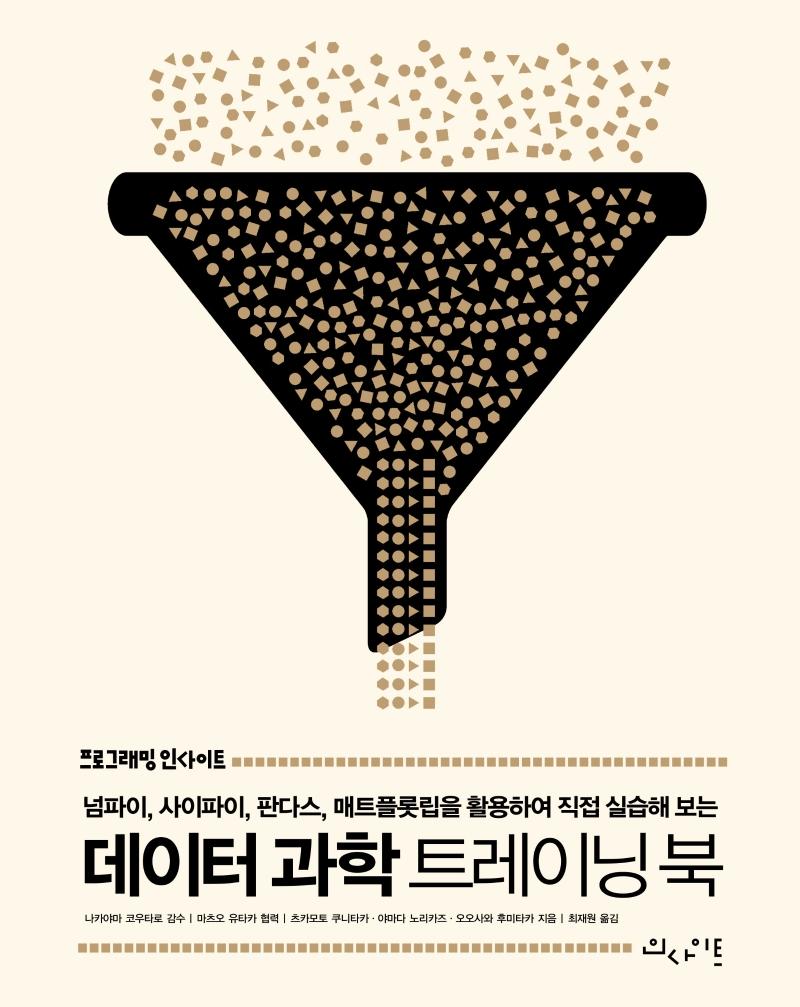





ISBN : 9788966262892 / 471쪽 188 x 240 (㎜)
이 상품에 궁금하신점이 있으세요? 1:1상담문의



아래의 도서와 구매하시면 이 도서들의 적립금을 즉시적용해 드립니다.
-
정지훈
-
김희재
-
빨간고래(박정아)
-
정그린
- 25,200
- 26,820
- 24,300
- 23,400


출판사 리뷰
[이 책에서 다루는 내용] ▶ 파이썬, 넘파이, 사이파이, 판다스, 매트플롯립 사용법 ▶ 확률, 통계, 추정, 회귀 기초 ▶ 넘파이, 사이파이를 활용한 과학 계산 ▶ 판다스를 이용한 데이터 다루기 ▶ 매트플롯립을 이용한 데이터 시각화 ▶ 주피터 노트북 사용법 ▶ 사이킷런을 이용한 머신러닝 모델 구현

-
- 저자 : 츠카모토 쿠니타카, 야마다 노리카즈, 오오사와 후미타카

-
- 역자 : 최재원

1장 책의 개요와 파이썬 기초
1.1 데이터 과학자의 업무
--1.1.1 데이터 과학자의 업무
--1.1.2 데이터 분석 프로세스
--1.1.3 이 책의 구성
--1.1.4 이 책을 읽는 데 필요한 기초 지식과 유익한 참고문헌
--1.1.5 직접 해보며 연습합시다
1.2 파이썬 기초
--1.2.1 주피터 노트북 사용법
--1.2.2 파이썬 기초
--1.2.3 리스트와 딕셔너리
--1.2.4 조건 분기와 반복문
--1.2.5 함수
--1.2.6 클래스와 인스턴스
2장 과학 계산, 데이터 처리, 기초적인 그래프 제작 라이브러리 사용법
2.1 데이터 분석을 위한 라이브러리
--2.1.1 라이브러리 임포트
--2.1.2 매직 명령어
--2.1.3 라이브러리 임포트
2.2 넘파이 기초
--2.2.1 넘파이 임포트
--2.2.2 배열 생성과 조작, 가공
--2.2.3 난수
--2.2.4 행렬
2.3 사이파이 기초
--2.3.1 사이파이 라이브러리 임포트
--2.3.2 행렬연산
--2.3.3 뉴턴법
2.4 판다스 기초
--2.4.1 판다스 라이브러리 임포트
--2.4.2 Series 사용법
--2.4.3 DataFrame 사용법
--2.4.4 행렬 다루기
--2.4.5 데이터 추출
--2.4.6 데이터 삭제와 결합
--2.4.7 집계
--2.4.8 정렬
--2.4.9 nan(null) 판정
2.5 매트플롯립 기초
--2.5.1 매트플롯립 사용 준비
--2.5.2 산점도
--2.5.3 그래프 분할
--2.5.4 함수 그래프 그리기
--2.5.5 히스토그램
3장 기술통계와 단순회귀분석
3.1 통계의 종류
--3.1.1 기술통계와 추론통계
--3.1.2 라이브러리 임포트
3.2 데이터 입력과 기본 분석
--3.2.1 인터넷 등에 올라 있는 데이터를 읽어 들이기
--3.2.2 데이터 읽기와 확인
--3.2.3 데이터 특성 파악
--3.2.4 정량 데이터와 정성 데이터
3.3 기술통계
--3.3.1 히스토그램
--3.3.2 평균, 중앙값, 최빈값
--3.3.3 분산과 표준편차
--3.3.4 요약 통계량과 백분위수
--3.3.5 박스플롯 그래프
--3.3.6 변동계수
--3.3.7 산점도와 상관계수
--3.3.8 모든 변수의 히스토그램과 산점도 그리기
3.4 단순회귀분석
--3.4.1 선형회귀분석
--3.4.2 결정계수
4장 확률과 통계 기초
4.1 확률과 통계 학습을 위한 사전 준비
--4.1.1 학습을 위한 사전 지식
--4.1.2 라이브러리 임포트
4.2 확률
--4.2.1 수학적 확률
--4.2.2 통계적 확률
--4.2.3 조건부 확률과 곱셈 공식
--4.2.4 독립과 종속
--4.2.5 베이즈 정리
4.3 확률변수와 확률분포
--4.3.1 확률변수, 확률함수, 분포함수, 기댓값
--4.3.2 다양한 분포함수
--4.3.3 커널 밀도함수
4.4 심화학습 : 다차원확률분포
--4.4.1 결합확률분포와 주변확률분포
--4.4.2 조건부 확률 함수와 조건부 기댓값
--4.4.3 독립과 연속분포
4.5 추론통계학
--4.5.1 대수 법칙
--4.5.2 중심극한정리
--4.5.3 표본분포
4.6 통계적 추정
--4.6.1 추정량과 점추정
--4.6.2 불편성과 일치성
--4.6.3 구간추정
--4.6.4 추정량 계산
4.7 통계적 검정
--4.7.1 검정
--4.7.2 제1종 오류와 제2종 오류
--4.7.3 빅데이터 검정
5장 파이썬을 이용한 과학 계산(넘파이와 사이파이)
5.1 개요와 사전준비
--5.1.1 개요
--5.1.2 라이브러리 임포트
5.2 넘파이를 이용한 계산 방법
--5.2.1 인덱스 참조
--5.2.2 넘파이를 이용한 연산 작업
--5.2.3 배열의 조작과 브로드캐스트
5.3 사이파이 응용
--5.3.1 보간법
--5.3.2 선형대수: 행렬 분해
--5.3.3 적분과 미분방정식
--5.3.4 최적화
6장 판다스를 이용해 데이터 다루기
6.1 개요와 사전준비
--6.1.1 라이브러리 임포트
6.2 판다스로 데이터를 다루는 기본적인 방법
--6.2.1 계층적 인덱스
--6.2.2 데이터 결합
--6.2.3 데이터 조작과 변환
--6.2.4 데이터 집계와 그룹 연산
6.3 결측 데이터와 이상값 처리
--6.3.1 결측 데이터 대처 방법
--6.3.2 이상값을 다루는 방법
6.4 시계열 데이터 분석 방법 기초
--6.4.1 시계열 데이터 조작과 변환
--6.4.2 이동평균
7장 매트플롯립을 이용한 데이터 시각화
7.1 데이터 시각화
--7.1.1 데이터 시각화
--7.1.2 라이브러리 임포트
7.2 데이터 시각화 기초
--7.2.1 막대 그래프
--7.2.2 원 그래프
7.3 응용 : 금융 데이터 시각화
--7.3.1 시각화 대상 금융 데이터
--7.3.2 캔들 차트 생성 라이브러리
7.4 응용: 분석 결과 제시
--7.4.1 보고서를 만들 때 주의할 점
8장 머신러닝 기초(지도학습)
8.1 머신러닝 개요
--8.1.1 머신러닝이란
--8.1.2 지도학습
--8.1.3 비지도학습
--8.1.4 강화학습
--8.1.5 라이브러리 임포트
8.2 다중회귀
--8.2.1 자동차 가격 데이터 읽어 들이기
--8.2.2 데이터 정리
--8.2.3 모델 구축과 평가
--8.2.4 모델 구축 및 모델 평가 과정 정리
8.3 로지스틱회귀
--8.3.1 로지스틱회귀 예
--8.3.2 데이터 정리
--8.3.3 모델 구축과 평가
--8.3.4 스케일링을 통한 예측 정확도 향상
8.4 정규화 항이 있는 회귀: 리지회귀, 라소회귀
--8.4.1 라소회귀, 리지회귀의 특징
--8.4.2 다중회귀와 리지회귀 비교
8.5 의사결정나무
--8.5.1 버섯 데이터 세트
--8.5.2 데이터 정리
--8.5.3 엔트로피: 불순도 지표
--8.5.4 정보이득: 분기 조건의 효용성 측정
--8.5.5 의사결정 모델 구축
8.6 k-NN(k최근접이웃법)
--8.6.1 k-NN 모델 구축
8.7 서포트벡터머신
--8.7.1 서포트 벡터 머신 모델 구축
9장 머신러닝 기초(비지도 학습)
9.1 비지도학습 252
--9.1.1 비지도학습 모델 종류
--9.1.2 라이브러리 임포트
9.2 군집분석
--9.2.1 k-means
--9.2.2 k-means 군집 분석
--9.2.3 금융 마케팅 데이터를 이용한 군집분석
--9.2.4 엘보우법으로 군집 수 추정
--9.2.5 군집분석 결과 해석
--9.2.6 k-means 이외의 방법
9.3 주성분 분석
--9.3.1 주성분 분석
--9.3.2 주성분 분석 실습
9.4 장바구니 분석과 연관 규칙
--9.4.1 장바구니 분석
--9.4.2 장바구니 분석을 위한 샘플 데이터 입력
--9.4.3 연관 규칙
10장 모델 검증과 튜닝
10.1 모델 평가와 정확도를 향상시키는 방법
--10.1.1 머신러닝의 과제와 해결 방법
--10.1.2 라이브러리 임포트
10.2 모델 평가와 퍼포먼스 튜닝
--10.2.1 홀드아웃과 교차검증
--10.2.2 모델 튜닝: 하이퍼파라미터 튜닝
--10.2.3 모델 튜닝: 특징 튜닝
--10.2.4 모델의 종류
10.3 모델 성능 평가 지표
--10.3.1 분류 모델 평가: 오차행렬과 연관 지표
--10.3.2 분류 모델 평가:ROC 곡선과 AUC
--10.3.3 회귀 모델 평가지표
10.4 앙상블 학습
--10.4.1 배깅
--10.4.2 부스팅
--10.4.3 랜덤 포레스트, 그레이디언트 부스팅
--10.4.4 향후 학습을 위한 참고문헌 소개
11장 종합연습문제
11.1 종합연습문제
--11.1.1 종합연습문제(1)
--11.1.2 종합연습문제(2)
--11.1.3 종합연습문제(3)
--11.1.4 종합연습문제(4)
--11.1.5 종합연습문제(5)
--11.1.6 종합연습문제(6)
--11.1.7 참고: 공개 데이터 활용
부록 1 실습환경 구축
A.1.1 아나콘다(Anaconda)
A.1.2 아나콘다 패키지 다운 받기
A.1.3 아나콘다 설치
A.1.4 pandas-datareader 및 Plotly 설치
부록 2 연습문제 해답
A.2.1 1장 연습문제
A.2.2 2장 연습문제
A.2.3 3장 연습문제
A.2.4 4장 연습문제
A.2.5 5장 연습문제
A.2.6 6장 연습문제
A.2.7 7장 연습문제
A.2.8 8장 연습문제
A.2.9 9장 연습문제
A.2.10 10장 연습문제
A.2.11 11장 종합연습문제
부록 3 참고문헌 참고 URL
A.3.1 참고문헌
A.3.2 참고 URL
마치며
찾아보기

