









출고예상일 안내
주문하신 상품이 한국에서 현지 배송을 위한 출고단계가 이루어질 것으로 예상되는 날짜입니다. 상품을 준비하는 과정에서 내부적인 사정으로 인해 출고예상일에 다소 오차가 생길 수 있습니다.
여러 상품(예약상품포함)을 함께 주문하신 경우 출고예상일이 가장 늦은 날짜에 맞춰 함께 배송됩니다.


파이썬과 대스크를 활용한 고성능 데이터 분석 대규모 데이터셋 분석, 시각화, 모델링부터 분산 앱 패키징과 배포까지
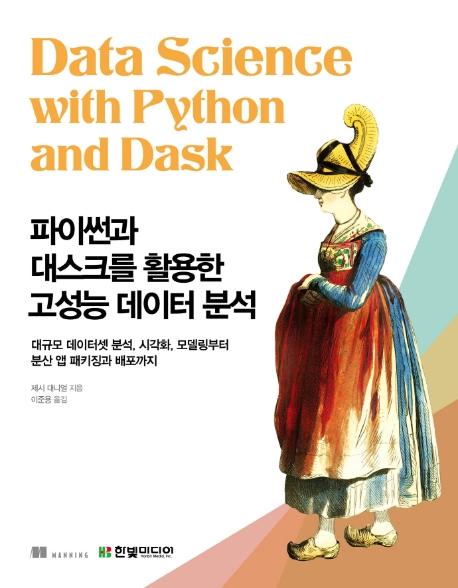





ISBN : 9791162243305 / 360쪽 183 x 235 (㎜)
이 상품에 궁금하신점이 있으세요? 1:1상담문의



아래의 도서와 구매하시면 이 도서들의 적립금을 즉시적용해 드립니다.
-

거트루드(박태현)
-
321web(미쓰이 마사유키)
-
빨간고래(박정아)
-
- 23,400
- 16,200
- 24,300
- 19,800


반디앤루니스 리뷰
2. 책 소개
데이터 과학의 전체 워크플로를 단계별로 소개하는 종합 안내서
이 책은 대스크를 활용한 데이터 정리에서 배포에 이르기까지 데이터 과학의 일반적인 워크플로를 따라가는 여정으로 우리를 안내한다. 먼저 확장 가능한 컴퓨팅을 익히고 이를 대스크가 어떤 방식으로 활용하는지 살펴본다. 이어서 다양한 실제 데이터셋을 준비하고 분석, 시각화, 모델링하는 과정에서 대스크로 일반적인 데이터 과학 작업을 수행하는 방법을 실용 예제로 제공한다. 마지막으로 AWS에 자신만의 대스크 클러스터를 배포해 분석 코드를 확장하는 과정을 단계별로 소개한다.
주요 대상 독자는 초중급 데이터 과학자나 데이터 엔지니어다. 단일 머신의 한계를 벗어나는 크기의 데이터 작업을 아직 경험해보지 못했다면 특히 유용할 것이다. 파이스파크 등 다른 분산 프레임워크를 이전에 다뤄본 경험이 있다면 대스크만의 기능과 효율성을 비교해보는 것만으로도 도움이 될 것이다.
출판사 리뷰
파이썬 병렬 컴퓨팅을 실현하는 대스크로 더 쉽고 효율적인 데이터 분석하기 파이썬을 이용한 데이터 작업을 경험해본 사람이라면 한 번쯤 팬더스와 넘파이 패키지를 접해봤을 것이다. 하지만 대스크라는 패키지는 조금 낯설 수 있다. 대스크는 데이터 과학 분야에서 매우 유용하게 활용할 수 있는 도구다. 특히 이 책은 ‘대용량 데이터의 병렬 처리’라는 주제를 이해하기 쉬운 비유와 상세한 설명을 통해 쉽게 풀어놓았다. 기존에 팬더스와 넘파이를 이용하여 데이터를 처리한 경험이 있는 개발자라면 코드 예제를 따라 하기만 해도 대스크의 기본 원리와 새로운 기능을 금방 파악할 수 있을 것이다. 이 책이 대스크라는 새로운 ‘강력한 무기’를 하나 더 장착할 좋은 기회가 되기를 바란다. 주요 내용 ●\t대규모 정형/비정형 데이터 작업하기 ●\t시본과 데이터 셰이더를 사용한 시각화 ●\t필요한 알고리즘 직접 구현하기 ●\tDask Distributed로 분산 앱 빌드 ●\t대스크 앱 패키징과 배포

-
- 저자 : 제시 대니얼

-
- 역자 : 이준용

Part I 확장 가능한 컴퓨팅의 빌딩 블록
CHAPTER 1 왜 확장 가능한 컴퓨팅이 중요한가?
__1.1 왜 대스크인가?
__1.2 DAG 요리하기
__1.3 확장성, 동시성과 복구
__1.4 예제 데이터셋 소개
__1.5 마치며
CHAPTER 2 대스크 시작하기
__2.1 데이터 프레임 API와의 첫 만남
__2.2 DAG 시각화하기
__2.3 작업 스케줄링
__2.4 마치며
Part II 대스크 데이터 프레임을 이용해 정형 데이터 작업하기
CHAPTER 3 대스크 데이터 프레임 소개하기
__3.1 왜 데이터 프레임을 사용하는가?
__3.2 대스크와 팬더스
__3.3 대스크 데이터 프레임의 한계
__3.4 마치며
CHAPTER 4 대스크 데이터 프레임으로 데이터 불러오기
__4.1 텍스트 파일에서 데이터 읽기
__4.2 관계형 데이터베이스에서 데이터 읽어오기
__4.3 HDFS와 S3에서 데이터 읽어오기
__4.4 파케이 형식으로 데이터 읽어오기
__4.5 마치며
CHAPTER 5 데이터 프레임의 정리와 변환
__5.1 인덱스 및 축 작업하기
__5.2 결측값 다루기
__5.3 데이터 기록하기
__5.4 요소별 연산
__5.5 데이터 프레임의 필터링과 재색인
__5.6 데이터 프레임들을 조인하고 연결하기
__5.7 텍스트 파일과 파케이 파일에 데이터 쓰기
__5.8 마치며
CHAPTER 6 데이터 프레임 요약과 분석
__6.1 기술 통계
__6.2 내장된 집계 함수
__6.3 사용자 정의 집계 함수
__6.4 롤링(윈도우) 함수
__6.5 마치며
CHAPTER 7 시본 라이브러리로 데이터 프레임 시각화하기
__7.1 준비-리듀스-수집-플롯 패턴
__7.2 scatterplot 함수와 regplot 함수로 연속형 관계 시각화하기
__7.3 바이올린 플롯으로 범주형 관계 시각화하기
__7.4 히트맵으로 두 가지 범주형 관계 시각화하기
__7.5 마치며
CHAPTER 8 데이터 셰이더로 위치 데이터 시각화하기
__8.1 데이터 셰이더란 무엇이며 어떤 원리로 동작하는가?
__8.2 대화식 히트맵으로 위치 데이터 플로팅하기
__8.3 마치며
Part III 대스크의 확장과 배포
CHAPTER 9 백(Bags)과 배열 활용하기
__9.1 Bags으로 비정형 데이터 읽고 파싱하기
__9.2 요소 변형, 요소 필터링, 그리고 요소 폴딩하기
__9.3 Bags으로부터 배열 및 데이터 프레임 만들기
__9.4 자연어 툴킷으로 병렬 텍스트 분석을 위해 Bags 사용하기
__9.5 마치며
CHAPTER 10 대스크 ML을 이용한 머신러닝
__10.1 대스크 ML로 선형 모델 만들기
__10.2 대스크 ML 모델 평가 및 튜닝
__10.3 대스크 ML 모델 저장하기
__10.4 마치며
CHAPTER 11 대스크 확장 및 배포
__11.1 도커로 아마존 AWS에서 대스크 클러스터 빌드하기
__11.2 클러스터에서 대스크 작업 실행하고 모니터링하기
__11.3 AWS에서 대스크 클러스터 정리하기
__11.4 마치며
APPENDIX A 소프트웨어 설치
__A.1 아나콘다로 추가 패키지 설치하기
__A.2 아나콘다 없이 패키지 설치하기
__A.3 주피터 노트북 서버 시작하기
__A.4 NLTK 구성하기
7. 관련 서적 (제목 + ISBN)
●\t파이썬 라이브러리를 활용한 머신러닝(번역개정판) / 9791162241646
●\t파이썬 라이브러리를 활용한 데이터 분석(2판) / 9791162241905
●\t파이썬 데이터 분석 입문 / 9791162240144

