









출고예상일 안내
주문하신 상품이 한국에서 현지 배송을 위한 출고단계가 이루어질 것으로 예상되는 날짜입니다. 상품을 준비하는 과정에서 내부적인 사정으로 인해 출고예상일에 다소 오차가 생길 수 있습니다.
여러 상품(예약상품포함)을 함께 주문하신 경우 출고예상일이 가장 늦은 날짜에 맞춰 함께 배송됩니다.


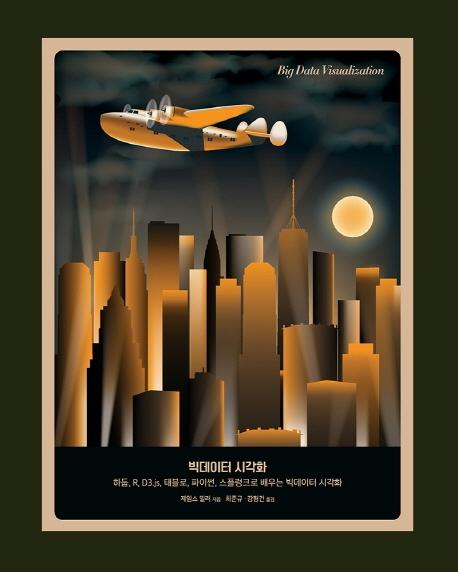





ISBN : 9791161753706 / 328쪽 188 x 235 (㎜)
이 상품에 궁금하신점이 있으세요? 1:1상담문의



아래의 도서와 구매하시면 이 도서들의 적립금을 즉시적용해 드립니다.
-

코리아교육그룹 교육연구소
-

서길원, 김운호, 허상훈, 박재상, 박경규, 김종욱, 오윤우, 유지영
-
-
- 19,800
- 31,500
- 20,700
- 21,600



반디앤루니스 리뷰
빅데이터 시각화를 배우고 이를 익히기 위한 도전 과제(접근 속도, 문맥 이해/추가, 데이터 품질 향상, 결과 표시, 이상점 등)를 다룬다. 가장 대중적인 라이브러리에 초점을 두고, 하둡(Hadoop), R, D3.js, 파이썬, 스플렁크, 태블로(Tableau)와 같은 빅데이터 시각화 도구를 소개한다. 또한 데이터 도구 사용 및 기초 분석론과 같은 주제를 통해 데이터가 다양한 변수와 사용 사례에 따라 어떻게 달라지는지 보여준다.
출판사 리뷰

-
- 저자 : 제임스 밀러

-
- 역자 : 최준규, 강형건

★ 지은이의 말 ★
빅데이터를 효율적이고 효과적으로 시각화하는 데 필요한 개념을 이해하고 모델을 설정하는 것은 까다롭지만 얻지 못하는 것은 아니다. 안타깝게도 기본 기능을 갖춘 많은 데이터 시각화 도구는 빅데이터로 작업할 때 다소 비효율적이다.
기초 분석 개념을 익히고 가장 널리 알려진 오픈소스와 도구를 사용해 도전 과제를 해결하고 더 나은 의사 결정을 지원할 수 있는 빅데이터 시각화 방법을 배워보자.
★ 옮긴이의 말 ★
데이터 시각화(data visualization)는 데이터 분석 결과를 쉽게 이해할 수 있도록 시각적으로 표현하고 전달하는 일련의 과정을 뜻합니다. 그 과정에는 여러 가지 시각화 도구와 언어를 활용하는데 이 책은 데이터 시각화의 기초 지식을 바탕으로 오픈소스인 R, 파이썬, 태블로, 스플렁크 등 다양한 언어와 도구를 다룹니다. 독자 여러분은 이 책에 소개된 내용을 이정표 삼아 각자에게 맞는 시각화 도구를 선택할 수 있을 것입니다.

1장. 빅데이터 시각화 소개
__데이터 시각화의 개념
____데이터 시각화의 전통적 개념
____교육 기회
__빅데이터 시각화의 도전 과제
____빅데이터
____엑셀을 이용한 데이터 측정
____빅데이터를 더 높은 수준으로 확대하기
____3V
____분류
____시각화 철학
__빅데이터 시각화 접근법
____접근, 속도, 저장
____하둡 첫발 딛기
____문맥
____품질
__요약
2장. 하둡을 사용한 접근, 속도, 저장
__하둡에 관하여
____하둡의 대안
____IBM 오픈 플랫폼
__로그 파일과 엑셀
____R 스크립팅 예제
____고려 사항
__하둡과 빅데이터
____하둡 첫발 딛기
____하둡 프로젝트를 위한 AWS
__실행 예제 1
____환경 정의
____시작하기
____데이터 업로드하기
____데이터 조작하기
____결론
__예제 2
____정렬하기
____IP 구문 분석하기
__요약
3장 R을 사용한 데이터의 이해
__정의 및 설명
____비교
____대조
____경향
____산포
__문맥 추가하기
__R에 관하여
____R과 빅데이터
__실행 예제 1
__R로 파고들기
__실행 예제 2
____정의 및 설명
____루핑 사용하지 않기
____비교
____대조
____경향
____산포
__요약
4장. 빅데이터 품질 다루기
__데이터 품질 범주
__데이터 매니저
__데이터 매니저와 빅데이터
__실행 예제 1
____데이터 재구성
__실행 예제 2
____일관성
____신뢰성
____적합성
____접근성
__요약
5장. D3를 사용해 결과 표시하기
__D3란?
__D3와 빅데이터
__몇 가지 기본 예제
____D3 시작하기
____중단 시간
____시각화 전환
____다중 도넛
__더 많은 예제
____막대그래프 시각화의 또 다른 트위스트
____예제 하나 더 보기
__샘플 선택하기
__요약
6장. 빅데이터를 위한 대시보드 - 태블로
__태블로란?
__태블로와 빅데이터
__예제 1 - 판매 트랜잭션
____컨텍스트 추가
____데이터 랭글링
____태블로 대시보드
____통합 문서 저장
____결과물 프리젠테이션하기
____기타 도구들
__예제 2
____목표는 무엇인가? - 비즈니스 목적과 대상
____판매와 지출
____Sales v Spend, Spend as % of Sales Trend
____테이블 및 표시기
____모두 합치기
__요약
7장. 파이썬을 사용해 이상점 다루기
__파이썬이란?
__파이썬과 빅데이터
__이상점
____이상점 옵션들
____이상점 식별하기
__몇 가지 기본 예제
____수익성을 위한 슬롯머신 테스트
__더 많은 예제
____주제별 모집단
____집중의 철학
__요약
8장. 빅데이터 운영 인텔리전스 구축하기 - 스플렁크
__스플렁크란
____스플렁크 및 빅데이터
__스플렁크 시각화 - 실시간 로그 분석
__스플렁크로 모니터링하기
____스플렁크 지정하기
____행과 열 설정하기
____스플렁크 및 오류 처리
__스플렁크 시각화 - 로그를 더 깊이 살펴보기
____새 필드
____대시보드 편집
____대시보드에 대해 더 알아보기
__요약

