









출고예상일 안내
주문하신 상품이 한국에서 현지 배송을 위한 출고단계가 이루어질 것으로 예상되는 날짜입니다. 상품을 준비하는 과정에서 내부적인 사정으로 인해 출고예상일에 다소 오차가 생길 수 있습니다.
여러 상품(예약상품포함)을 함께 주문하신 경우 출고예상일이 가장 늦은 날짜에 맞춰 함께 배송됩니다.


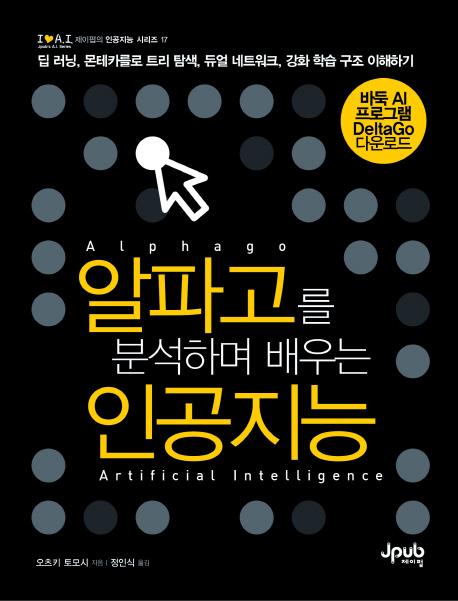
알파고를 분석하며 배우는 인공지능 딥 러닝, 몬테카를로 트리 탐색, 듀얼 네트워크, 강화 학습 구조 이해하기
원제 : 最強囲碁AI アルファ碁 解体新書 増補改訂版








ISBN : 9791188621644 / 332쪽 175 x 220 (㎜)
이 상품에 궁금하신점이 있으세요? 1:1상담문의



아래의 도서와 구매하시면 이 도서들의 적립금을 즉시적용해 드립니다.
-
정지훈
-
-

거트루드(박태현)
-
김영욱
- 25,200
- 20,700
- 23,400
- 23,400



반디앤루니스 리뷰
알파고를 통해 인간의 지혜를 넘어선 한 수의 비밀을 탐구한다!
바둑계의 양대 산맥이던 이세돌과 커제를 이기고 전설이 된 바둑 인공지능 알파고. 이 책은 알파고를 탄생시키고 성장시킨 딥 러닝, 강화 학습, 몬테카를로 트리 탐색에 대해 자세히 다룹니다. 또한, 알파고의 차기 버전인 알파고 제로에 대해서도 알아봅니다. 인간에 의해 개발되고 학습되었지만, 인간의 지능을 능가해 버린 인공지능의 구조와 원리를 탐색함으로써 무궁무진한 인공지능의 발전 방향을 모색합니다.
출판사 리뷰

-
- 저자 : 오츠키 토모시

-
- 역자 : 정인식

머신 러닝이란 컴퓨터에 ‘학습’을 시켜서 어떤 태스크에 대한 컴퓨터의 ‘예측 능력’과 ‘판별 능력’을 향상시켜 나가는 방법이다. 컴퓨터는 모든 국면을 기억할 수 없지만, ‘비슷한 국면에서 유사한 수가 좋은 수가 될 것이다’라는 것을 가정하여 배후에 있는 규칙성을 구하는 것이 목표다.
_22쪽
CNN에서는 필터 가중치가 공유되므로 모든 링크에 독립적인 가중치(파라미터)를 주는 전체 결합 네트워크와 비교하면 학습해야 할 파라미터의 수가 적다. 예를 들어, 만일 3 × 3의 필터가 16개인 경우, 파라미터의 수는 입력 16개, 출력이 16장인 경우(16 × 16 × 3 × 3) 약 2,300개가 되며, 이는 1계층 당 약 8만 개나 되는 전체 결합 네트워크보다 압도적으로 적다.
_51쪽
Q 학습의 경우 처음에는 모든 가치가 0이라는 초깃값부터 시작한다. 또한, 인접하는 칸의 가치를 바탕으로 가치 함수를 갱신하므로 첫 번째 에피소드에서는 보상을 얻을 수 있는 출구의 직전 칸 가치만이 갱신된다. 그것이 에피소드가 진행됨에 따라 시작 측에 가치가 전달되어 가는 과정을 확인할 수 있다. 결국 최단 경로에 해당하는 칸의 가치가 높아진다.
_122쪽
‘CrazyStone’의 개발자 레미 쿨롱에 따르면 몬테카를로 트리 탐색은 단 1줄의 변경으로 굉장히 강해졌다고 언급했다. 그 개선은 플레이 아웃의 결과를 ‘땅 크기의 차이’가 아니라 ‘승리 또는 패배’로 변경한 것이다. ‘승리 또는 패배’보다 ‘땅 크기의 차이’ 쪽이 정보가 많으므로 언뜻 보면 더 나은 평가가 가능해 보인다. 정보를 적게 하는 편이 좀 더 잘된다는 점은 의외로 느껴진다.
_186쪽
게임 AI에 강화 학습을 적용할 때의 장점은 지도 학습의 경우 필수가 되는 훈련 데이터가 필요 없다는 점을 들 수 있다. 따라서 원래 플레이 데이터를 얻기 어려운 게임이나 이미 강해져 교사 데이터를 만들기 어려운 AI에 대해서는 효과적인 기술이다. 한편, 강화 학습을 적용하는 다른 장점으로, 아무런 지식도 없는 상태에서 사람과 비슷한 지식수준이나 지금까지 알려지지 않았던 새로운 지식을 획득할 수 있다는 점을 들 수 있다.
_248쪽

CHAPTER 1 알파고의 등장 1
1.1 게임 AI의 역사와 발전 2
1.1.1 앨런 튜링과 AI 2
1.2 천재 데미스 하사비스의 등장 5
1.2.1 신동 데미스 하사비스 5
1.3 알파고의 활약 7
1.3.1 알파고의 활약 7
1.4 바둑 AI의 기초 13
1.4.1 바둑의 규칙 13
1.4.2 바둑 AI를 구현한다는 것은 무엇인가? 16
1.4.3 ‘다음의 한 수’ 태스크 20
1.4.4 ‘다음의 한 수’ 태스크의 어려운 점 21
1.4.5 머신 러닝을 이용한 ‘다음의 한 수’ 태스크 22
1.4.6 알파고의 롤 아웃 정책 학습 26
1.5 정리 30
CHAPTER 2 딥 러닝 - 바둑 AI는 순간적으로 수를 떠올린다 31
이 장에서 설명할 내용 32
2.1 딥 러닝이란? 34
2.1.1 AI는 사람의 직관을 실현할 수 있을까? 34
2.2 필기체 숫자 인식의 예 42
2.2.1 필기체 숫자 인식이란? 42
2.2.2 필기체 숫자 인식의 데이터 세트 ‘MNIST’ 42
2.2.3 신경망을 사용한 필기체 숫자 인식 44
2.2.4 필기체 숫자 인식에 대한 컨볼루션 신경망 47
2.2.5 다단계의 신경망에서도 유효한 활성화 함수 51
2.2.6 오류 역전파 방법에 기초한 CNN의 필터 가중치 학습 54
2.2.7 화상 처리 CNN의 발전 60
2.3 알파고의 컨볼루션 신경망 64
2.3.1 알파고의 컨볼루션 신경망 64
2.3.2 ‘다음의 한 수’ 태스크와 화상 인식의 유사성 65
2.3.3 바둑의 수를 선택하는 CNN - SL 정책 네트워크 66
2.3.4 SL 정책 네트워크의 입력 48채널의 특징 71
2.3.5 SL 정책 네트워크의 컨볼루션 계산 예 75
2.3.6 SL 정책 네트워크의 계산량 77
2.3.7 SL 정책 네트워크의 학습용 데이터 획득 81
2.3.8 SL 정책 네트워크의 학습 기법 84
2.3.9 SL 정책 네트워크의 학습 결과 87
2.3.10 국면의 유리 불리를 예측하는 CNN(밸류 네트워크) 90
2.4 Chainer로 CNN 학습시키기 93
2.4.1 MNIST의 신경망 학습 부분 작성하기 93
2.4.2 SL 정책 네트워크의 학습 부분 작성하기 96
2.5 정리 100
CHAPTER 3 강화 학습 - 바둑 AI는 경험을 배운다 101
이 장에서 설명할 내용 102
3.1 강화 학습이란? 104
3.1.1 어떻게 경험에서 배울 것인가? 104
3.2 강화 학습의 역사 108
3.2.1 강화 학습 108
3.3 멀티 암드 밴딧 문제 112
3.3.1 강화 학습의 사례 112
3.3.2 UCB1 알고리즘 116
3.4 미로를 풀기 위한 강화 학습 118
3.4.1 4 × 4칸으로 이루어진 미로 118
3.4.2 가치 기반의 방식: Q 학습을 통해 미로 해결 120
3.4.3 정책 기반 방식: 정책 경사법을 통해 미로 해결 124
3.5 비디오 게임 조작 스킬을 얻기 위한 강화 학습 127
3.5.1 DQN 127
3.6 알파고의 강화 학습 131
3.6.1 알파고의 강화 학습 131
3.6.2 정책 경사법에 근거하는 강화 학습 134
3.6.3 RL 정책 네트워크의 성능 137
3.6.4 밸류 네트워크 학습용의 데이터 작성 기법 138
3.7 정리와 과제 143
CHAPTER 4 탐색 - 바둑 AI는 어떻게 예측할까? 145
이 장에서 설명할 내용 146
4.1 2인 제로섬 유한 확정 완전 정보 게임 148
4.1.1 어떻게 수를 예측할까? 148
4.2 게임에서의 탐색 153
4.2.1 SL 정책 네트워크 153
4.3 기존의 게임 트리 탐색(민맥스 트리 탐색) 155
4.3.1 ‘완전 탐색’의 개념 155
4.3.2 탐색 포인트 ? 가지치기와 평가 함수 162
4.4 바둑에서의 몬테카를로 트리 탐색 165
4.4.1 몬테카를로 방법 165
4.4.2 바둑에서의 몬테카를로 방법: 원시 몬테카를로 166
4.4.3 몬테카를로 트리 탐색 170
4.4.4 몬테카를로 트리 탐색의 결과와 최종적인 수 탐색 179
4.4.5 몬테카를로 트리 탐색의 개선 182
4.5 몬테카를로 트리 탐색의 성공 요인과 과제 185
4.5.1 CrazyStone과 Gnu Go 185
4.5.2 단 1줄로 다시 태어난 CrazyStone 186
4.6 정리 188
4.6.1 탐색 188
CHAPTER 5 알파고의 완성 189
5.1 알파고의 설계도 190
5.1.1 알파고의 재료 190
5.1.2 전체를 제어하는 AI 192
5.2 비동기 정책 가치 갱신 몬테카를로 트리 탐색 195
5.2.1 세 가지 정책의 특징 195
5.2.2 비동기 정책 가치 갱신 몬테카를로 트리 탐색 197
5.2.3 APV-MCTS의 선택 처리 200
5.2.4 APV-MCTS의 전개 처리 201
5.2.5 APV-MCTS의 평가 처리 201
5.2.6 APV-MCTS의 갱신 처리 202
5.3 대량 CPU·GPU의 이용 204
5.3.1 대량의 CPU와 GPU에 의한 병렬 탐색 204
5.3.2 로크리스 해시 206
5.3.3 가상 손실 208
5.4 알파고의 강력함 211
5.4.1 몬테카를로 트리 탐색, 밸류 네트워크, 정책 네트워크의 조합 효과 211
CHAPTER 6 알파고에서 알파고 제로로 213
6.1 시작에 앞서 214
6.2 알파고 제로에서의 딥 러닝 216
6.2.1 듀얼 네트워크의 구조 218
6.2.2 듀얼 네트워크의 학습 224
6.2.3 알파고 제로의 딥 러닝 정리 227
6.3 알파고 제로에서의 몬테카를로 트리 탐색 228
6.3.1 알파고 제로의 몬테카를로 트리 탐색 개요 228
6.3.2 몬테카를로 트리 탐색의 플로 차트 230
6.3.3 알파고 제로의 몬테카를로 트리 탐색 정리 233
6.4 알파고 제로에서의 강화 학습 234
6.4.1 알파고 제로의 강화 학습 기법 236
6.4.2 강화 학습의 계산 시간 242
6.4.3 알파고 제로의 강화 학습은 무엇을 하고 있나? 245
6.4.4 강화 학습의 효과 247
6.4.5 알파고 제로의 강화 학습 정리와 그 후의 진전 248
6.5 알파고 제로의 강력함 251
6.6 알파고 제로는 지식 없이 만들 수 있을까? 253
6.7 알파고나 알파고 제로에 약점은 있을까? 255
6.7.1 알파고와 알파고 제로의 약점 가능성 255
6.8 알파고 제로의 향후 미래 257
6.8.1 바둑계의 미래는 어떻게 될까? 257
6.8.2 AI의 과제 258
Appendix 1 수식에 관하여 263
A1.1 콘볼루션 신경망의 학습 법칙 도출 264
A1.1.1 SL 정책 네트워크의 학습 법칙 도출 264
A1.1.2 밸류 네트워크의 학습 법칙 도출 265
A1.1.3 듀얼 네트워크의 손실 함수에 관한 보충 267
A1.2 강화 학습의 학습 법칙 도출 269
A1.2.1 파알고의 RL 정책 네트워크 강화 학습 방법의 학습 법칙 도출 269
A1.2.2 미로를 예로 든 정책 경사법의 학습 법칙 도출 271
Appendix 2 바둑 프로그램용 UI 소프트웨어 GoGui 및 GoGui용 프로그램 DeltaGo 이용 방법 273
A2.1 DeltaGo란? 274
A2.1.1 DeltaGo의 특징 274
A2.2 GoGui의 설치 및 GoGui용 프로그램 DeltaGo 이용 방법 276
A2.2.1 DeltaGo 다운로드와 압축 풀기 276
찾아보기 289

