









출고예상일 안내
주문하신 상품이 한국에서 현지 배송을 위한 출고단계가 이루어질 것으로 예상되는 날짜입니다. 상품을 준비하는 과정에서 내부적인 사정으로 인해 출고예상일에 다소 오차가 생길 수 있습니다.
여러 상품(예약상품포함)을 함께 주문하신 경우 출고예상일이 가장 늦은 날짜에 맞춰 함께 배송됩니다.


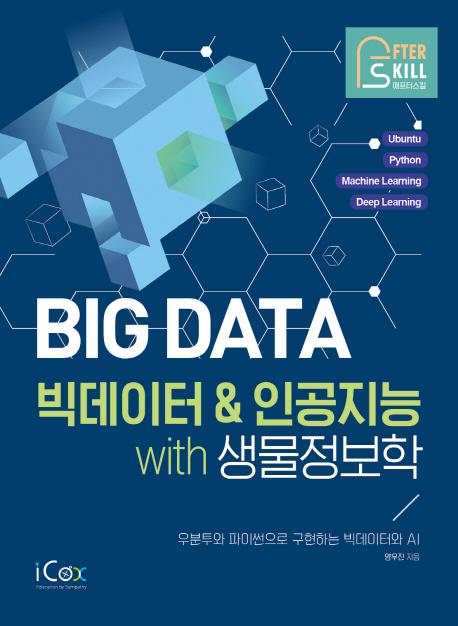





ISBN : 9791164260560 / 200쪽 188 x 257 (㎜)
이 상품에 궁금하신점이 있으세요? 1:1상담문의



아래의 도서와 구매하시면 이 도서들의 적립금을 즉시적용해 드립니다.
-

코리아교육그룹 교육연구소
-
오유나 외 14인
-
-

클리커, 이희영, 강민혁
- 19,800
- 22,500
- 20,700
- 22,500



출판사 리뷰


-
- 저자 : 양우진


머리말
도서 가이드
참고 사이트 목록
목차
CHAPTER .1 생물정보학의 데이터
1.1 생물정보학과 빅데이터
01 생물정보학
02 빅데이터
1.2 개발 환경은 어떻게 마련하나?
01 리눅스에서 시작하자
02 사용자 등록과 권한
03 여러 종류의 셸(shell)
\t04 셸의 명령어
05 파일 편집기
06 Python과 R, 무엇을 쓸 것인가?
07 파이썬으로 개발 환경 만들기
1.3 빅데이터는 어디서 구하나?
01 웹에서 내려받기
02 스크립트로 데이터 긁어 오기
03 HTTP로 요청하기
04 SQL로 다운받기
CHAPTER .2 데이터 다루기
2.1 빅데이터는 어떻게 저장할까?
01 리스트(List), 튜플(Tuple), 딕셔너리(Dictionary)
\t02 가장 빠른 검색 방법, 딕셔너리
03 너무 큰 데이터를 다루어야 한다면? 분할 정복
04 데이터 전처리
2.2 데이터 처리를 위한 방법
01 여러 데이터 형식
02 셸 스크립트
03 pandas와 NumPy
\t04 NumPy로 데이터 다루기
2.3 통계적 유의성을 검증하자
01 통계적 유의성
02 확률 변수와 분포
03 빈도가 얼마나 다른가? 카이제곱 검증
04 확률 밀도와 정규 분포
05 분포가 얼마나 다른가? t-검증
CHAPTER .3 인공 지능
3.1 머신 러닝 (Machine Learning)
\t01 분류와 회귀
02 SVM (Support Vector Machine)
\t03 결정 트리와 랜덤 포레스트
04 베이즈 분류와 인과 네트워크
3.2 교차 검증 (Cross Validation)
\t01 데이터셋 나누기
02 분류기의 성능 평가 척도
03 좋은 분류기 선택
04 빠지기 쉬운 함정
05 모델의 성능을 측정하는 다른 것들
3.3 딥 러닝 (Deep Learning)
\t01 인공 신경망 (Artificial Neural Network)
\t02 딥 러닝을 위한 프레임워크
03 CNN (Convolution Neural Network)
\t04 Autoencoder
\t05 RNN (Recurrent Neural Network)
\t06 여러 가지 Optimizer의 최적화
▷ 찾아보기

