









출고예상일 안내
주문하신 상품이 한국에서 현지 배송을 위한 출고단계가 이루어질 것으로 예상되는 날짜입니다. 상품을 준비하는 과정에서 내부적인 사정으로 인해 출고예상일에 다소 오차가 생길 수 있습니다.
여러 상품(예약상품포함)을 함께 주문하신 경우 출고예상일이 가장 늦은 날짜에 맞춰 함께 배송됩니다.




- 정가
- $40.00
- 판매가
-
$32.40
(19%↓)

- 적립금
- $0.65 (2%P)
- 출고예상일
- 2026년 10월 08일




평점 - · 리뷰 0

가능매장 : 롯데스타시티점, 목동점


ISBN : 9791188621552 / 232쪽 188 x 245 (㎜)
이 상품에 궁금하신점이 있으세요? 1:1상담문의



아래의 도서와 구매하시면 이 도서들의 적립금을 즉시적용해 드립니다.
-
엥지유니버스
-
박현규, 김성경
-
김현철, 신은경, 이민정, 박선우, 정기민, 곽소아, 정문수
-

클리커, 이희영, 강민혁
- 27,000
- 21,600
- 21,420
- 22,500

- 컴퓨터/IT > 프로그래밍 > 기타 프로그래밍 언어


출판사 리뷰
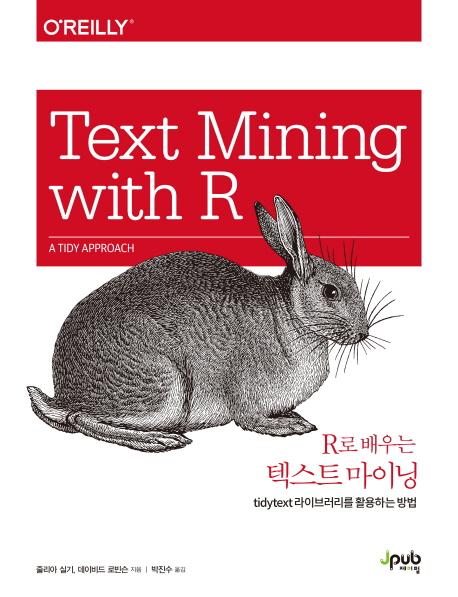
이 책의 주요 내용 ■ tidytext 형식을 NLP에 적용하는 방법을 학습한다. ■ 정서 분석 기법으로 텍스트에 담긴 감성적 내용을 학습한다. ■ 빈도를 측정해 문서 내에서 가장 중요한 용어들을 식별한다. ■ ggraph 패키지와 widyr 패키지를 사용해 단어 사이의 관계와 연결을 찾아낸다. ■ 정돈된(깔끔한) 텍스트 형식과 정돈되지 않은 텍스트 형식을 서로 바꿔본다. ■ 토픽 모델링으로 문서 모음집을 자연스럽게 분류한다. ■ 트위터 아카이브를 비교하거나, 미항공우주국(NASA)이 제공하는 메타데이터를 파 보거나, 수천 개나 되는 유즈넷 메시지를 분석해 보는 식으로 사례 연구를 진행한다.

-
- 저자 : 줄리아 실기, 데이비드 로빈슨

-
- 역자 : 박진수

 제인 오스틴(Jane Austen)이 탈고해 출판한 소설 여섯 개를 janeaustenr 패키지에서 가져온 다음 정돈 형식으로 변형해 보자. janeaustenr 패키지는 텍스트를 1줄당 1행(one-row-per-line) 형식으로 제공하는데, 이 맥락에서 의미하는 줄(line)이란 실제 도서의 원문에 맞춰 인쇄된 한 줄을 말한다. 이것을 사용해 정돈 작업에 착수하되 mutate()를 사용해 linenumber 수에 해당하는 만큼을 주석으로 처리함으로써 원래 줄 형식을 추적하는 데 사용하고, chapter(regex 사용)를 사용해 모든 장이 어디부터 나오는지를 알아낸다.
_6쪽
이제 janeaustenr 패키지를 사용해 정돈 텍스트를 탐색해 보았으므로, 이번에는 gutenbergr 패키지를 소개하겠다. gutenbergr 패키지는 구텐베르크 프로젝트(Project Gutenberg) 모음집 중 공공 저작물(public domain works)에 해당하는 텍스트에 접근할 수 있게 한다. 이 패키지에는 도서를 내려받기 위한 도구(도움이 되지 않는 머리글/바닥글 정보는 제거)와 관심 있는 작품을 찾는 데 사용할 수 있는 구텐베르크 프로젝트 메타데이터의 전체 데이터셋이 포함되어 있다. 이 책에서는 구텐베르크 프로젝트에서 ID별로 하나 이상의 작품을 다운로드하는 gutenberg_download() 함수를 주로 사용하지만, 다른 함수를 사용해 메타데이터를 탐색하고 제목, 작성자, 언어 등과 짝을 이루는 구텐베르크 ID를 탐색할 수 있을 뿐만 아니라 저자에 대한 정보도 수집할 수 있다.
_10쪽
유용한 작품을 단어 수준(word level)에서 토큰화할 수 있지만 때로는 다른 단위에 맞춰 텍스트를 살펴보는 편이 더 유용하기도 하고 필요하기도 하다. 예를 들어 전체 문장의 정서를 이해할 수 있게 하기 위해 일부 정서분석 알고리즘은 유니그램(즉, 단일 단어)을 넘어서려고 한다. 이러한 알고리즘들은 ‘I am not having a good day(일진이 안 좋아)’라는 말이 기쁨을 나타내는 문장이 아닌 슬픔을 나타내는 문장이라는 점을 이해하려고 시도한다. coreNLP, cleanNLP 및 sentimentr을 포함한 여러 R 패키지들은 그러한 정서분석 알고리즘의 예다. 이런 패키지들을 사용해서 단어 단위가 아닌 문장 단위로 정서를 분석하려면 우리는 텍스트를 문장 단위로 토큰화해야 하는데, 그런 경우에는 출력 열에 새 이름을 사용하는 게 적절하다.
_32쪽
이번 장에서는 정돈 텍스트 접근법이 개별 단어를 분석하는 데 유용할 뿐만 아니라 단어 간의 관계 및 연결을 탐색하는 데도 유용하다는 것을 보여 줬다. 이러한 관계에는 엔그램이 포함될 수 있으며, 이는 어떤 단어가 다른 단어 뒤에 나타나는 경향이 있는지와, 서로 인접한 곳에 출현하는 단어 간의 동시 발생(co-occurrences), 즉 상관(correlations)을 볼 수 있게 해 준다. 이번 장에서는 이러한 두 종류의 관계를 연결망으로 시각화하기 위한 ggraph 패키지도 소개했다. 이러한 연결망 시각화는 관계를 탐구하는 데 쓰기에 유연한 도구이며, 이후 장들에 나오는 사례 연구에서 중요한 역할을 수행한다.
_81쪽
일련의 문서를 특징짓는 단어 군집을 찾기 위한 토픽 모델링을 소개하고, tidy() 동사가 dplyr 및 ggplot2를 사용해 이러한 모델을 탐색하고 이해하는 방법을 보여 줬다. 이는 모델 탐색에 대한 정돈된 접근법의 장점 중 하나다. 다양한 출력 형식의 문제를 정돈 함수들이 처리하고, 표준 도구 모음을 사용해 모델 결과를 탐색할 수 있다는 장점 말이다. 우리는 특히 토픽 모델링을 통해 네 개의 개별 도서와 장을 구분하고 구별할 수 있다는 점을 보았고, 잘못 지정된 단어와 장을 찾아보면서 모델의 한계점을 탐구했다.
_127쪽

목차
CHAPTER 1 정돈 텍스트(깔끔한 텍스트) 형식 1
정돈 텍스트와 다른 데이터 구조 비교하기 2
unnest_tokens 함수 3
제인 오스틴의 작품 정돈하기 6
gutenbergr 패키지 10
단어 빈도 10
요약 16
CHAPTER 2 정돈 데이터를 사용한 정서분석 17
정서 데이터셋 18
내부 조인을 사용한 정서분석 21
세 가지 정서 사전 비교 25
가장 흔한 긍정 단어와 부정 단어 28
워드 클라우드 30
단순한 단어 이상인 단위 보기 32
요약 35
CHAPTER 3 단어와 문서의 빈도 분석: tf-idf 37
제인 오스틴의 소설 속 용어빈도 38
지프의 법칙 40
bind_tf_idf 함수 44
물리학 텍스트의 말뭉치 47
요약 53
CHAPTER 4 단어 간 관계: 엔그램과 상관 55
엔그램에 의한 토큰화 56
엔그램 개수 세기와 선별하기 57
바이그램 분석 59
정서분석 시 바이그램을 사용해 문맥 제공하기 62
ggraph를 사용해 바이그램 연결망 시각화화기 65
그 밖의 텍스트에 들어 있는 바이그램 시각화하기 71
widyr 패키지와 단어 쌍 세기 및 상관 73
각 단원 간의 개수 세기 및 상관 74
쌍 단위 상관 검사 76
요약 81
CHAPTER 5 비정돈 형식 간에 변환하기 83
문서-용어 행렬 정돈하기 84
DocumentTermMatrix 객체 정돈하기 85
dfm 객체 정돈하기 89
정돈 텍스트 데이터를 행렬에 캐스팅하기 92
Corpus 객체를 메타데이터로 정돈하기 94
사례 연구: 금융 관련 기사 마이닝 97
요약 104
CHAPTER 6 토픽 모델링 105
잠재 디리클레 할당 106
단어-토픽 확률 108
문서-토픽 확률 111
예제: 대도서관 강도 113
각 장의 LDA 115
문서당 분류 118
단어별 할당: augment 121
대체 LDA 구현 125
요약 127
CHAPTER 7 사례 연구: 트위터 아카이브 비교 129
데이터 및 트위터 분포 얻기 129
단어 빈도 131
단어 용도 비교 135
단어 사용 변화 137
즐겨찾기 및 리트윗 143
요약 148
CHAPTER 8 사례 연구: NASA 메타데이터 마이닝 149
NASA가 데이터를 조직하는 방식 150
데이터 랭글링과 정돈 151
일부 초기 단순 탐사 154
단어 동시 발생과 상관 156
설명 및 제목 단어 연결망 156
중요어 연결망 159
설명 필드에 대한 tf-idf 계산 163
설명 필드 단어의 tf-idf는 무엇인가? 163
설명 필드를 중요어에 연결하기 164
토픽 모델링 166
문서-용어 행렬에 캐스팅하기 166
토픽 모델링 준비 167
토픽 모델 해석 168
토픽 모델링을 중요어와 연결하기 175
요약 178
CHAPTER 9 사례 연구: 유즈넷 텍스트 분석 179
전처리 179
텍스트 전처리 181
뉴스그룹의 단어들 183
뉴스그룹 내에서 tf-idf 찾기 184
토픽 모델링 187
정서분석 190
단어별 정서분석 191
메시지별 정서분석 194
엔그램 분석 197
요약 199
참고문헌\t201
찾아보기\t203

