









출고예상일 안내
주문하신 상품이 한국에서 현지 배송을 위한 출고단계가 이루어질 것으로 예상되는 날짜입니다. 상품을 준비하는 과정에서 내부적인 사정으로 인해 출고예상일에 다소 오차가 생길 수 있습니다.
여러 상품(예약상품포함)을 함께 주문하신 경우 출고예상일이 가장 늦은 날짜에 맞춰 함께 배송됩니다.


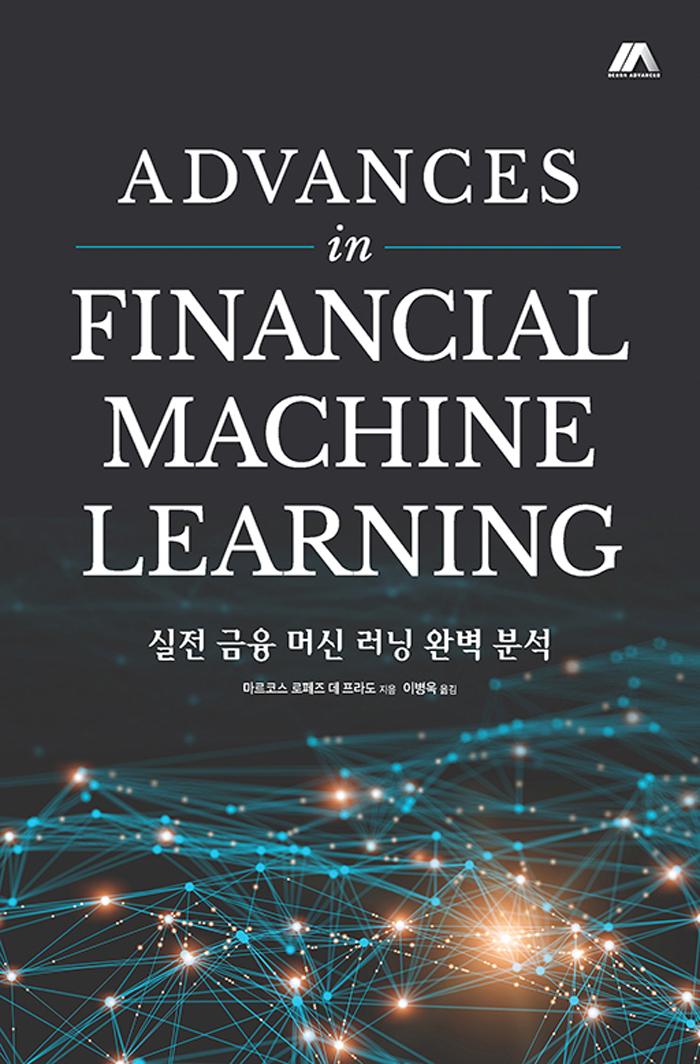
실전 금융 머신러닝 완벽 분석 금융 퀀트 머신러닝 융합
원제 : Advances in Financial Machine Learning
마르코스 로페즈 데 프라도 저 | 이병욱, 이기홍, 하석근 역 | 에이콘출판 | 2019년 01월





ISBN : 9791161752334 / 504쪽 150 x 228 (㎜)
이 상품에 궁금하신점이 있으세요? 1:1상담문의



아래의 도서와 구매하시면 이 도서들의 적립금을 즉시적용해 드립니다.
-
조지 C. 셀든
-

클리커, 이희영, 강민혁
-
박소령
-
자본주의학교
- 16,200
- 22,500
- 18,000
- 17,100



반디앤루니스 리뷰
머신러닝을 금융에 적용하는 방법을 알려주며, 이론 연구를 넘어선 실전 경험을 바탕으로 어떠한 장점과 위험이 존재하는 것인지 빠짐없이 설명한다. 저자가 20년 간 금융에서 실제로 적용해 본 머신러닝 기법에 대해 각각의 장단점과 함께 개별 기법들을 상세히 설명한다. 또 금융에 맞는 데이터 구조, 모델링, 백테스팅, 유용한 금융적 특징, 고성능 컴퓨팅에 이르기까지 최고 전문가의 시각에서 전달해 주는 실전 지식을 빠짐없이 나열한다.
대부분의 금융 머신러닝 프로젝트가 실패하는 이유와 성공적인 금융 머신러닝 프로젝트를 위해서 어떠한 요소가 갖춰져야 하는지 설명하고 있다. 특히 대부분 프로젝트가 저지르는 백테스팅의 오류를 심도 있게 설명한다.
메타-전략 패러다임의 효용성과 중요성을 설명해 주며, 대부분 성공한 프로젝트가 활용하고 있는 메타-전략 패러다임을 예제와 함께 잘 설명한다. 이 책은 그 깊이로 인해 머신러닝과 금융에 대한 최소한의 지식을 갖춰야 이해할 수 있지만, 최소한의 지식이 바탕이 되고 나면 책에서 다루고 있는 깊이 있고 실용적인 내용으로부터 많은 도움을 받을 수 있다
출판사 리뷰
이 책은 머신 러닝을 금융에 적용하는 것이 어떤 것이며, 어떠한 장점과 위험이 존재하는 것인지 빠짐없이 설명한다.
저자가 20년 간 금융에서 실제로 적용해 본 머신 러닝 기법에 대해 각각의 장단점과 함께 개별 기법들을 상세히 설명한다. 또 금융에 맞는 데이터 구조, 모델링, 백테스팅, 유용한 금융적 특징, 고성능 컴퓨팅에 이르기까지 최고 전문가의 시각에서 전달해 주는 실전 지식을 빠짐없이 나열한다.
대부분의 금융 머신 러닝 프로젝트가 실패하는 이유와 성공적인 금융 머신 러닝 프로젝트를 위해서는 어떠한 요소가 갖춰져야 하는지 설명하고 있다. 특히 대부분 프로젝트가 저지르는 백테스팅의 오류를 심도 있게 설명한다.
메타-전략 패러다임의 효용성과 중요성을 설명해 주며, 대부분 성공한 프로젝트가 활용하고 있는 메타-전략 패러다임을 예제와 함께 잘 설명한다. 이 책은 그 깊이로 인해 머신 러닝과 금융에 대한 최소한의 지식을 갖춰야 이해할 수 있지만, 최소한의 지식이 바탕이 되고 나면 책에서 다루고 있는 깊이 있고 실용적인 내용으로부터 많은 도움을 받을 수 있다.
★ 이 책의 대상 독자 ★
특히 금융 관련 데이터에 연계된 문제들을 해결하기 위해 설계된 고급 머신 러닝 기법에 대해 다루고 있다. '고급'이라는 의미가 이해하기가 극도로 힘들다거나 딥러닝, 순환 신경망, 컨볼루션망 등 최근에 되살아나고 있는 기법들을 설명한다는 의미는 아니다. 그보다는 금융 문제에 머신 러닝 알고리즘을 적용한 경험이 있는 상급 연구원들이 주요하게 생각하는 여러 의문에 해답을 주기 위해 쓰여졌다. 만약 머신 러닝이 처음이고, 복잡한 알고리즘에 대한 경험이 없다면 이 책이 적합하지 않을 수 있다. 이 책에서 다루고 있는 문제에 대해 현업에서의 경험이 없다면 이 책을 이용해 문제 해결하는 것이 쉽지 않을 것이다. 이 책을 읽기 전에 머신 러닝에 대한 여러 훌륭한 책을 읽길 권한다.
이 책은 금융 이외의 여러 분야에 머신 러닝 알고리즘을 성공적으로 구현한 경험이 있는 데이터 과학자들에게도 적합하다. 만약 여러분이 구글에서 일하면서 딥신경망을 얼굴 인식에 대해 성공적으로 구현한 적이 있지만, 금융 쪽으로는 제대로 구현해본 적이 없다면 이 책이 많은 도움이 될 것이다.
★ 이 책의 구성 ★
이 책은 서로 얽혀 있는 주제들을 각각 구분해 정돈된 형태로 설명한다. 각 장은 그 이전 장을 읽었다고 가정하고 설명한다. 1부는 금융 데이터를 머신 러닝 알고리즘에서 잘 다룰 수 있도록 구성할 수 있게 도와준다. 2부는 해당 데이터에 대해 어떤 식으로 연구할지에 대해 알아본다. 여기서 중요한 것은 연구를 하거나 과학적 프로세스를 통해 실질적인 발견을 하는 것이며, 이는 우연히 어떤 (잘못될 가능성이 많은) 결과가 나타날 때까지 의미 없이 반복하는 연구 기법과는 구분된다. 3부는 연구에 대한 백테스트 방법에 대해 설명하고 결과가 잘못될 확률을 평가해본다. 이 세 가지를 통해 데이터 분석으로부터 모델을 연구하고, 결과를 평가하는 전체 프로세스를 개괄할 수 있게 된다. 이러한 지식을 바탕으로 4부는 데이터로 되돌아가 의미 있는 특징을 추출하는 혁신적인 방법을 설명한다. 마지막으로 이러한 작업들은 대부분 상당한 양의 자원을 소모하게 되므로 5부에서는 유용한 HPC 비법에 대해 알아본다.

-
- 저자 : 마르코스 로페즈 데 프라도

-
- 역자 : 이병욱, 이기홍, 하석근

★ 지은이의 말 ★
독자들이 머신러닝을 금융에 적용할 때 백테스트 과적합(backtest overfitting Financial)과 같은 난관을 어떻게 해결할 것인지 학습하길 바란다. 금융 머신러닝은 표준 머신러닝과 연계돼 있기는 하지만, 그 자체로 엄연히 분리된 하나의 영역이다. 이 책은 이런 점을 잘 설명해 줄 것이다.
★ 옮긴이의 말 ★
이 책은 금융에 있어서의 머신러닝을 심도 있게 설명해 준다. 특히 통계적 요행에 빠지기 쉬운 금융에서 ‘과거 데이터에 의존했을 때의 위험’을 알려 준다. 저자는 20년간 금융에 종사하면서 자신이 작업해 왔던 머신러닝 기법 중 과학적으로 증명된 것을 자세히 설명하고 있다. 금융과 관련된 머신러닝 책이 시중에 많이 나와 있지만, 실전을 바탕으로 저술한 책은 극히 드물다. 20여 년간 본인이 직접 체득한 실제 지식을 바탕으로 집필됐다는 점에서 다른 책보다 실용적이며, 사실에 가까운 지식을 전달해 준다. 이 책을 통해 머신러닝을 금융에 적용할 때 어떤 어려움과 함정이 존재하는지, 백테스트로 인한 과적합이 얼마나 위험한지 등을 이해하게 될 것이다.

1장. 독립된 주제로서의 금융 머신 러닝
__1.1 동기
__1.2 금융 머신 러닝 프로젝트가 실패하는 주요 원인
____1.2.1 시지프스 패러다임
____1.2.2 메타 전략 패러다임
__1.3 책의 구조
____1.3.1 생산 체인에 의한 구조
____1.3.2 전략 구성 요소에 따른 구조
____1.3.3 흔한 함정에 의한 구성
__1.4 대상 독자들
__1.5 필요 지식
__1.6 FAQs
__1.7 감사의 글
__연습문제
__참고자료
__참고문헌
1부. 데이터 분석
2장. 금융 데이터 구조
__2.1 동기
__2.2 금융 데이터의 근본적 형태
____2.2.1 기초 데이터
____2.2.2 시장 데이터
____2.2.3 분석
____2.2.4 대체 데이터
__2.3 바
____2.3.1 표준 바
____2.3.2 정보-주도 바
__2.4 복수 상품 계열 다루기
____2.4.1 ETF 트릭
____2.4.2 PCA 가중치
____2.4.3 단일 선물 롤
__2.5 특징 표본 추출
____2.5.1 축소를 위한 표본 추출
____2.5.2 이벤트 기반의 표본 추출
__연습문제
__참고자료
3장. 레이블링
__3.1 동기
__3.2 고정 시간 수평 기법 T
__3.3 동적 임계치 계산
__3.4 트리플-배리어 기법
__3.5 위치와 크기 파악
__3.6 메타-레이블
__3.7 메타-레이블을 이용하는 방법
__3.8 퀀터멘털 방법
__3.9 불필요한 레이블 제거
__연습문제
__참고 문헌
4장. 표본 가중치
__4.1 동기
__4.2 결과 중첩
__4.3 공존 레이블의 개수
__4.4 레이블의 평균 고유성
__4.5 배깅 분류기와 고유성
____4.5.1 순차적 부트스트랩
____4.5.2 순차적 부트스트랩의 구현
____4.5.3 수치적 예제
____4.5.4 몬테 카를로 실험
__4.6 수익률 기여도
__4.7 시간-감쇄
__4.8 부류 가중치
__연습문제
__참고 문서
__참고 문헌
5장. 분수 미분의 특징
__5.1 동기
__5.2 정상성 대 기억 딜레마
__5.3 문헌 리뷰
__5.4 기법
____5.4.1 장기 기억
____5.4.2 반복적 계산
____5.4.3 수렴
__5.5 구현
____5.5.1 확장하는 윈도우
____5.5.2 고정-너비 윈도우 Fracdiff
__5.6 최대 기억 유지 정상성
__5.7 결론
__연습문제
__참고 문서
__참고 문헌
2부. 모델링
6장. 앙상블 기법
__6.1 동기
__6.2 오류의 세 가지 원인6.3 부트스트랩 종합
____6.3.1 분산 축소
____6.3.2 개선된 정확도
____6.3.3 관측 중복
__6.4 랜덤 포레스트
__6.5 부스팅
__6.6 금융에 있어서의 배깅 대 부스팅
__6.7 배깅의 확장성
__연습문제
__참고 자료
__참고 문헌
7장. 금융에서의 교차-검증
__7.1 동기
__7.2 교차-검증의 목표
__7.3 금융에서 K-폴드 CV가 실패하는 이유
__7.4 해법: 퍼지된 K-폴드 CV
____7.4.1 훈련 집합에서의 퍼지
____7.4.2 엠바고
____7.4.3 퍼지된 K-폴더 클래스
__7.5 SKLEARN의 교차-검증 버그
__연습문제
__참고 문헌
8장. 특징 중요도
__8.1 동기
__8.2 특징 중요도의 중요성
__8.3 대체 효과와 특징 중요도
____8.3.1 평균 감소 불순도
____8.3.2 평균 감소 정확도
__8.4 대체 효과가 없는 특징 중요도
____8.4.1 단일 특징 중요도
____8.4.2 직교 특징
__8.5 병렬화 대 스택화 특징 중요도
__8.6 합성 데이터를 사용한 실험
__연습문제
__참고 문서
9장. 교차-검증을 통한 초매개변수 설정
__9.1 동기
__9.2 그리드 검색 교차-검증
__9.3 랜덤화 검색 교차-검증
____9.3.1 로그-유니폼 분포9.4 점수화 및 초매개변수 튜닝
__연습문제
__참고 문서
__참고 문헌
3부. 백테스팅
10장. 베팅 크기
__10.1 동기
__10.2 전략-독립 베팅 크기 방식
__10.3 예측된 확률로부터 베팅 크기 조절
__10.4 활성화 베팅의 평균화
__10.5 크기 이산화
__10.6 동적 베팅 크기와 한계 가격
__연습문제
__참고 문서
__참고 문헌
11장. 백테스팅의 위험
__11.1 동기
__11.2 미션 임파서블: 결함 없는 백테스트
__11.3 비록 백테스트 결과가 나무랄 데가 없어도 아마도 잘못 됐을 것이다
__11.4 백테스트는 연구 도구가 아니다
__11.5 몇 가지 일반적인 추천
__11.6 전략 선택
__연습문제
__참고 문서
__참고 문헌
12장. 교차-검증을 통한 백테스팅
__12.1 동기
__12.2 워크-포워드 기법
____12.2.1 워크-포워드 기법의 위험
__12.3 교차-검증 기법
__12.4 조합적 퍼지 교차-검증 기법
____12.4.1 조합적 분할
____12.4.2 조합적 퍼지 교차-검증 백테스트 알고리즘
____12.4.3 몇 가지 예제
__12.5 조합적 퍼지 교차-검증이 백테스트 과적합을 해결하는 법
__연습문제
__참고 문서
13장. 합성 데이터에 대한 백테스트
__13.1 동기
__13.2 거래 규칙.
__13.3 문제
__13.4 프레임워크
__13.5 최적 거래 규칙의 수치적 결정
____13.5.1 알고리즘
____13.5.2 구현
__13.6 실험적 결과
____13.6.1 제로 장기 균형의 경우
____13.6.2 양의 장기 균형 경우
____13.6.3 음의 장기 균형 경우
__13.7 결론
__연습문제
__참고 문서
14장. 백테스트 통계량
__14.1 동기
__14.2 백테스트 통계량의 종류
__14.3 일반적인 특성
__14.4 성과
____14.4.1 수익률의 시간-가중치 비율
__14.5 런
____14.5.1 수익률 집중
____14.5.2 드로우 다운과 수면하 시간
____14.5.3 성과 평가를 위한 런 통계량
__14.6 거래 비용 구현
__14.7 효율성
____14.7.1 샤프 지수
____14.7.2 확률적 샤프 지수
____14.7.3 줄어든 샤프 지수
____14.7.4 효율성 통계량
____14.8 분류 점수
__14.9 속성
__연습문제
__참고 문서
__참고 문헌
15장. 전략 리스크 이해
__15.1 동기
__15.2 대칭 투자 회수금
__15.3 비대칭 투자 회수금
__15.4 전략 실패의 확률
____15.4.1 알고리즘
____15.4.2 구현
__연습문제
__참고 문서
16장. 전략 리스크 이해
__16.1 동기
__16.2 컨벡스 포트폴리오 최적화 문제
__16.3 마코위츠의 저주
__16.4 기하로부터 계층적 관계까지
____16.4.1 트리 군집화
____16.4.2 유사-대각화
____16.4.3 재귀적 이분
__16.5 수치 예제
__16.6 외표본 몬테 카를로 시뮬레이션
__16.7 향후 연구 과제
__16.8 결론
부록
__16.A.1 상관관계-기반 척도
__16.A.2 역분산 할당
__16.A.3 수치 예제 재생
__16.A.4 몬테 카를로 실험 재현
__연습문제
__참고 문서
4부 유용한 금융의 특징
17장. 구조적 변화
__17.1 동기
__17.2 구조적 변화 테스트 종류
__17.3 CUSUM 테스트
____17.3.1 재귀적 잔차에 브라운-더빈-에반스 CUSUM 테스트
____17.3.2 레벨에 대한 추-스틴치콤베-화이트 CUSUM 테스트
__17.4 폭발성 테스트
____17.4.1 초-형태 디키-풀러 테스트
____17.4.2 상한 증강 디키-풀러
____17.4.3 서브- 또는 슈퍼-마틴게일 검정
__연습문제
__참고 문서
18장. 엔트로피 특징들
__18.1 동기
__18.2 샤논의 엔트로피
__18.3 플러그인(또는 최대-우도) 예측기
__18.4 렘펠-지프 예측기
__18.5 인코딩 체계
____18.5.1 이진 인코딩
____18.5.2 분위 수 인코딩
____18.5.3 시그마 인코딩
__18.6 가우스 프로세스의 엔트로피
__18.7 엔트로피와 일반화된 평균
__18.8 엔트로피의 몇 가지 금융 응용
____18.8.1 시장 효율성
____18.8.2 최대 엔트로피 새성
____18.8.3 포트폴리오 집중화
____18.8.4 시장 미시 구조
__연습문제
__참고 문서
__참고 문헌
19장. 미시 구조적 특징
__19.1 동기
__19.2 문헌 고찰
____19.3 1세대: 가격 시퀀스
____19.3.1 틱 규칙
____19.3.2 롤 모델
____19.3.3 고-저변동성 예측기
____19.3.4 코윈과 슐츠
__19.4 2세대: 전략적 거래 모델
____19.4.1 카일의 람다
____19.4.2 아미후드의 람다
____19.4.3 하스브룩의 람다
__19.5 제3세대: 순차적 거래 모델
____19.5.1 정보-기반 거래의 확률
____19.5.2 정보-기반 거래의 거래량-동기화 확률
__19.6 미시 구조적 데이터 세트로부터의 추가 특징
____19.6.1 주문 크기의 분포
____19.6.2 취소율, 지정가 주문, 시장가 주문
____19.6.3 시간-가중 평균 가격 실행 알고리즘
____19.6.4 옵션 시장
____19.6.5 부호가 있는 주문 흐름의 계열 상관관계
__19.7 미시 구조적 정보란 무엇인가?
__연습문제
__참고 문서
5부. 고성능 컴퓨팅 비법
20장. 다중 처리와 벡터화
__20.1 동기
__20.2 벡터화 예제
__20.3 단일-스레드 대 다중-스레딩 대 다중 처리
__20.4 원자와 분자
____20.4.1 선형 분할
____20.4.2 이중 루프 분할
__20.5 다중 처리 엔진
____20.5.1 작업 준비
____20.5.2 비동기 호출
____20.5.3 콜백 언래핑
____20.5.4 피클/언피클 객체
____20.5.5 출력 축소
__20.6 다중 처리 예제
__연습문제
__참고 문서
__참고 문헌
21장. 무차별 대입과 양자 컴퓨터
__21.1 동기
__21.2 조합적 최적화
__21.3 목적 함수
__21.4 문제
__21.5 정수 최적화 기법
____21.5.1 비둘기 집 분할
____21.5.2 가능한 정적 해법21.5.3 궤적 평가
__21.6 수치 예제
____21.6.1 랜덤 행렬
____21.6.2 동적 해법
____21.6.3 동적 해법
__연습문제
__참고 문서
22장. 고성능 계산 지능과 예측 기술
__22.1 동기
__22.2 2010년 주가 폭락에 대한 감독 당국의 반응
__22.3 배경
__22.4 HPC 하드웨어
__22.5 HPC 소프트웨어
____22.5.1 MPI
____22.5.2 계층적 데이터 형식 5
____22.5.3 제자리 In Situ 처리
____22.5.4 수렴
__22.6 실제 사례
____22.6.1 초신성 사냥
____22.6.2 융합 플라스마의 덩어리
____22.6.3 일간 전기 사용 최대치
____22.6.4 2010년의 주가 폭락
____22.6.5 정보-기반 투자 측정의 거래량-동기 확률
____22.6.6 유니폼하지 않은 고속 푸리에 변환으로 고빈도 이벤트 발견
__22.7 요약 및 참여 요청
__22.8 감사의 글
__참고 문서

