









출고예상일 안내
주문하신 상품이 한국에서 현지 배송을 위한 출고단계가 이루어질 것으로 예상되는 날짜입니다. 상품을 준비하는 과정에서 내부적인 사정으로 인해 출고예상일에 다소 오차가 생길 수 있습니다.
여러 상품(예약상품포함)을 함께 주문하신 경우 출고예상일이 가장 늦은 날짜에 맞춰 함께 배송됩니다.


심층 학습
원제 : Deep Learning
시리즈 :
I♥A.I. 인공지능 시리즈(아이러브A.I.)
[16]
이안 굿펠로, 요슈아 벤지오, 에런 쿠빌 저 | 류광 역 | 제이펍 | 2018년 10월
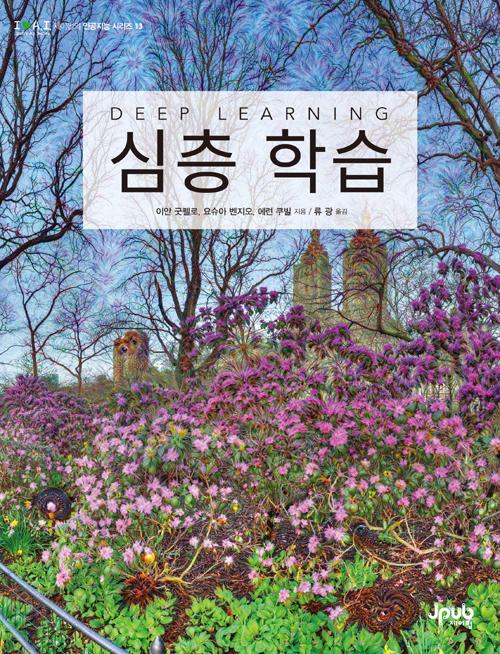





ISBN : 9791188621422 / 908쪽 188 x 245 (㎜)
이 상품에 궁금하신점이 있으세요? 1:1상담문의



아래의 도서와 구매하시면 이 도서들의 적립금을 즉시적용해 드립니다.
-
홍지수, 홍은지
-
마창석
-
조성호
-
권석만
- 30,000
- 22,500
- 29,700
- 26,100



반디앤루니스 리뷰
심층 학습을 위한 완벽한 참고서이자 바이블!
이 책은 우선 심층 학습과 관련된 선형대수, 확률론, 정보 이론, 수치 계산, 기계 학습의 여러 주요 개념을 소개한다. 그런 다음에는 심층 순방향 신경망, 정칙화, 최적화 알고리즘, 합성곱 신경망, 순차열 모형화 등등 업계 실무자들이 사용하는 여러 심층 학습 기법들을 설명하고, 현실적인 심층 학습 실천 방법론도 소개한다. 또한 자연어 처리, 음성 인식, 컴퓨터 시각, 온라인 추천 시스템, 생물정보학, 비디오 게임을 위해 심층 학습을 응용하는 방법들도 개괄한다. 마지막으로는 연구의 관점에서 심층 학습을 살펴보는데, 이를테면 선형 인자 모형, 자동부호기, 표현 학습, 구조적 확률 모형, 몬테카를로 방법 같은 이론 연구 주제들을 소개한다.
출판사 리뷰
심층 학습을 위한 완벽한 참고서이자 바이블!
기계 학습의 한 형태인 심층 학습을 이용하면 컴퓨터가 개념들의 계통구조를 통해서 세계를 경험하고 이해하게 만들 수 있다. 심층 학습에서는 컴퓨터가 경험에서 지식을 수집하므로, 컴퓨터에 필요한 모든 지식을 사람(컴퓨터 운영자)이 일일이 지정할 필요가 없다. 그리고 개념들의 계통구조 덕분에 컴퓨터는 간단한 개념들을 조합해서 좀 더 복잡한 개념을 배우게 된다. 그러한 계통구조의 그래프는 다수의 층으로 이루어진 ‘심층’ 구조를 가질 수 있다. 이 책은 심층 학습의 다양한 주제를 소개한다.
독자가 이 책을 읽는 데 필요한 수학적, 개념적 토대를 마련할 수 있도록, 이 책은 우선 심층 학습과 관련된 선형대수, 확률론, 정보 이론, 수치 계산, 기계 학습의 여러 주요 개념을 소개한다. 그런 다음에는 심층 순방향 신경망, 정칙화, 최적화 알고리즘, 합성곱 신경망, 순차열 모형화 등등 업계 실무자들이 사용하는 여러 심층 학습 기법들을 설명하고, 현실적인 심층 학습 실천 방법론도 소개한다. 또한 자연어 처리, 음성 인식, 컴퓨터 시각, 온라인 추천 시스템, 생물정보학, 비디오 게임을 위해 심층 학습을 응용하는 방법들도 개괄한다. 마지막으로는 연구의 관점에서 심층 학습을 살펴보는데, 이를테면 선형 인자 모형, 자동부호기, 표현 학습, 구조적 확률 모형, 몬테카를로 방법 같은 이론 연구 주제들을 소개한다.
《심층 학습》은 업계 또는 학계에서 연구자로서의 경력을 준비하는 학부생이나 대학원생은 물론이고 자신의 제품이나 플랫폼에서 심층 학습을 사용하고자 하는 소프트웨어 기술자들을 위한 책이다. 독자와 강사에게 도움이 될 보충 자료는 부록 웹사이트에 올려 두었다.

-
- 저자 : 이안 굿펠로, 요슈아 벤지오, 에런 쿠빌

-
- 역자 : 류광

좀 더 일반적으로는 심층 학습을 포함한 기계 학습의(그리고 더 크게는 인공지능 분야 전체의) 용어 중 다른 학문 분야에서 비롯된 것들이 많다는 점을 고려해서, 용어 선택 시 관련 분야 학회 또는 단체의 관례를 최대한 따랐습니다. 예를 들어 대한수학회의 수학 용어집과 한국통계학회의 통계용어 자료실, 한국정보통신기술협회의 정보통신용어사전 등을 주되게 참고했습니다. _xiv쪽
제1부에서 다루는 기본 틀은 그리 깊지 않은 기계 학습 접근 방식들을 포함한 아주 다양한 기계 학습 알고리즘들의 토대이다. 이후의 부들은 바로 이 틀 안에서 심층 학습 알고리즘들을 전개한다. _30쪽
앞에서 자주 쓰이는 몇 가지 추정량의 정의를 소개하고 그 성질들을 분석해 보았다. 그런데 애초에 사람들이 그런 추정량들을 어떻게 고안했을까? 그냥 좋은 추정량이 될 것 같은 함수들을 떠올려서 그 편향과 분산을 분석하는 주먹구구식 방법 대신, 주어진 모형에 대해 좋은 추정량이 될 가능성이 있는 구체적인 함수들을 어떤 원리에 따라 유도할 수 있다면 좋을 것이다. _145쪽
가중치 감쇄는 모형 매개변수들에 직접 벌점을 가해서 모형을 정칙화한다. 그렇게 하는 대신, 신경망 단위들의 활성화 함수에 벌점을 가함으로써 활성화 값들이 희소해지는 쪽으로 모형을 이끄는 전략도 있다. 이는 모형 매개변수들에 단순하지 않은 벌점을 간접적으로 부여하는 한 방법이라 할 수 있다. _281쪽
RNN은 그림 10.5에서처럼 하나의 입력 순차열을 고정 크기 벡터로 사상할 수도 있고, 그림 10.9에서처럼 하나의 고정 크기 벡터를 하나의 순차열로 사상할 수도 있다. 또한, 그림 10.3, 10.4, 10.10, 10.11은 입력 순차열을 같은 길이의 출력 순차열로 사상하는 RNN을 보여주었다. _435쪽

1장 소개 1
1.1 이 책의 대상 독자 10
1.2 심층 학습의 역사적 추세 13
제1부 응용 수학과 기계 학습의 기초 29
2장 선형대수 31
2.1 스칼라, 벡터, 행렬, 텐서 32
2.2 행렬과 벡터의 곱셈 35
2.3 단위행렬과 역행렬 37
2.4 일차종속과 생성공간 38
2.5 노름 41
2.6 특별한 종류의 행렬과 벡터 43
2.7 고윳값 분해 44
2.8 특잇값 분해 47
2.9 무어-펜로즈 유사역행렬 48
2.10 대각합 연산자 49
2.11 행렬식 50
2.12 예: 주성분분석 50
3장 확률론과 정보 이론 57
3.1 확률의 필요성 58
3.2 확률변수 60
3.3 확률분포 61
3.4 주변확률 63
3.5 조건부 확률 64
3.6 조건부 확률의 연쇄법칙 64
3.7 독립과 조건부 독립 65
3.8 기댓값, 분산, 공분산 65
3.9 흔히 쓰이는 확률분포들 67
3.10 흔히 쓰이는 함수들의 유용한 성질들 74
3.11 베이즈 법칙 76
3.12 연속 변수의 특별한 세부 사항 76
3.13 정보 이론 79
3.14 구조적 확률 모형 83
4장 수치 계산 87
4.1 넘침과 아래넘침 87
4.2 나쁜 조건화 89
4.3 기울기 벡터 기반 최적화 90
4.4 제약 있는 최적화 100
4.5 예제: 선형 최소제곱 문제 104
5장 기계 학습의 기초 107
5.1 학습 알고리즘 108
5.2 수용력, 과대적합, 과소적합 121
5.3 초매개변수와 검증 집합 133
5.4 추정량, 편향, 분산 135
5.5 최대가능도 추정 145
5.6 베이즈 통계학 149
5.7 지도 학습 알고리즘 154
5.8 비지도 학습 알고리즘 161
5.9 확률적 경사 하강법 167
5.10 기계 학습 알고리즘 만들기 169
5.11 심층 학습의 개발 동기가 된 기존 문제점들 171
제2부 현세대 심층 신경망의 실제 183
6장 심층 순방향 신경망 185
6.1 예제: XOR의 학습 189
6.2 기울기 기반 학습 194
6.3 은닉 단위 211
6.4 아키텍처 설계 218
6.5 역전파와 기타 미분 알고리즘들 225
6.6 역사적 참고사항 247
7장 심층 학습을 위한 정칙화 251
7.1 매개변수 노름 벌점 253
7.2 제약 있는 최적화로서의 노름 벌점 261
7.3 정칙화와 과소제약 문제 263
7.4 자료 집합의 증강 265
7.5 잡음에 대한 강인성 267
7.6 준지도 학습 269
7.7 다중 과제 학습 270
7.8 조기 종료 271
7.9 매개변수 묶기와 매개변수 공유 279
7.10 희소 표현 281
7.11 배깅과 기타 앙상블 학습법 283
7.12 드롭아웃 285
7.13 대립 훈련 296
7.14 접선 거리, 접선 전파, 다양체 접선 분류기 298
8장 심층 모형의 훈련을 위한 최적화 기법 303
8.1 학습과 순수한 최적화의 차이점 304
8.2 신경망 최적화의 난제들 312
8.3 기본 알고리즘 324
8.4 매개변수 초기화 전략 332
8.5 학습 속도를 적절히 변경하는 알고리즘들 339
8.6 근사 2차 방법들 344
8.7 최적화 전략과 메타알고리즘 352
9장 합성곱 신경망 367
9.1 합성곱 연산 368
9.2 동기 372
9.3 풀링 377
9.4 무한히 강한 사전분포로서의 합성곱과 풀링 382
9.5 기본 합성곱 함수의 여러 변형 383
9.6 구조적 출력 394
9.7 자료 형식 396
9.8 효율적인 합성곱 알고리즘 397
9.9 무작위 특징 또는 비지도 특징 학습 398
9.10 합성곱 신경망의 신경과학적 근거 400
9.11 합성곱 신경망으로 본 심층 학습의 역사 408
10장 순차열 모형화를 위한 순환 신경망과 재귀 신경망 411
10.1 계산 그래프 펼치기 413
10.2 순환 신경망 417
10.3 양방향 순환 신경망 433
10.4 부호기-복호기 순차열 대 순차열 아키텍처 435
10.5 심층 순환 신경망 437
10.6 재귀 신경망 439
10.7 장기 의존성의 어려움 440
10.8 반향 상태 신경망 443
10.9 누출 단위 및 여러 다중 시간 축척 전략 446
10.10 장단기 기억과 기타 게이트 제어 RNN들 449
10.11 장기 의존성을 위한 최적화 453
10.12 명시적 기억 457
11장 실천 방법론 463
11.1 성과 측정 465
11.2 기준 모형 468
11.3 추가 자료 수집 여부 결정 469
11.4 초매개변수 선택 471
11.5 디버깅 전략 480
11.6 예제: 여러 자리 수의 인식 485
12장 응용 489
12.1 대규모 심층 학습 489
12.2 컴퓨터 시각 500
12.3 음성 인식 506
12.4 자연어 처리 510
12.5 기타 응용들 529
제3부 심층 학습 연구 539
13장 선형 인자 모형 542
13.1 확률적 PCA와 인자분석 544
13.2 독립성분분석(ICA) 545
13.3 느린 특징 분석 548
13.4 희소 부호화 551
13.5 PCA의 다양체 해석 555
14장 자동부호기 557
14.1 과소완전 자동부호기 558
14.2 정칙화된 자동부호기 559
14.3 표현력, 층의 크기, 모형의 깊이 564
14.4 확률적 부호기와 복호기 565
14.5 잡음 제거 자동부호기 567
14.6 자동부호기로 다양체 배우기 572
14.7 축약 자동부호기 577
14.8 예측 희소 분해 580
14.9 자동부호기의 응용 581
15장 표현 학습 583
15.1 탐욕적 층별 비지도 사전훈련 585
15.2 전이 학습과 영역 적응 594
15.3 준지도 학습 기법을 이용한 원인 분리 599
15.4 분산 표현 604
15.5 깊이의 지수적 이득 610
15.6 바탕 원인을 발견하기 위한 단서 제공 612
16장 심층 학습을 위한 구조적 확률 모형 617
16.1 비구조적 모형화의 문제점 618
16.2 그래프를 이용한 모형 구조의 서술 623
16.3 그래프 모형의 표본추출 641
16.4 구조적 모형화의 장점 643
16.5 종속관계의 학습 643
16.6 추론과 근사 추론 645
16.7 구조적 확률 모형에 대한 심층 학습 접근 방식 ······646
17장 몬테카를로 방법 653
17.1 표본추출과 몬테카를로 방법 654
17.2 중요도 표집 656
17.3 마르코프 연쇄 몬테카를로 방법 659
17.4 기브스 표집 664
17.5 분리된 모드 사이의 혼합과 관련된 어려움들 ·········665
18장 분배함수 공략 671
18.1 로그가능도의 기울기 672
18.2 확률적 최대가능도와 대조 발산 675
18.3 유사가능도 682
18.4 점수 부합과 비 부합 685
18.5 잡음 제거 점수 부합 688
18.6 잡음 대조 추정 688
18.7 분배함수의 추정 692
19장 근사 추론 701
19.1 최적화로서의 추론 702
19.2 기댓값 최대화 704
19.3 MAP 추론과 희소 부호화 706
19.4 변분 추론과 변분 학습 708
19.5 학습된 근사 추론 724
20장 심층 생성 모형 727
20.1 볼츠만 기계 727
20.2 제한 볼츠만 기계 730
20.3 심층 믿음망 733
20.4 심층 볼츠만 기계 737
20.5 실숫값 자료에 대한 볼츠만 기계 751
20.6 합성곱 볼츠만 기계 759
20.7 구조적 출력 또는 순차열 출력을 위한 볼츠만 기계 ·······762
20.8 기타 볼츠만 기계 763
20.9 확률적(무작위) 연산에 대한 역전파 764
20.10 유향 생성망 770
20.11 자동부호기의 표본추출 791
20.12 생성 확률적 신경망 794
20.13 기타 생성 방안들 796
20.14 생성 모형의 평가 797
20.15 결론 800
참고문헌 803
찾아보기 869

