









출고예상일 안내
주문하신 상품이 한국에서 현지 배송을 위한 출고단계가 이루어질 것으로 예상되는 날짜입니다. 상품을 준비하는 과정에서 내부적인 사정으로 인해 출고예상일에 다소 오차가 생길 수 있습니다.
여러 상품(예약상품포함)을 함께 주문하신 경우 출고예상일이 가장 늦은 날짜에 맞춰 함께 배송됩니다.


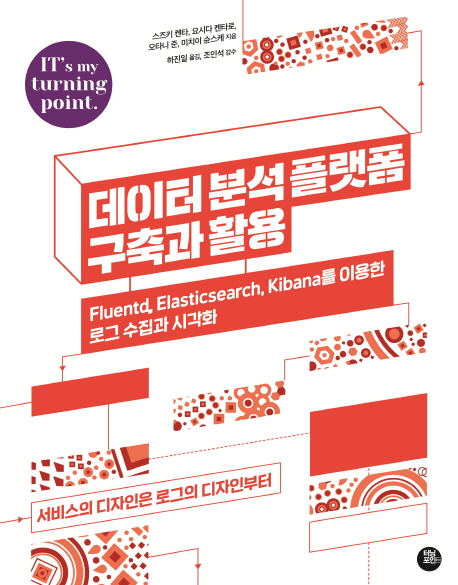





ISBN : 9791161340302 / 432쪽 188 x 240 (㎜)
이 상품에 궁금하신점이 있으세요? 1:1상담문의



아래의 도서와 구매하시면 이 도서들의 적립금을 즉시적용해 드립니다.
-

클리커, 강민혁
-
빨간고래(박정아)
-
-
칼릭스(손윤석)
- 23,400
- 24,300
- 17,550
- 19,800

- 컴퓨터/IT > 프로그래밍 > 기타 프로그래밍 언어

출판사 리뷰
플루언트디, 엘라스틱서치, 키바나를 이용한 로그 수집과 시각화
이 책은 다음과 같은 궁금증을 해결하는데 최상의 선택이 될 수 있습니다.
- 로그가 대량으로 남고 있고, 일단 이용하고 싶다.
- 로그를 해석한 결과를 어디에 활용할 수 있는 지 찾고 싶다.
- Fluentd, Elasticsearch, Kibana를 일단 도입하려고 한다.
- Elasitcsearch 클러스터의 관리방법에 대해서 알고 싶다.
- Kibana를 도입했지만, 어떻게 활용해야할 지 모르겠다.
- Fluentd, Elasticsearch, Kibana를 활용한 사례를 알고 싶다.
먼저 로그 분석이란 무엇인가부터 해서, 어떤 전제로 활용할 수 있는가 그리고 실제로 분석 기반을 만들어서 어떻게 구축하면 좋을까? 각 미들웨어는 어떻게 설정하고, 어떻게 운용하면 좋을까 그리고 어떻게 활용하면 좋을까?
책의 구성
1 파트(1장~4장)에서는 로그를 분석하는 배경과 실제로 로그를 활용해서 시각화 및 분석까지의 흐름을 설명합니다. 로그를 어떻게 활용할 것인지 고민 중인 독자에게 참고가 될 것입니다.
2 파트(5장~8장)에서는 로그를 활용하기 위한 미들웨어 Fluentd에 대해서 설명합니다. Fluentd를 활용하기 위한 팁도 다수 포함되어 있습니다.
3 파트(9장~14장)에서는 Elasticsearch에 대해서 설명합니다. Elasticsearch는 검색엔진이지만 최근에는 로그를 저장하는 미들웨어로 활용되고 있습니다.
4 파트(15장~20장)에서는 Kibana라는 로그 시각화 도구에 대해서 설명합니다. Kibana는 Elasticsearch의 프론트엔드 애플리케이션으로 구축된 도구로 로그를 시각화하기 위해 유용한 기능을 제공합니다.
부록에서는 Fluentd 플러그인 사전, Embulk&Digdag 입문, Embulk 플러그인 사전, Kibana의 편리한 기능 등을 수록하였습니다.

-
- 저자 : 스즈키켄타, 요시다켄타로, 오타니준 외

-
- 역자 : 하진일


part 1 데이터 분석 기반 입문
chapter 1 데이터 분석 개요
1-1 데이터 분석 환경을 구성하는 요소
1-2 데이터 분석 기반의 대상
1-3 데이터 분석 사례 소개
1-4 개요 파악
1-5 수익 구조 파악
1-6 가설과 검증
1-7 의사결정을 위한 데이터 분석
1-8 정리
chapter 2 로그 데이터의 기초
2-1 로그란
2-2 서비스 개선을 위한 로그
2-3 로그 구성
2-4 로그를 살리는 디플로이(배포)
2-5 정리
chapter 3 데이터 분석 기반 구축
3-1 이번 장에서 준비하는 환경
3-2 Elasticsearch 설정
3-3 Kibana 작동
3-4 정리
chapter 4 데이터 분석 기반 운영
4-1 ETL
4-2 데이터 분석 시스템 가용성
4-3 데이터 저장소 비교
4-4 무엇을 가치로 제공할 것인가
4-5 엔지니어로부터 데이터의 활용 방법을 공유하자
4-6 1 파트 정리
part 2 로그 수집 입문
chapter 5 로그 수집 미들웨어 소개
5-1 서비스 개선에 없어서는 안될 로그 수집
5-2 현대적인 로그 수집이란
5-3 정리
chapter 6 처음으로 만나는 Fluentd
6-1 Fluentd는 어떤 미들웨어인가
6-2 Fluentd 셋업
6-3 Fluentd 설정 커스터마이즈
6-4 플러그인 활용
6-5 정리
chapter 7 Fluentd 설계 요령
7-1 tail 플러그인 철저공략
7-2 Fluentd 노드 디자인패턴
7-3 정리
chapter 8 Fluentd 운영 Tips
8-1 Fluentd 감시
8-2 로그 누락을 막기 위한 8가지 포인트
8-3 소유자가 root 유저인 로그 파일을 Fluentd로 수집하기
8-4 Fluentd의 스테이징 환경을 만드는 법
8-5 정리
part 3 Elasticsearch 입문
chapter 9 데이터스토어 입문
9-1 데이터 저장소 요건
9-2 대표적인 데이터 저장소
9-3 정리
chapter 10 Elasticsearch 기초
10-1 Elasticsearch 특징
10-2 아키텍처
10-3 로그 데이터를 저장하는 단위
10-4 정리
chapter 11 Elasticsearch 시작
11-1 준비
11-2 Elasticsearch 기초
11-3 설정.
11-4 인덱스와 데이터의 조작
11-5 검색
11-6 매핑 정의
11-7 정리
chapter 12 Elasticsearch의 운용 팁
12-1 튜닝포인트
12-2 인덱스 수
12-3 스케일 아웃에 대해서
12-4 정리
chapter 13 Curator
13-1 운용에 편리한 도구 Curator
13-2 정리
chapter 14 elasticsearch-hadoop
14-1 elasticsearch-hadoop 개요
14-2 접근 방법
14-3 정리
part 4 Kibana 입문
chapter 15 Kibana 특징
15-1 Kibana에 대해서
15-2 Kibana 시스템 구성
15-3 그 외의 시각화, 분석 도구의 비교
15-4 정리
chapter 16 Kibana 설치와 설정
16-1 다운로드와 인스톨
16-2 초기 설정과 실행
16-3 Docker를 사용한 구성
16-4 인덱스 설정
16-5 정리
chapter 17 Kibana 분석 워크플로우
17-1 샘플 서비스 기동
17-2 케이스 1 : 매트릭 시각화
17-3 케이스 2 : 글 내용 분석
17-4 정리
chapter 18 Discover 탭 검색
18-1 Discover 탭
18-2 레코드 검색
18-3 인덱스와 표시할 필드 선택
18-4 검색 팁
18-5 정리
chapter 19 차트 작성
19-1 차트 작성.
19-2 Metrics와 Buckets
19-3 2차원 차트 설정
19-4 그 외의 표준 차트
19-5 데이터 표시
19-6 그 외의 시각화 방법
19-7 정리
chapter 20 대시보드
20-1 Dashboard 탭
20-2 대시보드 편집
20-3 대시보드 공유
20-4 정리
부록
부록 A Fluentd 플러그인 사전
부록 B Embulk & Digdag 입문
부록 C Embulk 플러그인 사전
부록 D Kibana의 편리한 기능과 그 외의 Elastic Stack의 소개

