









출고예상일 안내
주문하신 상품이 한국에서 현지 배송을 위한 출고단계가 이루어질 것으로 예상되는 날짜입니다. 상품을 준비하는 과정에서 내부적인 사정으로 인해 출고예상일에 다소 오차가 생길 수 있습니다.
여러 상품(예약상품포함)을 함께 주문하신 경우 출고예상일이 가장 늦은 날짜에 맞춰 함께 배송됩니다.


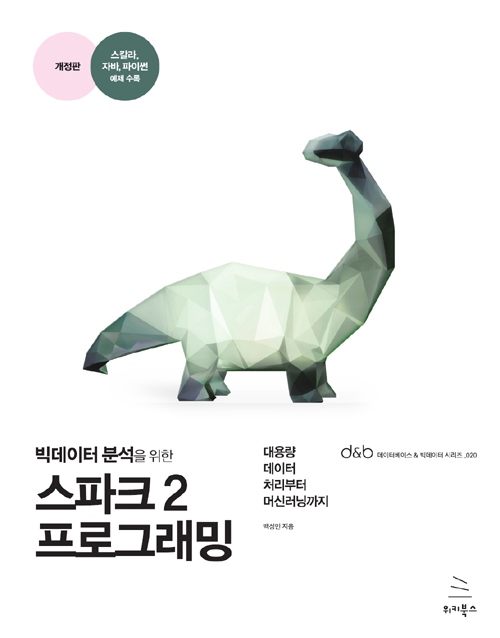





ISBN : 9791158391034 / 644쪽 240 x 188 (㎜)
이 상품에 궁금하신점이 있으세요? 1:1상담문의



아래의 도서와 구매하시면 이 도서들의 적립금을 즉시적용해 드립니다.
-

코리아교육그룹 교육연구소
-
칼릭스(손윤석)
-

거트루드(박태현)
-
김영욱
- 19,800
- 19,800
- 23,400
- 23,400



출판사 리뷰
스파크를 처음 접하는 입문자를 위한 안내서! 하둡으로 대표되던 빅데이터 처리 기술은 빅데이터와 머신러닝, 딥러닝의 붐을 타고 믿을 수 없을 만큼 빠른 속도로 발전해가고 있습니다. 작년 봄 이 책의 초판이 출시되던 해에 스파크는 이미 최고의 데이터 처리 플랫폼 중 하나로 인정받고 있었습니다. 하지만 더 이상 큰 폭의 개편은 없을 것만 같았던 스파크는 그 후로도 더욱 주목할 만한 변화를 거듭하면서 불과 1년이 지난 지금 더욱더 새로워진 API와 고도화된 성능을 갖춘 최적의 데이터 처리 플랫폼으로 변화를 거듭하고 있습니다. 이 책은 스파크를 처음 접하는 개발자들이 빠른 시간 내에 스파크가 무엇이고 어디에 어떻게 활용할 수 있는지 실무에 필요한 감을 잡을 수 있도록 스파크의 전체 모듈에 대한 설명과 예제를 담고 있습니다. 특히 스파크를 써 보고 싶지만 새로운 언어를 배우는 데 따르는 부담 때문에 망설이던 개발자들을 위해 스칼라, 자바, 파이썬 예제를 수록했습니다. 이 책을 통해 스파크에 대한 기초를 다지고 나면 각자의 영역에서 스파크가 제공하는 풍부한 기능들을 더 깊이 있고 자유롭게 활용할 수 있게 될 것입니다.

-
- 구분 : 저서
- 이름 : 백성민
- 국적 : 대한민국
- 직업 :
- 분류 : 기타
- 인기지수 [247]
-


- [최근저서]전체보기
- 빅데이터 분석을 위한 스파크...

▣ 01장: 스파크 소개
1.1 스파크
___1.1.1 빅데이터의 등장
___1.1.2 빅데이터의 정의
___1.1.3 빅데이터 솔루션
___1.1.4 스파크
___1.1.5 RDD(Resilient Distributed Dataset) 소개와 연산
___1.1.6 DAG
___1.1.7 람다 아키텍처
1.2 스파크 설치
___1.2.1 스파크 실행 모드의 이해
___1.2.2 사전 준비
___1.2.3 스파크 설치
___1.2.4 예제 실행
___1.2.5 스파크 셸
___1.2.6 실행 옵션
___1.2.7 더 살펴보기
1.3 개발 환경 구축
___1.3.1 로컬 개발 환경 구축
1.4 예제 프로젝트 설정
___1.4.1 WordCount 예제 실행
1.5 데이터프레임과 데이터셋
1.6 정리
▣ 02장: RDD
2.1 RDD
___2.1.1 들어가기에 앞서
___2.1.2 스파크컨텍스트 생성
___2.1.3 RDD 생성
___2.1.4 RDD 기본 액션
___2.1.5 RDD 트랜스포메이션
___2.1.6 RDD 액션
___2.1.7 RDD 데이터 불러오기와 저장하기
___2.1.8 클러스터 환경에서의 공유 변수
2.2 정리
▣ 03장: 클러스터 환경
3.1 클러스터 환경
___3.1.1 클러스터 모드와 컴포넌트
___3.1.2 클러스터 모드를 위한 시스템 구성
___3.1.3 드라이버 프로그램과 디플로이 모드
3.2 클러스터 매니저
___3.2.1 스탠드얼론 클러스터 매니저
___3.2.2 아파치 메소스
___3.2.3 얀
___3.2.4 히스토리 서버와 매트릭스
___3.2.5 쿠버네티스(Kubenetes)
3.3 정리
▣ 04장: 스파크 설정
4.1 스파크 프로퍼티
4.2 환경변수
4.3 로깅 설정
4.4 스케줄링
___4.4.1 애플리케이션 간의 자원 스케줄링
___4.4.2 단일 애플리케이션 내부에서의 자원 스케줄링
4.5 정리
▣ 05장: 스파크 SQL
5.1 데이터셋
5.2 연산의 종류와 주요 API
5.3 코드 작성 절차 및 단어 수 세기 예제
5.4 스파크세션
5.5 데이터프레임, 로우, 칼럼
___5.5.1 데이터프레임 생성
___5.5.2 주요 연산 및 사용법
5.6 데이터셋
___5.6.1 데이터셋 생성
___5.6.2 타입 트랜스포메이션 연산
5.7 하이브 연동
5.8 분산 SQL 엔진
5.9 Spark SQL CLI
5.10 쿼리플랜(Query Plan)과 디버깅
___5.10.1 스파크세션(SparkSession)과 세션스테이트(SessionState), 스파크컨텍스트(SparkContext)
___5.10.2 QueryExecution
___5.10.3 LogicalPlan과 SparkPlan
5.11 정리
▣ 06장: 스파크 스트리밍
6.1 개요 및 주요 용어
6.1.1 스트리밍컨텍스트
___6.1.2 DStream(Discretized Streams)
6.2 데이터 읽기
___6.2.1 소켓
___6.2.2 파일
___6.2.3 RDD 큐(Queue of RDD)
___6.2.4 카프카
6.3 데이터 다루기(기본 연산)
___6.3.1 print()
___6.3.2 map(func)
___6.3.3 flatMap(func)
___6.3.4 count(), countByValue()
___6.3.5 reduce(func), reduceByKey(func)
___6.3.6 filter(func)
___6.3.7 union()
___6.3.8 join()
6.4 데이터 다루기(고급 연산)
___6.4.1 transform(func)
___6.4.2 updateStateByKey()
___6.4.3 윈도우 연산
___6.4.4 window(windowLength, slideInterval)
___6.4.5 countByWindow(windowLength, slideInterval)
___6.4.6 reduceByWindow(func, windowLength, slideInterval)
___6.4.7 reduceByKeyAndWindow(func, invFunc, windowLength, slideInterval, [numTasks])
___6.4.8 countByValueAndWindow(windowLength, slideInterval, [numTasks])
6.5 데이터의 저장
___6.5.1 saveAsTextFiles(), saveAsObjectFiles(), saveAsHadoopFiles()
___6.5.2 foreachRDD()
6.6 CheckPoint
6.7 캐시
6.8 모니터링
6.9 주요 설정
▣ 07장: 스트럭처 스트리밍
7.1 개요
7.2 프로그래밍 절차
7.3 데이터프레임과 데이터셋 생성
7.4 스트리밍 연산
___7.4.1 기본 연산 및 집계 연산
___7.4.2 윈도우 연산
___7.4.3 워터마킹
___7.4.4 조인 연산
___7.4.5 스트리밍 중복 데이터 제거
___7.4.6 스트리밍 쿼리
7.5 정리
▣ 08장: MLlib
8.1 개요
8.2 관측과 특성
8.3 레이블
8.4 연속형 데이터와 이산형 데이터
8.5 알고리즘과 모델
8.6 파라메트릭 알고리즘
8.7 지도학습과 비지도학습
8.8 훈련 데이터와 테스트 데이터
8.9 MLlib API
8.10 의존성 설정
8.11 벡터와 LabeledPoint
___8.11.1 벡터
___8.11.2 LabeledPoint
8.12 파이프라인
8.13 알고리즘
___8.13.1 Tokenizer
___8.13.2 TF-IDF
___8.13.3 StringIndexer, IndexToString
8.14 회귀와 분류
___8.14.1 회귀
___8.14.2 분류
8.15 클러스터링
8.16 협업 필터링
8.17 정리
▣ 09장: SparkR
9.1 개요
9.2 R 설치 및 실행
9.3 데이터프레임
9.4 데이터프레임 생성
___9.4.1 R데이터프레임으로부터 생성
___9.4.2 파일로부터 생성
9.5 데이터프레임 연산
___9.5.1 조회 및 기본 연산
___9.5.2 그룹 및 집계 연산
___9.5.3 칼럼 연산
___9.5.4 집합 연산
___9.5.5 dapply(), dapplyCollect()
___9.5.6 gapply(), gapplyCollect()
___9.5.7 spark.lapply()
___9.5.8 createOrReplaceTempView()
___9.5.9 write()
9.6 하이브 연동
9.7 머신러닝
9.8 정리
▣ 10장: GraphX
10.1 주요 용어
___10.1.1 유방향 그래프
___10.1.2 유방향 멀티 그래프
___10.1.3 속성 그래프
10.2 데이터 타입
___10.2.1 RDD
___10.2.2 VertextID
___10.2.3 꼭짓점
___10.2.4 선(Edge)
___10.2.5 EdgeTriplet
___10.2.6 VertexRDD
___10.2.7 EdgeRDD
___10.2.8 Graph
10.3 그래프 생성
10.4 그래프 연산
___10.4.1 numEdges, numVertices
___10.4.2 inDegrees, outDegrees, degrees
___10.4.3 vertices, edges, triplets
___10.4.4 mapVertices(), mapEdges(), mapTriplets()
___10.4.5 reverse()
___10.4.6 subgraph()
___10.4.7 mask()
___10.4.8 groupEdges()
___10.4.9 joinVertices(), outerJoinVertices()
___10.4.10 collectNeighborIds(), collectNeighbors()
___10.4.11 aggregateMessages()
___10.4.12 pregel()
10.5 VertextRDD, EdgeRDD 연산
10.6 그래프 알고리즘
10.7 정리
▣ 부록: 스칼라란?
스칼라 설치
스칼라 셸
변수 타입과 변수 선언
Range와 형변환
클래스, 객체, 컴패니언 오브젝트
트레이트와 상속
apply
튜플과 옵션, 케이스클래스
패턴 매치
패키지 객체
type
임포트
함수와 메서드
제네릭
암묵적 변환과 타입 클래스 패턴
정리

