









출고예상일 안내
주문하신 상품이 한국에서 현지 배송을 위한 출고단계가 이루어질 것으로 예상되는 날짜입니다. 상품을 준비하는 과정에서 내부적인 사정으로 인해 출고예상일에 다소 오차가 생길 수 있습니다.
여러 상품(예약상품포함)을 함께 주문하신 경우 출고예상일이 가장 늦은 날짜에 맞춰 함께 배송됩니다.


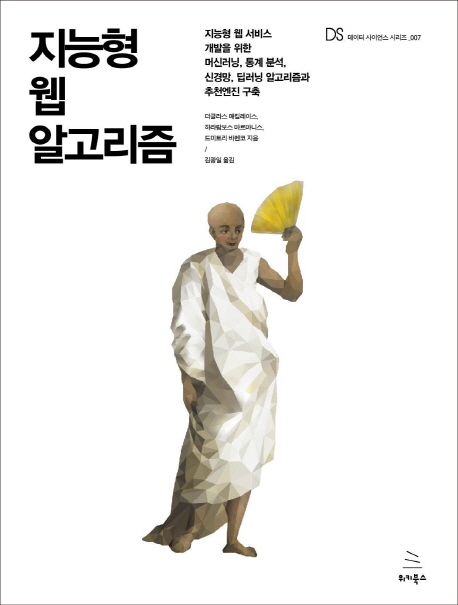
지능형 웹 알고리즘 지능형 웹 서비스 개발을 위한 머신러닝, 통계 분석, 신경망, 딥러닝 알고리즘과 추천엔진 구축
원제 : Algorithms of the Intelligent Web 2nd Edition
시리즈 :
위키북스 데이터 사이언스 시리즈
[27]
더글라스 매킬레이스, 하라람보스 마르마니스, 드미트리 바벤코 저 | 김광일 역 | 위키북스 | 2017년 11월


- 정가
- $50.00
- 판매가
-
$36.45
(27%↓)

- 적립금
- $0.73 (2%P)
품절된 상품입니다.
이 책을 꼭 원하시는 고객님께서는 아래 "상품문의"를 클릭 후 구매의사를
알려주세요. 책이 확보 될 경우 연락 드리겠습니다.



평점 - · 리뷰 0
ISBN : 9791158390815 / 296쪽 175 x 237 (㎜)
이 상품에 궁금하신점이 있으세요? 1:1상담문의



아래의 도서와 구매하시면 이 도서들의 적립금을 즉시적용해 드립니다.
-

성구(강성규)
-
-
칼릭스(손윤석)
-

거트루드(박태현)
- 21,600
- 28,800
- 19,800
- 23,400



출판사 리뷰
★ 이 책에서 다루는 내용 ★
◎ 머신러닝 소개
◎ 데이터 구조 추출
◎ 딥러닝과 신경망
◎ 추천 엔진의 작동 원리

-
- 구분 : 저서
- 이름 : 더글라스 매킬레이스
- 국적 : 기타
- 직업 :
- 분류 : 과학/공학 저자
- 인기지수 [6]
-


- [최근저서]전체보기
-
- 구분 : 저서
- 이름 : 하라람보스 마르마니스
- 국적 : 기타
- 직업 :
- 분류 : 과학/공학 저자
- 인기지수 [6]
-
- [최근저서]전체보기

-
- 이름 : 김광일
- 국적 : 대한민국
- 직업 :
- 분류 : 과학/공학 저자 , 기타
- 인기지수 [16]
-
- [최근저서]전체보기
- 사이버 물리 시스템
- 자바 딥러닝의 핵심 - ac...


▣ 01장: 지능형 웹을 위한 애플리케이션 구축
1.1 실제 사용 중인 지능형 알고리즘: 구글 나우
1.2 지능형 알고리즘의 라이프 사이클
1.3 지능형 알고리즘의 다른 예들
1.4 지능형 애플리케이션이 아닌 것들
_1.4.1 지능형 알고리즘은 만능으로 생각할 수 있는 기계가 아니다
_1.4.2 지능형 알고리즘은 편리한 인간 대체품이 아니다
_1.4.3 지능형 알고리즘은 우연히 발견된 것이 아니다
1.5 지능형 알고리즘의 분류
_1.5.1 인공지능
_1.5.2 머신러닝
_1.5.3 예측분석
1.6 지능형 알고리즘의 성능 평가
_1.6.1 지능 평가
_1.6.2 예측 평가
1.7 지능형 알고리즘에 관한 중요 사항
_1.7.1 데이터는 신뢰할 수 없다
_1.7.2 추론은 즉시 생기지 않는다
_1.7.3 크기가 중요하다!
_1.7.4 알고리즘이 다르면 확장 방식이 달라진다
_1.7.5 모든 문제가 못은 아니다
_1.7.6 데이터가 전부는 아니다
_1.7.7 학습 시간은 변동적이다
_1.7.8 일반화하는 일을 목표로 삼는다
_1.7.9 인간의 직관에는 문제가 있다
_1.7.10 새로운 특징을 뽑아 낼 생각을 하라
_1.7.11 다양한 모델을 학습하라
_1.7.12 상관관계와 인과관계는 같지 않다
1.8 요약
▣ 02장: 군집화와 변환을 통한 데이터 구조 추출
2.1 데이터, 구조, 편향 및 잡음
2.2 차원의 저주
2.3 k 평균
_2.3.1 k 평균 실행
2.4 가우스 혼합모형
_2.4.1 가우스 분포란?
_2.4.2 기댓값 최대화와 가우스 분포
_2.4.3 가우스 혼합모형
_2.4.4 가우스 혼합모형을 이용한 학습의 예
2.5 k 평균과 가우스 혼합모형 간의 관계
2.6 데이터 축 변환
_2.6.1 고유벡터와 고윳값
_2.6.2 주성분 분석
_2.6.3 주성분 분석의 예
2.7 요약
▣ 03장: 콘텐츠 추천
3.1 장면 설정: 온라인 영화 사이트
3.2 거리 및 유사도
_3.2.1 거리와 유사도에 대한 심층 탐구
_3.2.2 최선의 유사도 공식은?
3.3 추천 엔진은 어떻게 동작하는가?
3.4 사용자 기반 협업 필터링
3.5 특잇값 분해를 이용한 모델 기반 추천
_3.5.1 특잇값 분해
_3.5.2 특잇값 분해를 이용한 추천: 사용자에 대한 영화 선택
_3.5.3 특잇값 분해를 이용한 추천: 주어진 영화에 대한 사용자 선정
3.6 넷플릭스 현상 공모
3.7 추천기 평가
3.8 요약
▣ 04장: 분류 - 사물을 속한 곳에 갖다 놓기
4.1 분류의 필요성
4.2 분류기의 개요
_4.2.1 구조적 분류 알고리즘
_4.2.2 통계적 분류 알고리즘
_4.2.3 분류기의 수명주기
4.3 로지스틱 회귀를 사용한 부정행위 탐지
_4.3.1 선형 회귀 입문
_4.3.2 선형 회귀에서 로지스틱 회귀로
_4.3.3 부정행위 탐지 구현
4.4 결과를 믿을 만한가?
4.5 대규모 데이터셋을 사용한 분류
4.6 요약
▣ 05장: 사례 연구 - 온라인 광고를 위한 클릭 예측
5.1 역사및 배경
5.2 광고거래소
_5.2.1 쿠키 일치
_5.2.2 입찰
_5.2.3 낙찰 또는 패찰 통지
_5.2.4 광고 지면
_5.2.5 광고 모니터링
5.3 입찰기는 무엇인가?
_5.3.1 입찰기 요건
5.4 의사결정 엔진이란?
_5.4.1 사용자 정보
_5.4.2 광고 지면 정보
_5.4.3 상황 정보
_5.4.4 데이터 준비
_5.4.5 의사결정 엔진 모델
_5.4.6 예측된 클릭률을 입찰 가격으로 매핑
_5.4.7 특징 공학
_5.4.8 모델 훈련
5.5 보우팔 왜빗을 사용한 클릭 예측
_5.5.1 보우팔 왜빗 데이터 형식
_5.5.2 데이터셋 준비
_5.5.3 모델 테스트
_5.5.4 모델 보정
5.6 의사결정 엔진 구축의 복잡성
5.7 실시간 예측의 미래
5.8 요약
▣ 06장: 딥러닝과 신경망
6.1 딥러닝에 대한 직관적 접근방법
6.2 신경망
6.3 퍼셉트론
_6.3.1 훈련
_6.3.2 사이킷런으로 퍼셉트론 훈련시키기
_6.3.3 두 개의 입력을 위한 퍼셉트론의 기하학적 해석
6.4 다층 퍼셉트론
_6.4.1 역전파를 이용한 학습
_6.4.2 활성화 함수
_6.4.3 역전파의 이면을 직관하기
_6.4.4 역전파 이론
_6.4.5 사이킷런에서 MLNN
_6.4.6 학습된 다층 퍼셉트론
6.5 더 깊은 곳으로: 다층 신경망에서 딥러닝으로
_6.5.1 제한 볼츠만 머신
_6.5.2 베르누이 제한 볼츠만 머신
_6.5.3 실제의 RBM류
6.6 요약
▣ 07장: 적절한 선택
7.1 A/B 테스트
_7.1.1 이론
_7.1.2 코드
_7.1.3 A/B의 적합성
7.2 MAB
_7.2.1 MAB 전략
7.3 실무에서의 베이즈 밴딧
7.4 A/B 대 베이즈 밴딧
7.5 MAB 확장
_7.5.1 상황적 밴딧
_7.5.2 적대적 밴딧
7.6 요약
▣ 08장: 지능형 웹의 미래
8.1 지능형 웹의 미래 응용
_8.1.1 사물 인터넷
_8.1.2 홈 헬스케어
_8.1.3 자율 주행 자동차
_8.1.4 개인화된 물리적 광고
_8.1.5 시맨틱 웹
8.2 지능형 웹의 사회적 함의
▣ 부록
_동기부여를 위한 예: 온라인 광고 노출
_데이터 수집: 나이브한 접근방법
_대규모 수집 데이터 관리
_카프카에 대한 평가: 대규모 데이터 수집
_카프카의 설계 유형

