









출고예상일 안내
주문하신 상품이 한국에서 현지 배송을 위한 출고단계가 이루어질 것으로 예상되는 날짜입니다. 상품을 준비하는 과정에서 내부적인 사정으로 인해 출고예상일에 다소 오차가 생길 수 있습니다.
여러 상품(예약상품포함)을 함께 주문하신 경우 출고예상일이 가장 늦은 날짜에 맞춰 함께 배송됩니다.


R을 활용한 비즈니스 인텔리전스 -acorn+PACKT 시리즈 마케팅 분석, 운영 과학, 데이터 시각화 등 따라 하며 배우
원제 : Introduction to R for Business Intelligence
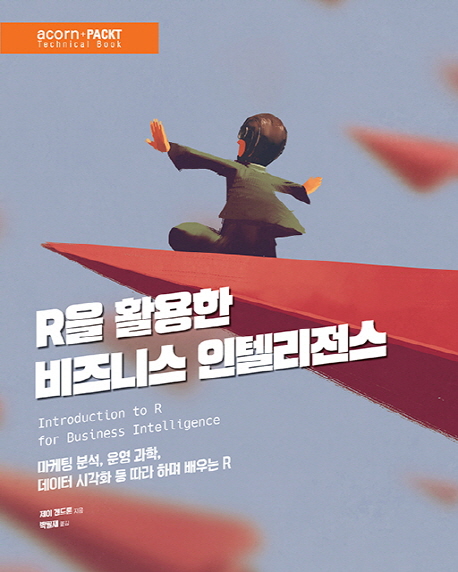





ISBN : 9791161750361 / 264쪽 189 x 235 (㎜)
이 상품에 궁금하신점이 있으세요? 1:1상담문의



아래의 도서와 구매하시면 이 도서들의 적립금을 즉시적용해 드립니다.
-

클리커, 강민혁
-
오유나 외 14인
-
정그린
-
- 23,400
- 22,500
- 23,400
- 20,700


출판사 리뷰
★ 이 책에서 다루는 내용 ★ ■ 원 데이터의 추출, 변형, 로딩 ■ 데이터를 정리하는 체계적인 접근법 ■ 데이터를 이해하기 위한 탐색적 방법 ■ 회귀 모델을 통한 예측 ■ 군집 분석으로 데이터에 가려진 그룹을 파악 ■ 시계열 분석 ■ 데이터 시각화 ■ 샤이니 패키지로 상호작용적인 웹 대시보드 생성 ★ 이 책의 대상 독자 ★ 기업이 당면한 문제를 분석적으로 접근하고, R 테크닉을 향상시키길 원하는 비즈니스 분석가를 대상으로 한다. 또한 비즈니스의 전문 언어를 배우고, 기업 문제에 R 테크닉을 적용하기 때문에 데... ★ 이 책에서 다루는 내용 ★ ■ 원 데이터의 추출, 변형, 로딩 ■ 데이터를 정리하는 체계적인 접근법 ■ 데이터를 이해하기 위한 탐색적 방법 ■ 회귀 모델을 통한 예측 ■ 군집 분석으로 데이터에 가려진 그룹을 파악 ■ 시계열 분석 ■ 데이터 시각화 ■ 샤이니 패키지로 상호작용적인 웹 대시보드 생성 ★ 이 책의 대상 독자 ★ 기업이 당면한 문제를 분석적으로 접근하고, R 테크닉을 향상시키길 원하는 비즈니스 분석가를 대상으로 한다. 또한 비즈니스의 전문 언어를 배우고, 기업 문제에 R 테크닉을 적용하기 때문에 데이터 과학 전문가에게도 도움이 될 것이다. ★ 이 책의 구성 ★ 데이터 과학의 일반적인 흐름에 따라 총 3부(데이터 준비, 분석, 결과물 제시)로 이루어졌다. 1부에서는 데이터를 클리닝하고 다양한 자료에서 데이터를 가져오는 법을 배울 것이다. 1장. '추출, 변형, 저장'에서는 다양한 자료에서 데이터를 추출(Extract), 분석 목적에 따라 데이터를 변형(Transform), 비즈니스 시스템에 변형한 데이터를 저장(Load)하는 ETL 과정을 배울 것이다. 2장. '데이터 처리'에서는 다양한 종류의 데이터에 적합한 처리 절차를 4단계로 배울 것이다. 분석에 앞서 준비 단계에서 데이터의 요약, 수정, 변환, 조정 등을 배울 것이다. 2부에선 비즈니스 인텔리전스를 위해 데이터 탐색, 예측 모델, 군집 분석과 시계열 분석을 해볼 것이다. 3장. '탐색적 데이터 분석'에서는 체계적인 접근을 통해 다소 생소한 데이터셋에 도전해볼 것이다. 3장을 통해 추후에 시도할 분석에 중요한 기법을 배울 것이다. 4장. '비즈니스 회귀 분석'에서는 회귀 분석의 기본 전제 조건을 학습하고, 단순 회귀, 다중 회귀 분석과 같은 대표적인 회귀 분석을 배운다. 5장. '군집 분석을 통한 데이터 마이닝'에서는 k평균, 계층 클러스터링(hierarchical clustering)과 같은 비지도 학습을 배운다. 이 두 가지 데이터 마이닝 기법을 통해 데이터에 숨겨진 패턴을 찾아낼 수 있다. 6장. '시계열 분석'에서는 데이터 과학 과정에서 잘 가르치지 않는 어려운 주제를 소개한다. 머신 러닝 기법은 아니지만, 과거 데이터를 활용해 미래를 예상하는 테크닉을 배울 것이다. 마지막으로 3부에서 첨단 시각화 기술, 상호작용하는 웹 기반의 대시보드로 데이터 분석의 결과물을 상대방에게 전달하는 법을 배운다. 7장. '데이터 스토리 시각화'에서는 결과물을 시각화하는 테크닉은 물론 색상, 모양, 위치에 따라 상대방이 어떻게 결과물을 인지적으로 해석하는지 배울 것이다. 8장. 'Shiny로 만드는 웹 대시보드'에서는 R의 Shiny 패키지를 통해 웹 기반 비즈니스 인텔리전스를 구축하는 법을 배운다.

-
- 구분 : 저서
- 이름 : 제이 겐드론
- 국적 : 기타
- 직업 :
- 분류 : 과학/공학 저자
- 인기지수 [2]
-


- [최근저서]전체보기
- R을 활용한 비즈니스 인텔리...

-
- 이름 : 박필재
- 국적 : 대한민국
- 직업 :
- 분류 : 과학/공학 저자
- 인기지수 [2]
-
- [최근저서]전체보기
- R을 활용한 비즈니스 인텔리...

★ 지은이의 말 ★
이 책은 성장하는 스타트업 기업에서 근무하는 데이터 분석가의 시각으로 비즈니스 인텔리전스를 경험할 수 있는 기회를 제공한다. 독자들은 기업 경영과 관련된 여러 가지 케이스를 통해 R을 배울 것이다. 즉 마케팅, 재무, 운영 등 기업 경영에서 마주칠 수 있는 다양한 문제에 대해 독자들이 데이터 중심 분석으로 해결하도록 도와준다. 이 책은 올바른 질문을 제기하고 스토리와 시각화를 통해 독자들이 데이터와 기업을 연결하는 것을 도와준다. R을 통해 비즈니스 인텔리전스 문제를 해결하는 과정을 즐기길 바란다.
★ 지은이의 말 ★
이 책은 성장하는 스타트업 기업에서 근무하는 데이터 분석가의 시각으로 비즈니스 인텔리전스를 경험할 수 있는 기회를 제공한다. 독자들은 기업 경영과 관련된 여러 가지 케이스를 통해 R을 배울 것이다. 즉 마케팅, 재무, 운영 등 기업 경영에서 마주칠 수 있는 다양한 문제에 대해 독자들이 데이터 중심 분석으로 해결하도록 도와준다. 이 책은 올바른 질문을 제기하고 스토리와 시각화를 통해 독자들이 데이터와 기업을 연결하는 것을 도와준다. R을 통해 비즈니스 인텔리전스 문제를 해결하는 과정을 즐기길 바란다.

1장. 추출, 변형, 저장
__비즈니스 인텔리전스 분석에서 빅데이터 이해하기
__다양한 정보원에서 데이터 추출하기
____CSV 및 다른 형태 파일 불러오기
____관계형 데이터에서 자료 호출하기
__분석 수요에 맞게 데이터 변형하기
____데이터 행 필터링하기
____데이터 칼럼(열) 선택하기
____기존 데이터에서 계산된 열 삽입하기
____그룹별로 데이터 집계하기
__분석을 위해 비즈니스 시스템에 데이터 로딩하기
____CSV 파일로 저장하기
____TXT 파일로 저장하기
__요약
2장. 데이터 처리
__검사를 위해 데이터 요약하기
____str() 함수를 이용해 요약하기
____분석 결과 검사하고 분석하기
__결함 데이터 찾아 수정하기
____데이터셋의 결함 찾아내기
____결함 데이터 수정하기
__분석 목적에 맞도록 데이터 형태 가공하기
____데이터 형태간 변환
____날짜 및 시간 변환
__문자열 데이터를 표준형으로 가공하기
____숫자 7의 힘
____데이터 분석을 위한 최종 준비
__요약
3장. 탐색적 데이터 분석
__탐색적 데이터 분석 이해하기
____질문의 중요성
____측정 척도
____R의 데이터 형태
__단일 변수 분석하기
____표를 활용한 데이터 탐색
____그래픽을 활용한 데이터 탐색
__두 개의 변수 분석하기
____데이터의 전반적인 모양은 어떨까?
____두 변수 사이에 어떤 관계가 있을까?
____두 변수 사이에 어떤 상관관계가 있을까?
____상관관계는 유의한 수준인가?
__다수의 변수 동시에 분석하기
____데이터 관찰
____데이터의 관계
____상관관계
____유의성 판단
__요약
4장. 비즈니스 회귀 분석
__선형 회귀의 이해
____lm() 함수 이해하기
____단순 선형 회귀
____잔차
__회귀 모델의 가정 점검
____선형성
____독립성
____정규성
____등분산성
____가정들에 대한 정리
__단순 선형 회귀 활용
____분석 결과 해석하기
____단순 선형 회귀로 미지의 결과 예측하기
____신뢰 구간을 활용한 빅데이터 다루기
__선형 회귀를 위한 데이터 개선
____데이터 변형하기
____이상치 데이터 처리하기
__다중 선형 회귀 분석 실행
__요약
5장. 군집 분석을 활용한 데이터 마이닝
__군집 분석에 대한 설명
__K평균 군집을 활용한 분할
____데이터 탐색
____k평균 함수 실행하기
____모델 결과 해석하기
____비즈니스 사례 분석하기
__계층적 군집화 기술
____데이터 정리 및 탐색
____hclust() 함수 실행하기
____분석 결과를 시각화하기
____모델 평가하기
____모델 선택하기
____분석 결과 준비하기
__요약
6장. 시계열 분석
__선형 회귀로 시계열 데이터 분석하기
____선형성, 정규성, 등분산성
____예측과 신뢰 구간
__시계열 분석의 핵심 요소 이해
____안정적 데이터 가정
____차분 방법
__ARIMA 모델 만들기
____모델 선택
____고급 모델링 기법 사용하기
__요약
7장. 데이터 스토리 시각화
__데이터 시각화
____원하는 정보로 주의 집중시키기
____이용자의 해석 돕기
__ggplot2로 그래프 그리기
__Leaflet을 활용한 지리 정보 시각화
____지리 정보 시각화 학습
____지리 정보 시각화 기능 확장
__rCharts로 상호작용하는 그래프 그리기
____데이터 스토리의 큰 틀 짜기
____자바스크립트로 상호작용 기능의 그래프 그리기
__요약
8장. Shiny로 만드는 웹 대시보드
__기본 Shiny 애플리케이션 만들기
____ui.R 파일
____server.R 파일
__마케팅 캠페인 Shiny 애플리케이션 만들기
____다기능의 Shiny 폴더와 파일 구조 사용하기
____유저 인터페이스 설계
____서버 코드 만들기
__Shiny 애플리케이션 배포하기
____깃허브에 저장
____RStudio에 호스팅
____사설 웹 서버에 호스팅
__요약

