









출고예상일 안내
주문하신 상품이 한국에서 현지 배송을 위한 출고단계가 이루어질 것으로 예상되는 날짜입니다. 상품을 준비하는 과정에서 내부적인 사정으로 인해 출고예상일에 다소 오차가 생길 수 있습니다.
여러 상품(예약상품포함)을 함께 주문하신 경우 출고예상일이 가장 늦은 날짜에 맞춰 함께 배송됩니다.


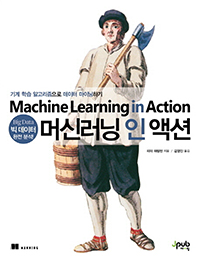





ISBN : 9788994506661 / 448쪽 188 x 245 (㎜)
이 상품에 궁금하신점이 있으세요? 1:1상담문의



아래의 도서와 구매하시면 이 도서들의 적립금을 즉시적용해 드립니다.
-
정지훈
-
-
빨간고래(박정아)
-
- 25,200
- 36,000
- 24,300
- 17,550



출판사 리뷰
출판사 서평 빅 데이터 분석의 핵심 기술, 기계 학습! 《머신러닝 인 액션》은 개발자를 위해 작성된 지침서다. 통계자료 처리, 데이터 분석, 데이터 시각화 등을 독자들의 업무에 바로 적용할 수 있도록 알고리즘 주요 부분을 재사용 가능한 코드로 사용하였다. 독특하고 다양한 파이썬 예제를 통해 분류, 예측, 추천 그리고 고차원 속성을 요약하고 간소화하는 개념과 방법을 이해하게 될 것이다. 최고의 한 수를 위한 데이터 마이닝! 컴퓨터는 자신의 성능을 개선하기 위해 경험적 지식을 활용한다. 이러한 학습을 위해서는 데이터를 얻는 프로그램이 있어... 빅 데이터 분석의 핵심 기술, 기계 학습! 《머신러닝 인 액션》은 개발자를 위해 작성된 지침서다. 통계자료 처리, 데이터 분석, 데이터 시각화 등을 독자들의 업무에 바로 적용할 수 있도록 알고리즘 주요 부분을 재사용 가능한 코드로 사용하였다. 독특하고 다양한 파이썬 예제를 통해 분류, 예측, 추천 그리고 고차원 속성을 요약하고 간소화하는 개념과 방법을 이해하게 될 것이다. 최고의 한 수를 위한 데이터 마이닝! 컴퓨터는 자신의 성능을 개선하기 위해 경험적 지식을 활용한다. 이러한 학습을 위해서는 데이터를 얻는 프로그램이 있어야 하며, 그 데이터의 흥미롭고 유용한 패턴을 찾을 수 있도록 알고리즘이 있어야 한다. 하지만 가장 먼저 필요한 것은 분석을 하고자 하는 영역을 설정하는 것이며, 이를 분석하기 위한 수학자들이 있어야 한다는 것이다. 기계 학습은 이처럼 다양한 기술들을 필요로 한다. 독자들은 기계 학습이나 통계 처리에 대한 사전 지식이 없어도 상관없다. 파이썬이 기계 학습과 친숙해지도록 도와줄 것이다. 이 책의 주요 내용은 다음과 같다. ㆍ 기계 학습 소개 ㆍ 다양한 예제로 기계 학습 실습하기 ㆍ 매일 발생되는 데이터 분석하기 ㆍ 어프라이어리와 에이다부스트 같은 전형적인 알고리즘 수행하기 8개의 기계 학습 알고리즘 ㆍ C4.5(trees) ㆍ k-평균(k-means) ㆍ 지지 벡터 머신기계(support vector machines) ㆍ 어프라이어리(Apriori) ㆍ 에이다부스트(AdaBoost) ㆍ k-최근접 이웃(k-Nearest Neighbors) ㆍ 나이브 베이스(Na?ve Bayes) ㆍ 카트(CART) 추천사 이해하기 쉽고 유용한 책! -알렉산드라 알베스(Alexandre Alves), 오라클(Oracle Corpration) 핵심 개념의 똑똑하고 매력적인 응용 프로그램! -패트릭 투히(Patrick Toohey), 메틀러토레도(Mettler-Toledo Hi-Speed) 기막힌 예제들! 이를 통해 무엇이든 ‘학습’할 수 있다. -존 그리핀(John Griffin), 《Hibernate Search in Action》의 공동 저자 다양한 기계학습 알고리즘으로 능숙하게 설계된 ‘쉬운’ 분류! -스티븐 맥카메이(Stephen McKamey), 아이소머 이노베이션(Isomer Innovations) 현업에 종사하는 전문가를 위한 훌륭한 책! -에드몽 베골리(edmon begoli), 아마존 ★★★★★





기계 학습은 컴퓨터 과학과 기술 그리고 통계학의 교차로에 놓여있으며, 때로는 다른 학문에서 사용되기도 한다. 나중에 보면 알 수 있겠지만, 이것은 정치에서 지구과학까지 많은 분야에서 응용될 수 있다. 이것은 다양한 문제들에 적용할 수 있는 도구이다. 데이터를 해석하고 실행해야 하는 분야에서 기계 학습 기술을 사용한다면 이득을 얻을 수 있다.
_5
당신은 데이터를 파악하기 위해 얼마간의 시간을 보내게 될 것이며, 데이터에 대해 더 많은 것을 알아야만 성공적인 응용 프로그램을 구축할 수 있게 될 것이다. 데이터에 대해 알고자 하는 것은 다음과 같은 것이다. 속성이 명목형인가? 연속형인가? 속성 내에 누락된 값이 있는가? ... 데이터 내에 오류 데이터(outlier)가 있는가? 건초 더미에서 바늘을 찾는 것처럼 매우 드물게 발생하는 어떠한 것이 존재하는가? 이처럼, 데이터 속성에 대한 모든 것은 알고리즘 선택 과정의 폭을 좁히는 데 도움을 준다.
_13
검색 엔진에 단어 또는 단어의 일부를 입력하면, 검색 엔진은 우리가 입력할 검색어를 자동으로 완성해 준다. ... 이러한 검색어를 찾아내기 위해 검색 엔진 회사에서 연구원들이 사용하는 알고리즘들을 설명한다. 연구원들은 인터넷에서 사용된 단어들을 찾고, 빈발하게 함께 발생하는 단어의 쌍을 찾는다. 이를 위해서는 빈발 아이템 집합을 효과적으로 찾는 방법이 필요하다.
_315
트위터 사이트에서는 개발자들에게 이들이 제공하는 서비스를 상용할 수 있도록 다양한 API를 제공한다. 파이썬 모듈인 Python‐Twitter는 트위터에 쉽게 접근할 수 있게 한다. 특정 주제에 대한 트위터 피드에 FP‐성장 알고리즘을 적용하면, 우리는 이 주제에 대한 약간의 요약 정보를 얻을 수 있다. 이렇게 빈발 아이템 집합을 생성하는 것은 쇼핑 트랜잭션, 의료 진단, 대기에 대한 연구 등 다양한 분야에서 사용될 수 있다.
_337

목차
역자 머리말
머리말
감사의 글
이 책에 대하여
겉표지 삽화에 대하여
제1부 분류
1장 기계 학습 기초
2장 K-최근접 이웃 알고리즘
3장 의사결정 트리: 한 번에 하나의 속성으로 데이터 집합 분할하기
4장 나이브 베이스: 확률 이론으로 분류하기
5장 로지스틱 회귀
6장 지지 벡터 머신
7장 에이다부스트 메타 알고리즘으로 분류 개선하기
제2부 회귀로 수치형 값 예측하기
8장 회귀: 수치평 값 예측하기
9장 트리 기반 회귀
제3부 비지도 학습
10장 K-평균 군집화: 항목 표시가 없는 아이템 그룹 짓기
11장 어프라이어리 알고리즘으로 연관 분석하기
12장 FP-성장 알고리즘으로 빈발 아이템 집합 찾기
제4부 부가적인 도구들
13장 데이터 간소화를 위한 주요 구성요소 분석 사용하기
14장 특이 값 분해로 데이터 간소화하기
15장 빅 데이터와 맵 리듀스
부록 A 파이썬 시작하기
부록 B 선형대수학
부록 C 확률 다시 보기
부록 D 리소스
찾아보기

