









출고예상일 안내
주문하신 상품이 한국에서 현지 배송을 위한 출고단계가 이루어질 것으로 예상되는 날짜입니다. 상품을 준비하는 과정에서 내부적인 사정으로 인해 출고예상일에 다소 오차가 생길 수 있습니다.
여러 상품(예약상품포함)을 함께 주문하신 경우 출고예상일이 가장 늦은 날짜에 맞춰 함께 배송됩니다.


HBase 클러스터 구축과 관리 - acorn+PACKT 시리즈 NoSQL 데이터베이스 관리를 위한 하둡과 HBase 클러스터 설치에서 고급 튜닝까지
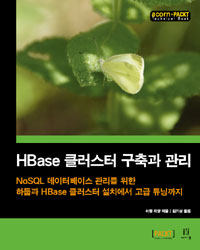





ISBN : 9788960773790 / 388쪽 188 x 235 (㎜)
이 상품에 궁금하신점이 있으세요? 1:1상담문의



아래의 도서와 구매하시면 이 도서들의 적립금을 즉시적용해 드립니다.
-
정지훈
-
로버트 칸, 크리스 퀴그
-
이지영
-

거트루드(박태현)
- 25,200
- 31,500
- 27,000
- 23,400


출판사 리뷰
HBase는 오픈소스 분산 빅데이터 저장소로 상용 머신으로 구성된 클러스터에서 수백만 개의 컬럼(column)을 가진 수십억 개의 로우(row)를 처리할 수 있다. 실시간으로 대량의 데이터를 저장하고 액세스할 방법을 찾고 있다면 HBase가 최고의 선택이 될 것이다.
『HBase 클러스터 구축과 관리』는 실제적이며 쉬운 단계별 예제를 통해 HBase를 쉽게 관리하도록 도와준다. 하둡(Hadoop)과 HBase의 관계를 이해하는 것이 HBase를 사용하는 데에 매우 중요하다. 이 책은 하둡 클러스터를 설치하고 하둡과 HBase가 같이 동작하게 설정하는 방법과 클러스터의 성능을 튜닝하는 방법을 소개한다.
★ 이 책에서 다루는 내용 ★
■ 고가용성을 지닌 분산 HBase 클러스터를 설치하고 클라이언트 API나 맵리듀스(MapReduce) 잡을 이용해 데이터를 로드한다.
■ HBase 셸 또는 SQL 유사 질의 언어를 이용한 하이브(Hive)를 사용해 HBase의 데이터를 액세스한다.
■ HBase 테이블의 데이터뿐만 아니라 데이터의 분포까지 백업하고 복구한다. 그리고 서로 다른 HBase 클러스터 사이에 데이터를 옮기고 복사한다.
■ 커널 설정과, JVM GC, 하둡, HBase 설정을 튜닝해 최대의 성능을 얻는다.
■ 문제해결 툴을 사용해 HBase를 사용하며 자주 발생하는 문제를 해결한다.
■ 읽기 또는 쓰기가 많은 클러스터를 튜닝하기 위한 고급 설정과 튜닝 방법을 소개한다.
★ 이 책의 대상 독자 ★
이 책은 HBase 관리자, 개발자를 위한 책이며, 하둡 관리자에게도 도움이 될 것이다. HBase에 대한 경험은 필요치 않으나 하둡과 맵리듀스에 대한 기본적인 이해는 필요하다.
★ 이 책의 구성 ★
1장, HBase 클러스터 설치: 1장에서는 HBase 클러스터를 셋팅하는 방법을 설명한다. 기본적인 스탠드얼론 HBase 인스턴스를 구축하는 것에서부터 아마존 EC2에 분산, 고가용성 HBase 클러스터를 설치하는 것까지 다룬다.
2장, 데이터 마이그레이션: 2장에서는 우선, HBase의 Put API를 사용해 MySQL에서 HBase로 데이터를 임포트하는 간단한 작업에 대해 설명한다. 그 후, TSV 데이터 파일을 로드하는 importtsv와 벌크 로드 툴의 사용법을 설명한다. 또한 맵리듀스 샘플을 사용해 다른 파일 포맷에서 데이터를 임포트하는 방법도 소개할 것이다. 여기서는 HBase 테이블에 데이터를 바로 적재하는 것과 하둡 분산 파일 시스템(HDFS)에 HFile 포맷 파일을 작성하는 방법도 다룬다. 그리고 마지막으로 HBase에 데이터를 적재하기 전에 영역을 미리 생성하는 방법을 설명한다.
2장에는 자바로 작성된 예제가 여러 개 있다. 독자가 자바의 기초적인 사용방법을 알고 있다고 가정하며 예제의 샘플 자바 코드를 컴파일하고 패키지화하는 방법은 다루지 않았다.
3장, 관리 도구 사용 방법: 3장에서는 HBase 웹 UI, HBase 셸, HBase hbck 등의 여러 가지 관리 툴의 사용법을 설명한다. 툴의 목적과 특정 작업을 해결하기 위한 툴의 사용법을 설명한다.
4장, HBase 데이터 백업과 복구: 4장에서는 HBase 데이터를 백업하는 다양한 방법을 설명하고, 각 방법의 장단점과 데이터셋의 크기, 자원, 요구사항에 따라 어떤 방법을 선택해야 하는지 설명한다.
5장, 모니터링과 진단: 5장에서는 Ganglia, OpenRSDB, Nagios 등의 툴을 사용해 HBase 클러스터를 모니터하고 진단하는 방법을 설명한다. 먼저 HBase 테이블의 디스크 사용량을 확인하는 방법부터 소개한다. Ganglia를 설치하고 HBase를 모니터하도록 설정하고 Ganglia 그래프의 사용방법을 보여줄 것이다. 또한 OpenTSDB도 설치하는데, OpenTSDB는 Ganglia와 비슷하지만 HBase를 사용하기 때문에 좀더 확장성이 있다.
Nagios를 설치해 HBase 관련 데몬의 상태, 하둡/HBase 로그, HBase 일관성 상태, HDFS의 상태와 사용량 등을 체크할 것이다.
마지막으로 핫 스팟 영역 이슈를 진단하고 고치는 방법을 설명한다.
6장, 관리 유지와 보안: 6장에서 소개되는 처음의 여섯 개의 예제에서는 결함을 찾고 고치는 작업, 클러스터 크기 변경, 설정 변경 등과 같은 여러 가지 HBase 관리 작업에 대해 배울 것이다.
6장에서는 보안 관련 이슈들도 살펴본다. 마지막 세 개의 예제에서는 커버로스(Kerberos)를 설치하고 이를 이용해 HDFS 보안을 설정하는 방법과 마지막으로 HBase 클라이언트 접근을 설정하는 방법을 다룬다.
7장, 문제 해결: 7장에서는 여러 가지 자주 부딪히는 문제들에 대해 살펴본다. 각 이슈들의 에러 메시지를 설명하고, 문제의 원인과 툴을 사용해 해결하는 방법을 설명한다.
8장, 기본 성능 튜닝: 8장에서는 좀더 좋은 성능을 얻기 위한 HBase 튜닝 방법을 설명한다. 우리는 또한 하둡 설정, JVM 가비지 콜렉션, OS 커널 파라미터와 같은 튜닝 포인트를 조절하는 방법도 설명한다.
9장, 고급 설정과 튜닝: 9장은 이 책에서 두 번째 성능 튜닝과 관련된 장이다. 8장에서는 HBase의 전반적인 성능 향상을 위한, 하둡 그리고 OS 설정, 자바, HBase 자체를 튜닝하는 방법을 설명했다. 이들은 많은 경우에 적용할 수 있는 일반적인 방법이다. 9장에서는 좀더 특수한 케이스를 다룬다. 그 중에서는 쓰기가 많은 클러스터에 특화되거나 클러스터의 읽기 성능 개선을 목표로 하는 방법들도 있다.
★ 저자 서문 ★
HBase는 오픈소스 분산 빅데이터 저장소로, 수백만 개의 컬럼(column)을 가진 수십억 개의 로우(row)를 처리할 수 있으며, 일반 범용 컴퓨터로 구성된 클러스터에서 동작한다. 대용량 데이터를 저장하고 실시간으로 액세스하고 싶다면 HBase가 최적의 선택이 될 것이다.
HBase Administration Cookbook은 HBase를 쉽게 관리하기 위한 실제적인 예제와 단계별로 수행할 수 있는 지시사항을 제공한다. 각 예제들은 클라우드상에서 동작하는 분산, 고가용성 HBase 클러스터를 관리하는데 필요한 다양한 프로세스를 다룬다. 이와 같은 대용량 데이터를 다루는데 있어서 가장 중요한 것은 조직화되고 관리 가능한 프로세스이며, 이 책은 독자가 이것 들을 확립할 수 있는데 도움을 줄 것이다.
이 책은 분산 HBase 클러스터를 설정하고 데이터를 옮기는 것에서부터 시작한다. 독자는 일상적인 관리에 필요한 모든 툴의 사용법뿐만 아니라, 가장 최상의 성능을 얻기 위해 클러스터를 효율적으로 관리하고 모니터링 하는 방법까지 배우게 될 것이다. 하둡과 HBase와의 관계를 이해하면 HBase를 더 잘 활용할 수 있다. 따라서 이 책은 하둡 클러스터를 셋팅하고, 하둡이 HBase와 연동되도록 설정하는 방법, 그리고 성능을 튜닝하는 방법도 다룬다.
★ 옮긴이의 말 ★
최근 IT의 가장 큰 화두로 빅데이터가 부상하고 있습니다. 이는 최근의 데이터의 개념과 관리 기술의 변화를 보여줍니다. 모바일 디바이스의 발달은 사용자가 생성하는 데이터가 폭발적으로 증가시켰습니다. 또한, 스토리지 기술의 발달은 기업이 이전에 생각지 못한 대량의 비즈니스 데이터를 축적할 수 있게 했습니다. 이와 더불어 클러스터 기술의 발달은 이런 대용량 데이터에 대한 실시간 처리 및 분석을 가능케 했습니다. 이제 모든 것이 데이터로 표현되고 저장되며 이런 데이터를 누가 얼마나 잘 관리하고 이로부터 얼마나 가치 있는 정보를 이끌어내는지가 비즈니스의 성패를 좌우하는 시대가 됐습니다.
이와 같은 빅데이터 시대에 HBase는 가장 주목 받는 오픈소스 NoSQL 데이터베이스입니다. HBase는 2006년 구글이 발표한 빅테이블(BigTable)이라는 논문에서 시작했습니다. 빅테이블은 빅데이터를 처리하기 위해 여러 상용 머신을 클러스터로 구축한 클러스터를 기반으로 동작합니다. 이런 빅테이블을 오픈소스로 구현한 구현체가 HBase입니다. HBase의 등장은 기존의 데이터베이스 패러다임을 RDBMS에서 NoSQL로 변화시킨 계기가 됐고, 그 이후로 많은 오픈소스 NoSQL 데이터베이스가 등장하게 된 시작점이 됐습니다.
이 책은 HBase를 실제로 운영하는 관리자나 HBase를 공부하려는 초심자 모두에게 매우 유용한 내용을 담고 있습니다. 저자는 자신이 근무하는 회사에서 실제로 대규모의 HBase 클러스터를 운영하고 있으며 이를 기반으로 운영되는 서비스를 관리하고 있습니다. 이 책은 이와 같은 저자의 다년간 경험을 바탕으로 HBase 운영에 가장 필요한 핵심 내용을 예제 형식으로 제공합니다.
이 책의 예제는 HBase 클러스터의 설치와 관리 방법에서 시작해 고급 튜닝 기법까지, HBase 클러스터를 운영하기 위한 전반적인 내용을 풍부하게 다룹니다. 시작은 초보자를 위해 실제 HBase 클러스터를 구축하기 위한 하둡(Hadoop) 클러스터 및 주키퍼(ZooKeeper) 등을 설치하고 이를 기반으로 HBase를 설치하는 방법을 쉽게 설명합니다. 이후에는 HBase 클러스터의 데이터 백업 및 복구, 모니터링과 같은 관리 방법을 다루며 클러스터 운영에 매우 중요한 보안 이슈도 다룹니다. 또한, 최적의 HBase 클러스터를 운영하기 위한 저자의 경험이 담긴 고급 튜닝 기법도 전수해줍니다. 이와 같은 내용은 모두 예제 형식으로 구성되어 초보자도 쉽게 실습하고 이해할 수 있으며, 예제마다 단계별 지시 사항뿐만 아니라 예제의 바탕에 깔린 핵심 원리도 자세히 설명하고 있습니다. 각 예제는 모두 HBase 관리자라면 꼭 알아야 할 핵심 내용을 다루고 있으며 예제를 실습하는 동안 자신도 모르는 사이에 HBase 전문가가 될 수 있다고 생각합니다. 이 책을 통해 빅데이터 시대의 데이터베이스 관리에 필수적인 저자의 오랜 실전 경험과 노하우를 전수받을 수 있을 것입니다.


-
- 구분 : 저서
- 이름 : 이펑 지앙
- 국적 : 기타
- 직업 :
- 분류 : 과학/공학 저자
- 인기지수 [15]
-


- [최근저서]전체보기
- HBase 클러스터 구축과 ...

-
- 이름 : 김기성
- 국적 : 대한민국
- 직업 :
- 분류 : 과학/공학 저자 , 기타
- 인기지수 [55]
-

★ 저자 서문 ★
HBase는 오픈소스 분산 빅데이터 저장소로, 수백만 개의 컬럼(column)을 가진 수십억 개의 로우(row)를 처리할 수 있으며, 일반 범용 컴퓨터로 구성된 클러스터에서 동작한다. 대용량 데이터를 저장하고 실시간으로 액세스하고 싶다면 HBase가 최적의 선택이 될 것이다.
HBase Administration Cookbook은 HBase를 쉽게 관리하기 위한 실제적인 예제와 단계별로 수행할 수 있는 지시사항을 제공한다. 각 예제들은 클라우드상에서 동작하는 분산, 고가용성 HBase 클러스터를 관리하는데 필요한 다양한 프로세스를 다룬다. 이와 같은 대용량 데이터를 다루는데 있어서 가장 중요한 것은 조직화되고 관리 가능한 프로세스이며, 이 책은 독자가 이것 들을 확립할 수 있는데 도움을 줄 것이다.
이 책은 분산 HBase 클러스터를 설정하고 데이터를 옮기는 것에서부터 시작한다. 독자는 일상적인 관리에 필요한 모든 툴의 사용법뿐만 아니라, 가장 최상의 성능을 얻기 위해 클러스터를 효율적으로 관리하고 모니터링 하는 방법까지 배우게 될 것이다. 하둡과 HBase와의 관계를 이해하면 HBase를 더 잘 활용할 수 있다. 따라서 이 책은 하둡 클러스터를 셋팅하고, 하둡이 HBase와 연동되도록 설정하는 방법, 그리고 성능을 튜닝하는 방법도 다룬다.
★ 옮긴이의 말 ★
최근 IT의 가장 큰 화두로 빅데이터가 부상하고 있습니다. 이는 최근의 데이터의 개념과 관리 기술의 변화를 보여줍니다. 모바일 디바이스의 발달은 사용자가 생성하는 데이터가 폭발적으로 증가시켰습니다. 또한, 스토리지 기술의 발달은 기업이 이전에 생각지 못한 대량의 비즈니스 데이터를 축적할 수 있게 했습니다. 이와 더불어 클러스터 기술의 발달은 이런 대용량 데이터에 대한 실시간 처리 및 분석을 가능케 했습니다. 이제 모든 것이 데이터로 표현되고 저장되며 이런 데이터를 누가 얼마나 잘 관리하고 이로부터 얼마나 가치 있는 정보를 이끌어내는지가 비즈니스의 성패를 좌우하는 시대가 됐습니다.
이와 같은 빅데이터 시대에 HBase는 가장 주목 받는 오픈소스 NoSQL 데이터베이스입니다. HBase는 2006년 구글이 발표한 빅테이블(BigTable)이라는 논문에서 시작했습니다. 빅테이블은 빅데이터를 처리하기 위해 여러 상용 머신을 클러스터로 구축한 클러스터를 기반으로 동작합니다. 이런 빅테이블을 오픈소스로 구현한 구현체가 HBase입니다. HBase의 등장은 기존의 데이터베이스 패러다임을 RDBMS에서 NoSQL로 변화시킨 계기가 됐고, 그 이후로 많은 오픈소스 NoSQL 데이터베이스가 등장하게 된 시작점이 됐습니다.
이 책은 HBase를 실제로 운영하는 관리자나 HBase를 공부하려는 초심자 모두에게 매우 유용한 내용을 담고 있습니다. 저자는 자신이 근무하는 회사에서 실제로 대규모의 HBase 클러스터를 운영하고 있으며 이를 기반으로 운영되는 서비스를 관리하고 있습니다. 이 책은 이와 같은 저자의 다년간 경험을 바탕으로 HBase 운영에 가장 필요한 핵심 내용을 예제 형식으로 제공합니다.
이 책의 예제는 HBase 클러스터의 설치와 관리 방법에서 시작해 고급 튜닝 기법까지, HBase 클러스터를 운영하기 위한 전반적인 내용을 풍부하게 다룹니다. 시작은 초보자를 위해 실제 HBase 클러스터를 구축하기 위한 하둡(Hadoop) 클러스터 및 주키퍼(ZooKeeper) 등을 설치하고 이를 기반으로 HBase를 설치하는 방법을 쉽게 설명합니다. 이후에는 HBase 클러스터의 데이터 백업 및 복구, 모니터링과 같은 관리 방법을 다루며 클러스터 운영에 매우 중요한 보안 이슈도 다룹니다. 또한, 최적의 HBase 클러스터를 운영하기 위한 저자의 경험이 담긴 고급 튜닝 기법도 전수해줍니다. 이와 같은 내용은 모두 예제 형식으로 구성되어 초보자도 쉽게 실습하고 이해할 수 있으며, 예제마다 단계별 지시 사항뿐만 아니라 예제의 바탕에 깔린 핵심 원리도 자세히 설명하고 있습니다. 각 예제는 모두 HBase 관리자라면 꼭 알아야 할 핵심 내용을 다루고 있으며 예제를 실습하는 동안 자신도 모르는 사이에 HBase 전문가가 될 수 있다고 생각합니다. 이 책을 통해 빅데이터 시대의 데이터베이스 관리에 필수적인 저자의 오랜 실전 경험과 노하우를 전수받을 수 있을 것입니다.


