









출고예상일 안내
주문하신 상품이 한국에서 현지 배송을 위한 출고단계가 이루어질 것으로 예상되는 날짜입니다. 상품을 준비하는 과정에서 내부적인 사정으로 인해 출고예상일에 다소 오차가 생길 수 있습니다.
여러 상품(예약상품포함)을 함께 주문하신 경우 출고예상일이 가장 늦은 날짜에 맞춰 함께 배송됩니다.



- 정가
- $64.00
- 판매가
-
$46.66
(27%↓)

- 적립금
- $0.93 (2%P)
품절된 상품입니다.
이 책을 꼭 원하시는 고객님께서는 아래 "상품문의"를 클릭 후 구매의사를
알려주세요. 책이 확보 될 경우 연락 드리겠습니다.



평점 - · 리뷰 0
ISBN : 9788998139049 / 488쪽 188 x 240 (㎜)
이 상품에 궁금하신점이 있으세요? 1:1상담문의



아래의 도서와 구매하시면 이 도서들의 적립금을 즉시적용해 드립니다.
-

코리아교육그룹 교육연구소
-
칼릭스(손윤석)
-

서길원, 김운호, 허상훈, 박재상, 박경규, 김종욱, 오윤우, 유지영
-

거트루드(박태현)
- 19,800
- 19,800
- 31,500
- 23,400



출판사 리뷰
2013 대한민국학술원 우수학술도서 선정!
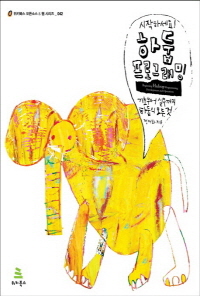
하둡으로 대용량 데이터를 처리하려는 자바 개발자들을 위한 실무형 입문서!
올해 IT분야의 화두로 빅 데이터가 부상하면서, 빅 데이터 처리를 위한 핵심 기술로 하둡이 주목받고 있다. 하둡은 구글의 논문을 바탕으로 더그 커팅이 개발한 대규모 데이터의 분산 처리를 위한 오픈소스 프레임워크로서, 초기에는 검색 엔진에서 사용하기 위한 기술로 개발됐지만, 지금은 전자 상거래, 포털, 게임, 학술 자료, 의료 정보 등 다양한 분야에서 사용되고 있다. 이 책은 하둡을 처음 시작하거나 이미 하둡을 사용해본 적이 있는 개발자를 대상으로 하며, 하둡의 기본 원리부터 실무 응용까지 초보자의 입장을 배려해서 친절하고 상세하게 설명한다.
★ 이 책에서 다루는 내용 ★
■ 리눅스, 윈도우, 아마존 웹 서비스(AWS) 환경에서의 하둡 설치
■ HDFS와 맵리듀스의 구조 및 활용
■ 맵리듀스 튜닝, 하둡 클러스터 운영
■ 하둡 스트리밍, 스케줄러 관리
■ 하둡 에코 시스템 하이브(HIVE) 활용
■ 국내 하둡 적용 사례 및 하둡 2.0 소개
.
[추천사]
\"빅데이터를 고민하는 많은 개발자와 회사에서 이 책을 통해 더욱 많은 도움을 받을 수 있기를 기대해봅니다.\"
- 권영길(그루터 대표이사)
\"빅데이터와 하둡에 관심은 있지만 어떻게 시작해야 할지 고민하셨던 개발자라면 더욱 이 책을 추천합니다.\"
- 김우승(줌인터넷㈜ 연구소장)
\"그동안 하둡을 사용하는 데 어려움을 겪었던 분들이나 도입을 검토하는 분들에게 무척 반가운 소식이 될 것입니다.\"
- 심탁길 (SK C&C 클라우드 컴퓨팅 기술팀 부장, 솔루션 개발 총괄)
\"이 책을 통해 많은 분들이 빅데이터는 어렵고 복잡하다는 오해를 떨쳐내고, 여러 상황에서 유의미한 결과를 분석해 내시길 기원합니다.\"
- 이경준(NHN 데이터정보센터 BI실 실장)
\"제대로 된 입문서로 배우는 것이 불필요한 시간 낭비를 줄이고 다음 단계로 빠르게 넘어가는 지름길이 될 수 있다는 점에서 이 책을 적극 추천합니다.\"
- 조동환(Liaison Architect between Business and Technology / 전)쿠팡 데이터연구소 소장)
\"이 책에는 하둡의 구성과 동작 원리도 잘 설명돼 있어서 개발 인생에 영감을 주고 활용할 수 있을 것 같습니다. 막연한 불안에 떨고 있는 분이라면 한번 시작해 보시길 권해드립니다.\"
- 조현종(오픈소스 올챙이(Tadpole for DB Tools) 개발자)
\"마지막 장에서 소개한 국내의 하둡 적용 사례는 실제 운영 환경에서 하둡이 어떻게 활용되고, 구조를 어떻게 잡아야 할지 안내해 줄 것이다.\"
- 한재선(KT Cloudware CTO 겸 NexR 대표이사)
\"데이터 세상의 하둡으로 첫 나들이를 나서는 자바 개발자를 위한 책이다.\"
- 황순현(엔씨소프트 전무, 웹모바일센터 센터장)

-
- 구분 : 저서
- 이름 : 정재화
- 국적 : 대한민국
- 직업 :
- 분류 : 과학/공학 저자 , 기타
- 인기지수 [198]
-


- [최근저서]전체보기
- 시작하세요! 하둡 프로그래밍...

▣ 01장_하둡 소개
1.1 빅 데이터의 시대
___1.1.1 빅 데이터의 개념
___1.1.2 빅 데이터의 출현 배경
1.2 하둡이란?
___1.2.1 왜 하둡인가?
___1.2.2 하둡이 지나온 길
1.3 하둡 에코 시스템
1.4 하둡에 대한 오해
1.5 하둡의 과제
1.6 하둡 배포판 살펴보기
▣ 02장_하둡 개발 준비
2.1 실행 모드 결정
2.2 리눅스 서버 준비
2.3 하둡 다운로드
2.4 하둡 실행 계정 생성
2.5 호스트 파일 수정하기
2.6 인코딩 방식 설정
2.7 자바 설치
2.8 SSH 설정
2.9 하둡 압축 파일 해제하기
2.10 하둡 환경설정 파일 수정
___2.10.1 hadoop-env 수정
___2.10.2 maters 수정
___2.10.3 slaves 수정
___2.10.4 core-site.xml 수정
___2.10.5 hdfs-site.xml 수정
___2.10.6 mapred-site.xml 수정
2.11 하둡 실행
2.12 예제 실행하기
2.13 이클립스 설정
2.14 프로젝트 빌드하기
▣ 03장_하둡 분산 파일 시스템
3.1 HDFS 기초
3.2 HDFS 아키텍처
___3.2.1 블록 구조 파일 시스템
___3.2.2 네임노드 와 데이터노드
___3.2.3 파일 저장
___3.2.4 파일 읽기
___3.2.5 보조 네임노드
3.3 HDFS 명령어 사용하기
___3.3.1 파일 목록 보기 - ls, lsr
___3.3.2 파일 용량 확인 - du, dus
___3.3.3 파일 내용 보기 - cat, text
___3.3.4 디렉터리 생성 - mkdir
___3.3.5 파일 복사 - put, get, getmerge, cp, copyFromLocal, copyToLocal
___3.3.6 파일 이동 - mv, moveFromLocal
___3.3.7 파일 삭제하기 - rm
___3.3.8 디렉터리 삭제 - rmr
___3.3.9 카운트값 조회 - count
___3.3.10 파일의 마지막 내용 확인 - tail
___3.3.11 권한 변경 - chmod, chown, chgrp
___3.3.12 0바이트 파일 생성 - touchz
___3.3.13 통계 정보 조회 - stat
___3.3.14 복제 데이터 개수 변경 - setrep
___3.3.15 휴지통 비우기 - expunge
___3.3.16 파일 형식 확인 - test
3.4 클러스터 웹 인터페이스
3.5 HDFS 입출력 예제
▣ 04장_MapReduce 시작하기
4.1 맵리듀스 개념
4.2 맵리듀스 아키텍처
___4.2.1 시스템 구성
___4.2.2 맵리듀스 작동 방식
___4.2.3 하둡 프로그래밍의 요소
4.3 WordCount 만들기
___4.3.1 매퍼 구현
___4.3.2 리듀서 구현
___4.3.3 드라이버 클래스 구현
___4.3.4 WordCount 빌드
___4.3.5 WordCount 실행
___4.3.6 웹에서 실행 결과 확인
▣ 05장_MapReduce 기초 다지기
5.1 분석용 데이터 준비
5.2 항공 출발 지연 데이터 분석
___5.2.1 매퍼 구현
___5.2.2 리듀서 구현
___5.2.3 드라이버 클래스 구현
___5.2.4 드라이버 클래스 실행
5.3 항공 도착 지연 데이터 분석
___5.3.1 매퍼 구현
___5.3.2 리듀서 구현
___5.3.3 드라이버 클래스 구현
___5.3.4 드라이버 클래스 실행
5.4 사용자 정의 옵션 사용
___5.4.1 사용자 정의 옵션의 이해
___5.4.2 매퍼 구현
___5.4.3 드라이버 클래스 구현
___5.4.4 드라이버 클래스 실행
5.5 카운터 사용
___5.5.1 사용자 정의 카운터 구현
___5.5.2 매퍼 구현
___5.5.3 드라이버 클래스 구현
___5.5.4 드라이버 클래스 실행
5.6 다수의 파일 출력
___5.6.1 MultipleOutputs 이해
___5.6.2 매퍼 구현
___5.6.3 리듀서 구현
___5.6.4 드라이버 클래스 구현
___5.6.5 드라이버 클래스 실행
5.7 체인(Chain)
▣ 06장_정렬 구현하기
6.1 보조 정렬
___6.1.1 복합키 구현
___6.1.2 복합키 비교기 구현
___6.1.3 그룹키 파티셔너 구현
___6.1.4 그룹키 비교기 구현
___6.1.5 매퍼 구현
___6.1.6 리듀서 구현
___6.1.7 드라이버 구현
___6.1.8 드라이버 실행
6.2 부분 정렬(Partial Sort)
___6.2.1 시퀀스파일 생성
___6.2.2 맵파일 생성
___6.2.3 검색 프로그램 구현
6.3 전체 정렬(Total Sort)
▣ 07장_조인 구현하기
7.1 조인 데이터 준비
7.2 맵-사이드 조인
___7.2.1 분산 캐시(DistributedCache)
___7.2.2 매퍼 구현
___7.2.3 드라이버 클래스 구현
___7.2.4 드라이버 클래스 실행
7.3 리듀스-사이드 조인
___7.3.1 항공기 코드 데이터 매퍼 구현
___7.3.2 항공기 운항 통계 데이터 매퍼 구현
___7.3.3 리듀서 구현
___7.3.4 드라이버 클래스 구현
▣ 08장_MapReduce 튜닝하기
8.1 셔플 튜닝
___8.1.1 셔플이란?
___8.1.2 정렬 속성 수정
8.2 콤바이너 클래스 적용
8.3 Map 출력 데이터 압축
___8.3.1 Gzip 적용
___8.3.2 스내피 설치
___8.3.3 스내피 적용
8.4 DFS 블록 사이즈 수정
8.5 JVM 재사용
8.6 투기적인 잡 실행
▣ 09장_하둡 운영하기
9.1 네임노드 HA 구성
___9.1.1 아바타 노드의 등장 배경
___9.1.2 아바타 노드의 작동 방식
9.2 파일 시스템 상태 확인
9.3 HDFS 어드민 명령어 사용
___9.3.1 report
___9.3.2 safemode
___9.3.3 saveNamespace
___9.3.4 파일 저장 개수 설정
___9.3.5 파일 저장 용량 설정
9.4 데이터 저장 공간 관리
9.5 데이터노드 제거
9.6 데이터노드 추가
9.7 네임노드 장애 복구
___9.7.1 네임노드와 보조 네임노드 데이터 구조
___9.7.2 보조 네임노드를 이용한 장애 복구
___9.7.3 NFS를 이용한 장애 복구
9.8 데이터노드 장애 복구
▣ 10장_하둡 부가기능 이용하기
10.1 하둡 스트리밍
___10.1.1 하둡 스트리밍의 동작 방식
___10.1.2 하둡 스트리밍 실행 옵션
___10.1.3 유닉스 명령어를 이용한 스트리밍 구현
___10.1.4 파이썬을 이용한 스트리밍 구현
___10.1.5 aggregate 패키지 이용
10.2 잡 스케줄러
___10.2.1 페어 스케줄러
___10.2.2 커패시티 스케줄러
▣ 11장_클라우드 환경에서 하둡 실행하기
11.1 아마존 웹 서비스(AWS) 소개
11.2 AWS 가입하기
11.3 EC2 하둡 설정
___11.3.1 EC2 인스턴스 생성
___11.3.2 EC2 접속하기
___11.3.3 SSH 인증키 복사
___11.3.4 방화벽 설정
___11.3.5 하둡 설치
11.4 S3 설정
___11.4.1 데이터 업로드
___11.4.2 EC2와의 연동
11.5 EMR 사용
___11.5.1 EMR 관리 콘솔 실행
___11.5.2 S3에 데이터 업로드하기
___11.5.3 작업 흐름 생성
___11.5.4 작업 흐름을 실행한 결과 확인
___11.5.5 출력 데이터 조회
▣ 12장_하이브 활용하기
12.1 하이브 아키텍처
12.2 하이브 설치 방법
12.3 하이브QL 사용하기
___12.3.1 테이블 생성
___12.3.2 데이터 업로드
___12.3.3 집계 함수
___12.3.4 조인
___12.3.5 버킷 활용
▣ 13장_하둡 적용 사례
13.1 NHN: 하둡과 몽고디비를 이용한 로그 분석 시스템
___13.1.1 스토리지의 급격한 증가
___13.1.2 통계 작업 솔루션 선정
___13.1.3 맵리듀스 프레임워크를 이용한 통계 작업
___13.1.4 통계 결과 저장소 선정
___13.1.5 최종 시스템 구성
13.2 넥스알: 하둡 생태계를 활용한 KT 분석 플랫폼 구축 사례
___13.2.1 NDAP 적용 배경
___13.2.2 NDAP 플랫폼 아키텍처
___13.2.3 성능 테스트 결과
13.3 그루터: 빅 데이터 기술을 이용한 소셜 네트워크 데이터 분석 서비스
___13.3.1 시스템 아키텍처
___13.3.2 제공 기능
▣ 부록A_윈도우 환경에서 설치하기
A.1 자바 설치
A.2 시그윈 설치
A.3 SSH 설정
A.4 하둡 압축 파일 풀기
A.5 하둡 환경설정 파일 수정
A.6 하둡 실행
A.7 예제 실행
▣ 부록B_하둡 2.0 소개
B.1 HDFS 페더레이션
___B.1.1 기존 HDFS의 문제점
___B.1.2 HDFS 페더레이션 아키텍처
___B.1.3 HDFS 페더레이션의 장점
___B.1.4 네임스페이스 관리
B.2 차세대 맵리듀스: YARN
___B.2.1 YARN 등장 배경
___B.2.2 YARN 시스템 아키텍처
___B.2.3 YARN의 장점
B.3 성능 개선
B.4 네임 노드의 HA 지원

